Governance dei costi cloud per i leader tecnologici e finanziari
Governance dei costi cloud per i leader tecnologici e finanziari La governance dei costi cloud è la pratica di allineare la spesa cloud al valore aziendale attraverso ruoli, policy e controlli definiti — e il passo successivo immediato per la maggior parte delle organizzazioni è eseguire una scansione di visibilità di 7 giorni che...
Governance dei costi cloud per i leader tecnologici e finanziari
La governance dei costi cloud è la pratica di allineare la spesa cloud al valore aziendale attraverso ruoli, policy e controlli definiti — e il passo successivo immediato per la maggior parte delle organizzazioni è eseguire una scansione di visibilità di 7 giorni che associ ogni voce della fattura cloud a un prodotto, un team o un centro di costo.
In breve — cosa troverai in questa guida:
-
Una definizione chiara che distingue la governance dall'ottimizzazione dei costi e dal FinOps
-
I sei pilastri della governance e il requisito minimo per ciascuno
-
Come funzionano i principali modelli di prezzo cloud e quali leve fanno davvero la differenza
-
Un framework di ruoli e policy con uno spettro di applicazione
-
Controlli operativi giornalieri e settimanali per prevenire la deriva della spesa
-
Un albero decisionale per la selezione degli strumenti (cloud-native rispetto alle piattaforme CCM)
-
KPI per i team di ingegneria e per il pubblico CFO/FP&A
-
Le trappole culturali che fanno fallire i programmi di governance prima che possano scalare
-
Un'implementazione di 90 giorni, settimana per settimana, con fasce stimate di impegno e costi
Indice
-
Cos'è realmente la governance dei costi cloud (e cosa non è)
-
I sei pilastri di cui ogni programma di governance ha bisogno
-
Come funzionano i modelli di prezzo cloud e quali leve fanno davvero la differenza
-
Creare il framework di governance: ruoli, policy e applicazione
-
Controlli operativi giornalieri e settimanali che prevengono la deriva della spesa
-
Quali metriche presentare ai team di ingegneria rispetto ai dirigenti
-
Dove falliscono i programmi di governance — e come FinOps risolve la cultura aziendale
-
L'implementazione in 90 giorni: traguardi settimana per settimana e fasce di impegno
Cos'è realmente la governance dei costi cloud (e cosa non è)
La governance dei costi cloud è il livello organizzativo che si colloca al di sopra dell'ottimizzazione dei costi. Definisce chi è responsabile della spesa cloud, quali policy la vincolano e come tali policy vengono applicate continuamente. L'ottimizzazione è un'azione di risparmio una tantum — ridimensionare una VM, eliminare un bucket orfano. La gestione è il livello di rendicontazione e allocazione — dashboard, fatture, report di showback. La governance è la struttura che rende entrambe queste attività ripetibili e assegnate a responsabili precisi.
Il Framework FinOpsdefinisce bene questo concetto: FinOps è un framework operativo che massimizza il valore aziendale della spesa cloud attraverso la collaborazione tra i team di ingegneria, finanza e business, secondo il principio che il valore aziendale guida le decisioni tecnologiche. La governance è il meccanismo che rende operativo tale principio.
Per le organizzazioni statunitensi, l'ambito pratico della governance comprende tre risultati sottoposti a controllo: rispetto del budget (la spesa non supera i limiti approvati senza una decisione deliberata), visibilità dei costi a livello di prodotto (ogni dollaro corrisponde a un elemento aziendale) e regole di approvvigionamento (gli acquisti di impegni seguono un flusso di approvazione). Ciò che la governance deve non diventare è una funzione di controllo esercitata dall'ingegneria. Nel momento in cui gli ingegneri percepiscono la governance come un ostacolo anziché come un abilitatore, il programma perde la titolarità distribuita da cui dipende.
Consiglio pratico: Scegli un ambito FinOps — un singolo prodotto, ambiente o centro di costo — per il tuo progetto pilota iniziale. Cercare di governare tutta la spesa cloud fin dal primo giorno è il modo in cui i programmi si bloccano. Un progetto pilota mirato produce evidenze che conquistano il consenso dell'organizzazione per un'implementazione più ampia.
I sei pilastri di cui ogni programma di governance ha bisogno
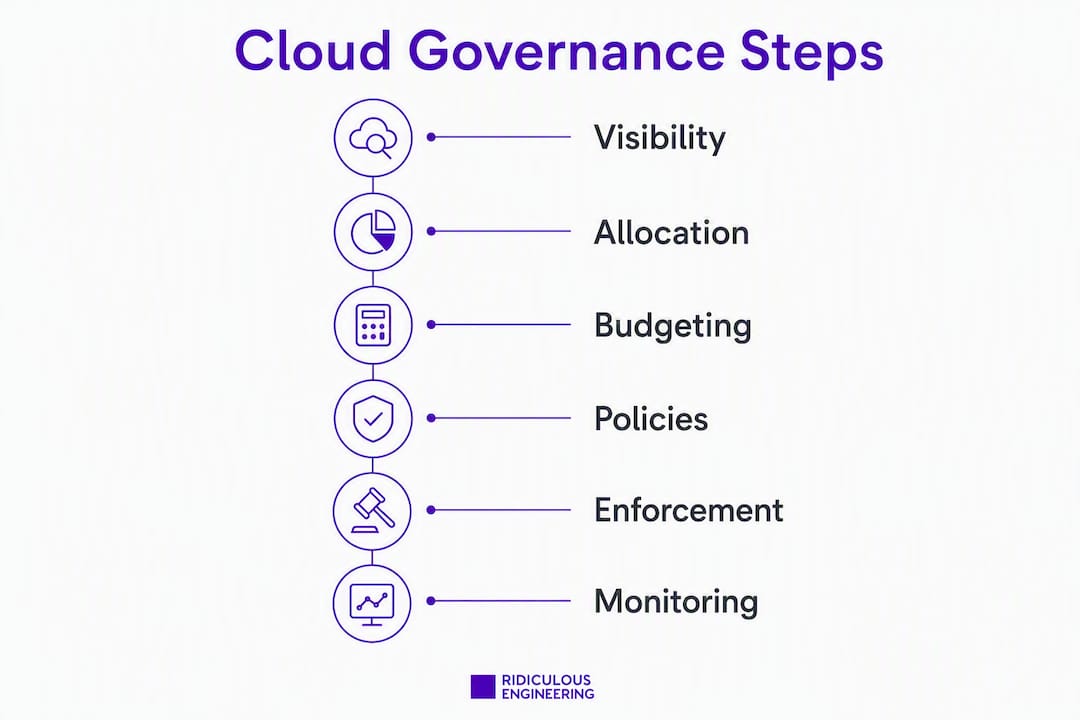
I programmi di governance destinati a durare si basano su sei pilastri. Ognuno ha un artefatto minimo — l'elemento che dimostra che il pilastro è effettivamente operativo, non solo documentato.
| Pilastro | Responsabile | Cadenza | Output minimo |
|---|---|---|---|
| Visibilità e tagging | Ingegneria della piattaforma | Giornaliera | Dashboard della spesa con tag, con meno del 5% senza tag |
| Allocazione / riaddebito | FinOps / Finanza | Mensile | Report di showback per prodotto e centro di costo |
| Budgeting e previsioni | FP&A + FinOps | Mensile / trimestrale | Oggetti di budget con avvisi sulle variazioni |
| Policy e applicazione | Responsabili FinOps + Ingegneria | Revisione trimestrale | Documento della policy scritta + registro delle applicazioni |
| Ottimizzazione e revisioni dell'architettura | Ingegneria / architetti | Mensile | Report sul rightsizing e sugli sprechi |
| Approvvigionamento e sconti | Approvvigionamento + FinOps | Trimestrale | Registro degli acquisti di impegni e tasso di utilizzo |
Visibilità e tagging sono la base. Senza di essi, ogni altro pilastro è frutto di congetture. Le best practice FinOps di GSA/ITVMO raccomandano di utilizzare gerarchie delle risorse organizzative — AWS Organizations, Azure Management Groups, cartelle GCP — come confine rigido dei costi, riservando i tag alla reportistica basata sui metadati. I tag si rompono. Le gerarchie no.
Allocazione e riaddebito trasformano i dati grezzi della fatturazione in un linguaggio aziendale. Un report di showback comunica a un team di prodotto quanto ha speso; un report di riaddebito trasferisce tale costo al suo budget. Inizia con lo showback — crea fiducia prima di chiedere ai team di farsi carico di una cifra.
Il budgeting e il forecasting chiudono il ciclo tra finanza e ingegneria. Gli oggetti di budget nella console di fatturazione del tuo provider cloud, combinati con avvisi di varianza all'80% e al 100% del budget, forniscono al team FP&A il segnale necessario senza richiedere una riconciliazione manuale mensile. Collegare tutto questo a pratiche di modellazione finanziaria agile rende il forecasting più reattivo ai modelli di utilizzo effettivi.
Consiglio pratico: Se la tua organizzazione è ancora nelle fasi iniziali della maturità cloud, dai innanzitutto priorità alla visibilità e all'allocazione. L'ottimizzazione degli acquisti (istanze riservate, piani di risparmio) offre i maggiori risparmi in termini assoluti, ma solo dopo aver compreso abbastanza bene i tuoi modelli di utilizzo di base da poter prendere impegni con sicurezza.
Come funzionano i modelli di prezzo del cloud e quali leve fanno la differenza
Un'indagine di settore ha rilevato che il 66% dei dirigenti ha dichiarato che la migrazione al cloud non ha ridotto il costo totale di possesso, e un terzo ha citato l'imprevedibilità dei costi, mentre il 31% ha indicato la complessità dei prezzi come principale ostacolo. Il modello di fatturazione variabile è davvero difficile da gestire senza un framework. Comprendere le strutture dei prezzi è il prerequisito.
| Modello di prezzo | Leva tipica sui costi | Compromesso aziendale |
|---|---|---|
| Pay-as-you-go (on demand) | Dimensionamento corretto, policy di autoscaling | Flessibilità totale; costo unitario più elevato |
| Istanze riservate / piani di risparmio | Impegni di 1 o 3 anni | Risparmio del 30% rispetto all'on demand; richiede fiducia nelle previsioni di utilizzo |
| Istanze Spot / preemptible | Carichi di lavoro batch tolleranti ai guasti | Costo più basso; rischio di interruzione |
| Uscita dei dati | Collocazione nella stessa regione, offload alla CDN | Risparmi significativi; richiede modifiche architetturali |
| Servizi gestiti | Selezione del livello corretto, policy del ciclo di vita | Sovrapprezzo per la comodità; spesso sovradimensionati |
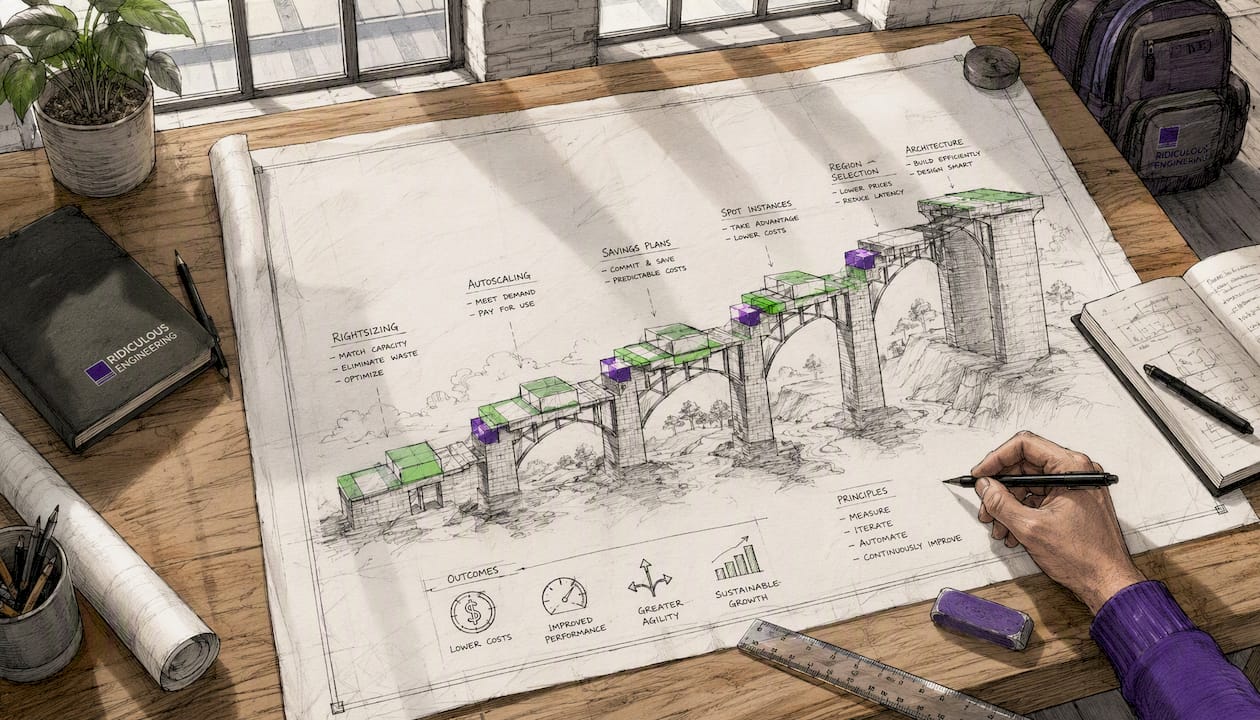
Le leve più affidabili, in ordine di rapporto tra impegno e risparmi, sono: dimensionamento corretto e autoscaling (basso impegno, risultati immediati), acquisto di istanze riservate e piani di risparmio (impegno medio, grandi risparmi), carichi di lavoro Spot per processi batch e attività CI/CD (impegno medio, risparmi elevati per i carichi di lavoro adatti) e ottimizzazione dell'uscita dei dati (impegno maggiore, ma i costi di uscita sono spesso la voce nascosta che sorprende i team).
La selezione della regione è più importante di quanto la maggior parte dei team immagini. Eseguire i carichi di lavoro in una regione con prezzi di elaborazione inferiori — mantenendo nel perimetro i requisiti di residenza dei dati — può ridurre i costi unitari senza alcuna modifica architetturale. In particolare per i carichi di lavoro di IA e GPU, vale la pena modellare esplicitamente questo compromesso, come discusso nel contesto di bilanciare costi e velocità nei carichi di lavoro di IA.
Consiglio pratico: Centralizza l'acquisto degli impegni (istanze riservate, piani di risparmio, sconti per utilizzo impegnato) in un'unica funzione FinOps o di procurement. L'acquisto decentralizzato degli impegni porta a sovrapposizioni e sottoutilizzo. Lascia ai team di prodotto le decisioni sulla spesa on demand; lascia al team centrale l'ottimizzazione delle tariffe.
Creare il framework di governance: ruoli, policy e applicazione
Un framework di governance senza responsabili nominati è un documento, non un programma. La tabella seguente associa i cinque ruoli fondamentali alle rispettive responsabilità principali.
| Ruolo | Responsabilità principale |
|---|---|
| FinOps centrale / Finanza cloud | Ottimizzazione delle tariffe, acquisto degli impegni, redazione delle policy, reporting |
| Responsabili di ingegneria / prodotto | Decisioni quotidiane sulla spesa, conformità dei tag, risposta alle anomalie |
| Approvvigionamento | Contratti con i fornitori, flussi di lavoro per l’approvazione degli impegni |
| Ingegneria della piattaforma | Policy IaC come codice, gerarchia degli account, strumenti |
| FP&A | Oggetti di budget, analisi degli scostamenti, integrazione delle previsioni |
I principi FinOps sono espliciti riguardo a questa struttura: una funzione FinOps centrale abilita le best practice, mentre gli ingegneri sono responsabili delle decisioni quotidiane sui costi. Centralizzare tutto crea un collo di bottiglia; decentralizzare tutto crea caos. La distinzione è tra ottimizzazione delle tariffe (centrale) e decisioni sull’utilizzo (distribuite).
Tipi di policy necessari al programma fin dal primo giorno:
-
Policy di tagging — tag obbligatori (prodotto, ambiente, team, centro di costo) con applicazione tramite linting IaC o motori di policy cloud
-
Policy della gerarchia degli account — quali account/sottoscrizioni corrispondono a quali strutture aziendali
-
Gestione di budget e violazioni del budget — chi viene avvisato all’80% e chi approva lo sforamento al 100%
-
Guardrail sui costi CI/CD — stima dei costi nelle pull request per le modifiche all’infrastruttura
-
Regole di approvvigionamento — flusso di approvazione per qualsiasi acquisto di impegni superiore a una soglia definita
-
Flussi di lavoro per l’approvazione — chi può effettuare il provisioning di risorse di livello production senza una richiesta di modifica
Spettro dell’applicazione: Gli avvisi sono l’impostazione predefinita per production. Le approvazioni si applicano al provisioning di nuove risorse oltre una soglia di costo. I guardrail flessibili (limiti di budget che inviano notifiche ma non terminano le risorse) si applicano a dev/test. I blocchi rigidi — la terminazione automatica — sono appropriati solo per le risorse non di produzione che superano una soglia di inattività definita, e solo dopo aver integrato nel flusso di lavoro una conferma umana. Usage.ai Le linee guida di governance sono chiare: richiedere una conferma prima di qualsiasi azione automatica sui servizi critici impedisce le interruzioni operative che i blocchi rigidi causano regolarmente.
Consiglio pratico: Scrivi la tua prima policy di tagging come pull request nel repository IaC, non come pagina wiki. Una policy che risiede nel codice viene revisionata, versionata e applicata. Una policy che risiede in una wiki viene ignorata.
Controlli operativi giornalieri e settimanali che prevengono le derive della spesa
La policy di governance è il progetto di riferimento. I controlli operativi sono ciò che mantiene effettivamente i costi sotto controllo settimana dopo settimana. I controlli seguenti rappresentano il ritmo minimo praticabile per un team che ha completato la fase pilota.
Controlli giornalieri:
-
Avvisi automatici sulle anomalie configurati per attivarsi quando la spesa supera di una soglia definita la media mobile degli ultimi 7 giorni, con inoltro a Slack o a un canale webhook
-
Ricerca delle risorse orfane — identificazione automatica di volumi non collegati, bilanciatori di carico inutilizzati e indirizzi IP riservati inattivi
-
Report di conformità dei tag — percentuale della spesa coperta dai tag obbligatori, con variazione giornaliera
Controlli settimanali:
-
Revisione del rightsizing: recuperare i suggerimenti del provider cloud sul dimensionamento corretto e analizzarli con il team di engineering interessato
-
Revisione dell’utilizzo delle istanze riservate: verificare che l’utilizzo degli impegni rimanga sopra la soglia obiettivo (in genere almeno l’80%)
-
Audit del ciclo di vita dello storage: identificare bucket o blob a cui non è stata applicata alcuna policy del ciclo di vita
-
Controllo dei costi della pipeline CI/CD: esaminare le stime dei costi dell’infrastruttura relative ai deployment della settimana precedente
Playbook di risposta alle anomalie:
-
L’avviso viene attivato nel canale Slack/webhook
-
L’ingegnere reperibile prende in carico l’avviso entro uno SLA definito (ad esempio, 2 ore durante l’orario lavorativo)
-
Triage: identificare la risorsa, il team e la causa principale
-
Mitigazione: ridurre la capacità, terminare la risorsa o coinvolgere il responsabile della risorsa
-
Postmortem: documentare la causa principale e aggiornare la policy o l’IaC per prevenire il ripetersi dell’evento
Le indicazioni operative dei professionisti del settore lo descrivono bene: il rilevamento automatico delle anomalie riduce il tempo medio di risoluzione da mesi a ore quando viene integrato come segnale in tempo reale nei flussi di lavoro CI/CD e operativi, invece di essere presentato in un report mensile di fatturazione.
Consiglio pratico: I limiti flessibili con conferma umana superano i blocchi rigidi nei sistemi di produzione. Automatizza le azioni sicure — terminare le istanze dev inattive, archiviare lo storage freddo — e richiedi l’approvazione umana per qualsiasi operazione che potrebbe influire su un servizio rivolto ai clienti.
Quali strumenti dovresti usare per la gestione dei costi cloud?
La risposta sugli strumenti più adatti dipende dalla tua presenza sul cloud, dal volume della spesa e dalla capacità ingegneristica interna. La decisione non riguarda quale fornitore scegliere — riguarda quale livello di funzionalità ti serve effettivamente.
| Funzionalità | Strumenti di fatturazione cloud-native | Automazione della piattaforma (IaC/policy-as-code) | Piattaforme CCM |
|---|---|---|---|
| Visibilità della spesa | Di base (un singolo cloud) | Nessuna | Multi-cloud, unificata |
| Rilevamento delle anomalie | Limitato | Nessuno | Avanzato, basato sul machine learning |
| Pianificazione delle prenotazioni | Specifico del provider | Nessuna | Ottimizzazione cross-cloud |
| Applicazione dei tag | Manuale o tramite motore di policy | Solida (OPA, Sentinel) | Solo reportistica |
| Showback / chargeback | Di base | Nessuno | Completo |
| Azioni di automazione | Limitate | Solide | Varia a seconda della piattaforma |
Gli strumenti cloud-native — AWS Cost Explorer, Azure Cost Management, GCP Billing — sono il punto di partenza giusto per le organizzazioni che utilizzano un singolo cloud e hanno una fatturazione semplice. Sono gratuiti, accurati e sufficienti per la fase pilota. Il limite è che non aggregano i dati tra i cloud e il loro rilevamento delle anomalie è basilare.
L'automazione della piattaforma tramite motori di policy per l'Infrastructure as Code (Open Policy Agent, HashiCorp Sentinel, AWS Service Control Policies) gestisce l'applicazione dei tag e le protezioni per il provisioning. È qui che si realizza la governance guidata dall'ingegneria. Richiede disciplina nell'IaC, ma produce policy solide, versionate e soggette a controllo delle versioni.
Le piattaforme CCM aggiungono aggregazione multi-cloud, rilevamento delle anomalie basato sul machine learning, raccomandazioni per l'ottimizzazione delle prenotazioni e automazione dello showback/chargeback. Sono adatte quando operi su due o più cloud, quando la spesa cloud mensile giustifica il costo dell'abbonamento o quando il tuo team interno non ha la capacità di creare report personalizzati. Il framework decisionale build vs. buy si applica direttamente in questo caso: se la funzionalità non è un elemento distintivo e una piattaforma la offre in modo affidabile, acquistala.
Consiglio dell'esperto: Configura il rilevamento delle anomalie come primo investimento nell'automazione, prima dei dashboard e prima del chargeback. Un avviso Slack che scatta entro pochi minuti da un picco dei costi vale più di un bellissimo report mensile. Collegalo a un webhook, richiedi una conferma e avrai un ciclo di feedback rapido che modifica il comportamento degli ingegneri nel giro di poche settimane.
Quali metriche presentare agli ingegneri e quali ai dirigenti
L’errore più comune che commettono i team è creare un’unica dashboard e presentarla a tutti. L’ingegneria ha bisogno di segnali granulari e quasi in tempo reale. I dirigenti hanno bisogno di riepiloghi in linguaggio aziendale con cadenza mensile. Le metriche sono diverse e anche le dashboard dovrebbero esserlo.
Metriche per i team di ingegneria e i responsabili di prodotto:
-
Costo per risorsa (VM, container, database) al giorno
-
Costo per distribuzione (variazione dell’infrastruttura derivante dalle esecuzioni CI/CD)
-
Tasso di anomalie (numero di avvisi attivati rispetto a quelli risolti ogni settimana)
-
Percentuale di spesa non contrassegnata (obiettivo: <5%)
-
Tasso di utilizzo delle prenotazioni (obiettivo: 80%+)
Metriche per dirigenti e FP&A:
-
Spesa cloud totale per prodotto, mese su mese
-
Scostamento tra previsione e budget (mese corrente e ultimi 90 giorni mobili)
-
Composizione della spesa impegnata rispetto a quella on demand
-
Economia unitaria: costo per cliente, costo per transazione, costo per chiamata API
-
Sprechi come percentuale della spesa totale
Il FinOps Framework sottolinea che i dati devono essere tempestivi, accurati e accessibili per consentire decisioni rapide. Una dashboard che si aggiorna settimanalmente non è abbastanza tempestiva per l’ingegneria. Una dashboard che mostra i costi per risorsa non è utile a un CFO. Collegare pipeline di dati in tempo reale all’esportazione dei dati di fatturazione è ciò che rende la dashboard ingegneristica realmente operativa anziché retrospettiva.
Migliorare la qualità della rendicontazione finanziaria della spesa cloud — strutturandola in modo che risponda alle domande che i team finanziari pongono davvero — è una disciplina a sé stante, e framework per migliorare la rendicontazione finanziaria offrono una struttura utile per il livello di governance rivolto a FP&A.
Consiglio pratico: Combina le metriche di utilizzo con quelle dei costi per produrre l’economia unitaria. Costo per cliente = spesa cloud totale / clienti attivi. Monitoralo mensilmente. Quando aumenta, hai un punto di partenza per una conversazione. Quando diminuisce, hai un risultato positivo da condividere con l’azienda.
Dove falliscono i programmi di governance — e come FinOps cambia la cultura
La maggior parte dei fallimenti nella governance dei costi cloud non è di natura tecnica. È organizzativa. Gli schemi si ripetono in modo prevedibile.
Problemi comuni:
-
Trattare la governance come attività di controllo. Quando gli ingegneri vivono la governance dei costi come un audit di conformità anziché come un servizio abilitante, la aggirano. Le policy vengono ignorate, i tag vengono falsificati e il programma perde credibilità.
-
Affidarsi esclusivamente ai tag per l’allocazione. I tag sono fragili. Gli ingegneri li dimenticano, li rinominano o li applicano in modo incoerente. Senza la gerarchia di account/sottoscrizioni come confine rigido, i report di allocazione diventano inaffidabili.
-
Pulizie una tantum invece di processi continui. Uno “sprint di pulizia del cloud” trimestrale non è governance. È la prova che la governance non esiste. I controlli operativi continui eliminano la necessità di sprint di pulizia.
-
Blocchi rigidi in produzione. La terminazione automatizzata delle risorse di produzione basata su soglie di costo causa incidenti. Il costo dell’incidente supera quello della spesa eccessiva.
-
Ignorare i cicli di feedback della governance. Le policy scritte una volta e mai riesaminate diventano obsolete. Una policy di tagging scritta per un’app web a tre livelli non copre i carichi di lavoro Kubernetes o le funzioni serverless senza una revisione.
Il modello culturale FinOps affronta direttamente questi problemi. I principi FinOps spingono la responsabilità verso il livello operativo: gli ingegneri sono responsabili delle decisioni sull’utilizzo, mentre la funzione FinOps centrale è responsabile dell’ottimizzazione delle tariffe e dell’abilitazione. Non è una funzione esclusivamente finanziaria né esclusivamente ingegneristica. Le linee guida del progetto pilota GSA/ITVMO raccomandano un piccolo gruppo direttivo interfunzionale che aggiorni iterativamente le policy là dove è più importante, anziché imporre un mandato dall’alto. Integrare l’autonomia del team di ingegneria nel modello di governance è ciò che rende concretamente efficace la responsabilità distribuita.
Consiglio pratico: Avvia la governance come servizio abilitante, non come funzione di controllo. La prima cosa che il team FinOps dovrebbe fare è offrire ai team di ingegneria una visibilità migliore sui propri costi — nessuna policy, nessuna imposizione, solo dati. I team che possono vedere i propri costi quasi sempre vogliono ridurli.
Il piano di implementazione di 90 giorni: traguardi settimana per settimana e fasce di impegno
Le indicazioni GSA/ITVMO convalidano l’approccio iterativo: i progetti pilota governativi e industriali che hanno adottato implementazioni FinOps incrementali — iniziando dalla visibilità, passando poi all’allocazione e infine all’ottimizzazione — hanno ottenuto risultati migliori rispetto alle implementazioni immediate e su larga scala sia in termini di adozione sia di risparmi duraturi. Il piano di 90 giorni riportato di seguito segue questo modello.
| Fase | Settimane | Traguardi | Responsabile | Criteri di accettazione |
|---|---|---|---|---|
| Analisi preliminare | 1–2 | Esportazione della fatturazione cloud configurata; gerarchia degli account mappata; interviste agli stakeholder completate | Ingegneria della piattaforma + FinOps | Il 100% della spesa è visibile in un’unica interfaccia |
| Progetto pilota di visibilità | 3–4 | Policy di tagging redatta e inserita in IaC; avvisi di anomalie attivi; primo report di showback | Ingegneria della piattaforma + FinOps | Spesa non contrassegnata ridotta; primo avviso riconosciuto |
| Allocazione | 5–8 | Report di showback per i 3 prodotti principali; oggetti di budget creati; FP&A integrata | FinOps + FP&A | Avvisi di scostamento dal budget funzionanti e coinvolgimento di FP&A confermato |
| Ottimizzazione | — | Raccomandazioni di rightsizing sottoposte a valutazione; primi acquisti di prenotazioni approvati | FinOps + Approvvigionamento | Utilizzo delle prenotazioni superiore alla soglia obiettivo, a indicare un utilizzo efficace |
| Integrazione nelle operazioni | — | Cadenza operativa documentata; runbook pubblicati; conformità al tagging >95% | Tutti i responsabili | Cadenza di revisione settimanale attiva senza sollecitazioni |
Checklist dei giorni 1–30:
-
Configurare l’esportazione della fatturazione verso un archivio dati centrale (BigQuery, S3 o Azure Storage)
-
Mappare la gerarchia di account/sottoscrizioni ai modelli aziendali
-
Redigere la policy di tagging come pull request IaC
-
Attivare gli avvisi di anomalie con instradamento verso Slack/webhook
-
Produrre il primo report di showback per il prodotto con la spesa più elevata
Checklist dei giorni 31–60:
-
Estendere lo showback ai tre prodotti principali
-
Creare oggetti di budget con avvisi all’80% e al 100%
-
Integra i dati sulla spesa cloud con le previsioni FP&A
-
Classifica le raccomandazioni di right-sizing del provider cloud
-
Esegui la prima revisione dell'utilizzo delle prenotazioni
Checklist dei giorni 61–90:
-
Esegui il primo acquisto centralizzato di una prenotazione o di un piano di risparmio
-
Pubblica runbook operativi per la risposta alle anomalie
-
Raggiungi una conformità dei tag superiore al 95%
-
Fornisci il primo report esecutivo sui costi in un linguaggio aziendale
-
Pianifica la revisione trimestrale delle policy
Fasce di stima di impegno e costi:
-
Ore FTE interne: 80–160 ore complessive tra platform engineering, FinOps e FP&A per il pilota di 90 giorni
-
Strumenti cloud-native: 0 $ (inclusi negli account del provider cloud)
-
Abbonamento alla piattaforma CCM: 500–5.000 $/mese a seconda del volume di spesa e del livello della piattaforma
-
Incarico di consulenza opzionale: varia in base all'ambito; un incarico mirato di analisi e pilota dura tipicamente 4–8 settimane
Consiglio pratico: Il pilota è pronto per scalare quando sono soddisfatte tre condizioni: la conformità dei tag supera il 95%, almeno un team di prodotto sta esaminando il proprio report showback senza che gli venga chiesto e l'avviso di anomalia è scattato ed è stato risolto almeno una volta. Questi tre segnali indicano che il programma ha acquisito consenso nell'organizzazione, non solo un'infrastruttura tecnica.
Cosa fare nei prossimi 30, 90 e 180 giorni
I programmi di governance si arenano quando i leader lasciano una sessione di pianificazione senza un'azione successiva specifica. L'elenco seguente è prioritizzato in base all'impatto e organizzato in sequenza per costruire ogni fase sulla precedente.
Immediato (prossimi 7–30 giorni):
-
Esegui una scansione della visibilità di 7 giorni: configura l'esportazione della fatturazione e identifica i cinque principali fattori di costo per prodotto o team. Metrica di successo: il 100% della spesa è associato a un elemento aziendale.
-
Redigi la policy di tagging come PR IaC. Responsabile: lead del platform engineering.
-
Attiva gli avvisi di anomalia. Responsabile: platform engineering. Metrica di successo: il primo avviso viene preso in carico entro 2 ore.
Breve termine (30–90 giorni):
-
Fornisci report showback per i tre prodotti principali. Responsabile: FinOps/Finance. Metrica di successo: i product owner esaminano mensilmente i propri report.
-
Riduci la spesa senza tag a meno del 5%. Responsabili: ingegneria della piattaforma e FinOps. Metrica di successo: dashboard giornaliera della conformità dei tag che mostri <5%.
-
Crea gli oggetti di budget e integrali con FP&A. Responsabile: FP&A + FinOps. Metrica di successo: gli avvisi di varianza scattano prima delle sorprese di fine mese.
Medio termine (90–180 giorni):
-
Esegui il primo acquisto centralizzato di una prenotazione. Responsabile: procurement + FinOps. Metrica di successo: utilizzo della prenotazione superiore all'80%.
-
Pubblica l'economia unitaria (costo per cliente o costo per transazione) per i due prodotti principali. Responsabile: FinOps + engineering. Metrica di successo: la metrica viene monitorata mensilmente e analizzata nella pianificazione del prodotto.
-
Conduci la prima revisione trimestrale delle policy. Responsabile: gruppo direttivo FinOps. Metrica di successo: almeno una policy viene aggiornata sulla base del feedback operativo.
Quando il programma raggiunge il traguardo dei 90 giorni e la cadenza operativa procede senza sollecitazioni, è il momento giusto per valutare se un supporto esterno possa accelerare le fasi di ottimizzazione e di economia unitaria. Un incarico mirato in questa fase produce risparmi più rapidamente rispetto a uno all'inizio, perché i dati e il contesto organizzativo sono già disponibili.
Punti chiave
Una governance efficace dei costi cloud richiede visibilità, responsabilità distribuita e controlli operativi continui — non una pulizia una tantum né una funzione di controllo affidata esclusivamente alla finanza.
| Punto | Dettagli |
|---|---|
| Governance e ottimizzazione | La governance è la struttura (ruoli, policy e controlli) che rende l'ottimizzazione dei costi ripetibile e assegna responsabilità precise. |
| Gerarchia prima dei tag | Usa le gerarchie di account/abbonamento come confini rigidi dei costi; riserva i tag ai metadati e alla reportistica. |
| Implementazione iterativa | Inizia dalla visibilità e dall'allocazione, poi ottimizza gli acquisti — le implementazioni big bang hanno costantemente risultati inferiori. |
| Prima i controlli soft | Invia avvisi e richiedi il riconoscimento umano per i sistemi di produzione; automatizza i blocchi rigidi solo per le risorse inattive non di produzione. |
| Ridiculous Engineering | Ridiculous Engineering offre incarichi pilota di 90 giorni che forniscono come risultati concreti una dashboard dei costi, una policy di tagging e un playbook di ottimizzazione prioritizzato. |
Ridiculous Engineering può aiutarti a costruire questo
La governance dei costi cloud è un problema ingegneristico e organizzativo, non solo finanziario. Ridiculous Engineering collabora con i responsabili della tecnologia e della finanza per progettare e implementare programmi di governance che producano risultati misurabili: visibilità dei costi a livello di prodotto, conformità al tagging superiore al 95% ed economia unitaria che colleghi la spesa cloud al valore aziendale.
Le due forme di incarico più comuni sono un progetto pilota di 90 giorni (dalla fase di scoperta all'integrazione operativa, con una dashboard dei costi e un playbook prioritizzato come risultati) e una fase più breve di scoperta e valutazione (2–4 settimane, con produzione di un'analisi dello stato attuale, un report sulle lacune di governance e una roadmap prioritizzata). Entrambi gli incarichi includono una definizione trasparente dell'ambito, risultati fissi e un passaggio di consegne chiaro, affinché il tuo team possa gestire il programma dopo la conclusione dell'incarico.
Se sei un responsabile della tecnologia o della finanza e hai bisogno di un framework pratico di governance anziché della presentazione commerciale di un fornitore, avvia una conversazione con Ridiculous Engineering. La prima chiamata è una sessione di lavoro, non una chiamata commerciale.
Fonti utili
-
Panoramica del framework della FinOps Foundation — Il riferimento principale per i principi FinOps, gli ambiti e il modello culturale della responsabilità distribuita. Inizia da qui per le basi concettuali.
-
Principi della FinOps Foundation — I principi specifici che regolano l'abilitazione centralizzata e la titolarità distribuita; essenziali per progettare il modello dei ruoli.
-
Buone pratiche FinOps di GSA / ITVMO — Linee guida convalidate dal governo su progetti pilota FinOps iterativi, governance del tagging e gerarchia organizzativa. Direttamente applicabili ai programmi federali e aziendali statunitensi.
-
Microsoft Cloud Adoption Framework: gestione dei costi cloud — Linee guida specifiche per Azure su come mappare l'ambito della governance sui costrutti aziendali e condurre revisioni periodiche.
-
BizTech Magazine: come controllare la spesa cloud — Dati di un'indagine di settore sull'imprevedibilità dei costi e sulla complessità dei prezzi come principali ostacoli alla realizzazione del TCO cloud.
-
Ridiculous Engineering: guida all'ottimizzazione dei costi Kubernetes — Tattiche di riduzione dei costi specifiche per piattaforme con carichi di lavoro containerizzati; lettura consigliata per i team che utilizzano Kubernetes.
-
Ridiculous Engineering: guida alla strategia di migrazione cloud — Linee guida per la pianificazione delle fasi di migrazione e la previsione dei costi; pertinenti alla fase di scoperta del rollout di 90 giorni.
Domande frequenti
Che cos'è la governance dei costi cloud?
La governance dei costi cloud è l'insieme di ruoli, policy e controlli che allineano continuamente la spesa cloud al valore aziendale. Si differenzia dall'ottimizzazione dei costi (azioni di risparmio una tantum) e dalla gestione dei costi (reporting e allocazione) perché fornisce la struttura organizzativa che rende entrambe ripetibili.
Che cos'è la gestione dei costi nel cloud?
La gestione dei costi cloud comprende il reporting, l'allocazione e il monitoraggio della spesa cloud — dashboard, report showback, avvisi di budget e riconciliazione delle fatture. La governance è il livello superiore che definisce chi è responsabile e quali policy limitano le decisioni di spesa.
Che cos'è la governance del cloud computing?
La governance del cloud computing è il framework più ampio di policy, controlli e strutture di responsabilità che copre sicurezza, conformità, costi e standard operativi per gli ambienti cloud. La governance dei costi cloud è un ambito specifico all'interno di questo framework più ampio, focalizzato sulla responsabilità finanziaria e sull'allineamento della spesa.
Qual è la migliore strategia cloud per l'ottimizzazione dei costi?
L'approccio più efficace combina un rollout FinOps iterativo — iniziando dalla visibilità e dall'allocazione, per poi passare all'ottimizzazione degli acquisti — con la titolarità distribuita, in cui gli ingegneri gestiscono le decisioni sull'utilizzo e una funzione FinOps centrale gestisce l'ottimizzazione delle tariffe e degli impegni. L'adesione a istanze riservate o a piani di risparmio dopo aver stabilito una baseline di utilizzo offre in genere i maggiori risparmi sostenibili.