Cloud-Kosten-Governance für Technologie- und Finanzführungskräfte
Cloud-Kosten-Governance für Technologie- und Finanzführungskräfte Cloud-Kosten-Governance ist die Praxis, Cloud-Ausgaben durch klar definierte Rollen, Richtlinien und Kontrollen am Geschäftswert auszurichten — und der unmittelbar nächste Schritt für die meisten Organisationen besteht darin, einen 7-tägigen Transparenz-Scan durchzuführen, der ...
Cloud-Kosten-Governance für Technologie- und Finanzführungskräfte
Cloud-Kosten-Governance ist die Praxis, Cloud-Ausgaben durch klar definierte Rollen, Richtlinien und Kontrollen am Geschäftswert auszurichten — und der unmittelbar nächste Schritt für die meisten Organisationen besteht darin, einen 7-tägigen Transparenz-Scan durchzuführen, der jede Position einer Cloud-Rechnung einem Produkt, Team oder Kostenstellenkonto zuordnet.
Kurzfassung — das erwartet Sie in diesem Leitfaden:
-
Eine klare Definition, die Governance von Kostenoptimierung und FinOps abgrenzt
-
Die sechs Governance-Säulen und das jeweils erforderliche Mindestartefakt
-
Wie die wichtigsten Cloud-Preismodelle funktionieren und welche Stellschrauben tatsächlich etwas bewirken
-
Ein Rollen- und Richtlinien-Framework mit einem Durchsetzungsspektrum
-
Tägliche und wöchentliche operative Kontrollen, um Kostenabweichungen zu verhindern
-
Ein Entscheidungsbaum zur Toolauswahl (cloudnativ vs. CCM-Plattformen)
-
KPIs für Engineering-Teams sowie für CFO-/FP&A-Zielgruppen
-
Die kulturellen Fallstricke, die Governance-Programme vor ihrer Skalierung zum Scheitern bringen
-
Eine 90-tägige Einführung nach Wochen mit Aufwandsschätzungen und Kostenspannen
Inhaltsverzeichnis
-
Was Cloud-Kosten-Governance tatsächlich ist (und was sie nicht ist)
-
Wie Cloud-Preismodelle funktionieren und welche Stellschrauben wirklich etwas bewirken
-
Das Governance-Framework aufbauen: Rollen, Richtlinien und Durchsetzung
-
Tägliche und wöchentliche operative Kontrollen, die eine Kostenabweichung verhindern
-
Welche Tools sollten Sie für das Cloud-Kostenmanagement verwenden?
-
Welche Kennzahlen Sie Technikteams im Vergleich zu Führungskräften präsentieren sollten
-
Wo Governance-Programme scheitern — und wie FinOps die Unternehmenskultur verbessert
-
Die 90-Tage-Einführung: Meilensteine und Aufwandsstufen nach Wochen
Was Cloud-Kosten-Governance tatsächlich ist (und was sie nicht ist)
Cloud-Kosten-Governance ist die organisatorische Ebene oberhalb der Kostenoptimierung. Sie legt fest, wer für die Cloud-Ausgaben verantwortlich ist, welche Richtlinien sie begrenzen und wie diese Richtlinien kontinuierlich durchgesetzt werden. Optimierung ist eine einmalige Einsparmaßnahme — etwa die Anpassung der Größe einer VM oder das Löschen eines verwaisten Buckets. Management ist die Berichts- und Zuordnungsebene — Dashboards, Rechnungen und Showback-Berichte. Governance ist die Struktur, die beide Aktivitäten wiederholbar macht und klare Verantwortlichkeiten schafft.
Das FinOps-Framework definiert dies treffend: FinOps ist ein operatives Rahmenwerk, das den Geschäftswert von Cloud-Ausgaben durch die Zusammenarbeit von Engineering-, Finanz- und Geschäftsteams maximiert, nach dem Grundsatz, dass der Geschäftswert Technologieentscheidungen bestimmt. Governance ist der Mechanismus, der diesen Grundsatz operationalisiert.
Für Organisationen in den USA umfasst der praktische Anwendungsbereich der Governance drei gesteuerte Ergebnisse: Budgeteinhaltung (Ausgaben überschreiten genehmigte Grenzen nicht ohne eine bewusste Entscheidung), Kostentransparenz auf Produktebene (jeder Dollar lässt sich einem Geschäftskonstrukt zuordnen) und Beschaffungsregeln (der Kauf von Verpflichtungen folgt einem Genehmigungsworkflow). Governance darf nicht zu einer Kontrollfunktion für das Engineering werden. Sobald Engineers Governance eher als Hindernis denn als Unterstützung wahrnehmen, verliert das Programm die verteilte Verantwortung, auf die es angewiesen ist.
Profi-Tipp: Wählen Sie für Ihren ersten Pilotversuch einen einzigen FinOps-Bereich — ein einzelnes Produkt, eine Umgebung oder eine Kostenstelle. Der Versuch, am ersten Tag sämtliche Cloud-Ausgaben zu steuern, führt dazu, dass Programme ins Stocken geraten. Ein fokussierter Pilot liefert Belege, die organisatorische Unterstützung für die umfassendere Einführung schaffen.
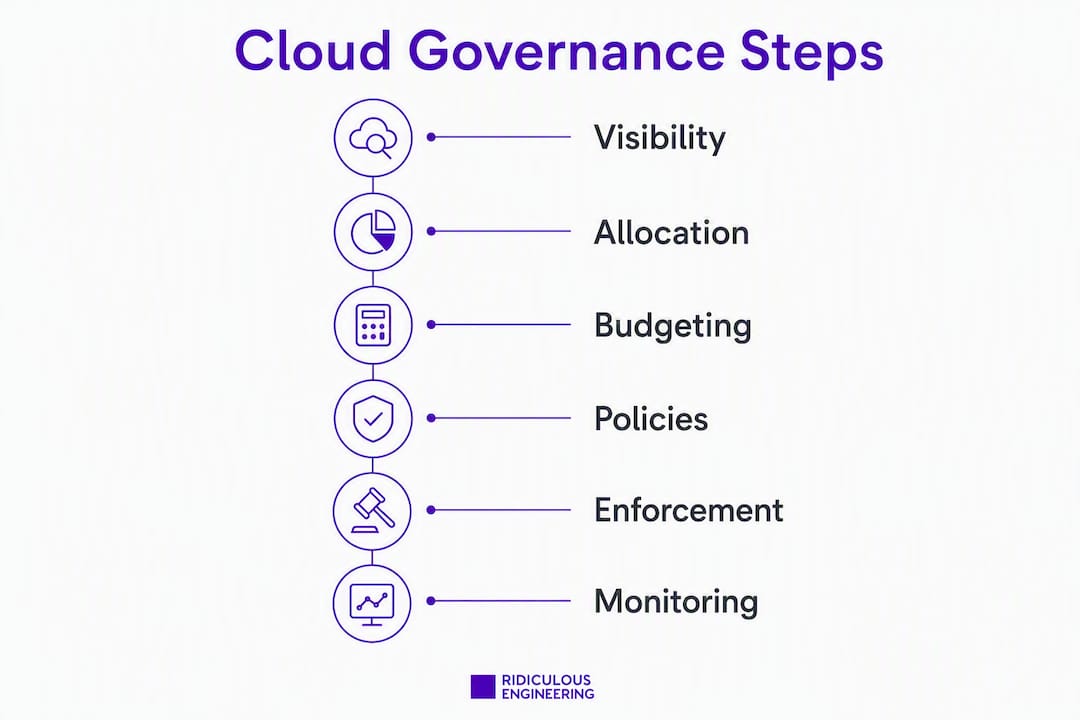
Die sechs Säulen, die jedes Governance-Programm benötigt
Nachhaltige Governance-Programme basieren auf sechs Säulen. Für jede gibt es ein Mindestartefakt — den Nachweis, dass die Säule tatsächlich umgesetzt wird und nicht nur dokumentiert ist.
| Säule | Verantwortlicher | Taktung | Mindestausgabe |
|---|---|---|---|
| Transparenz & Tagging | Plattform-Engineering | Täglich | Dashboard für getaggte Ausgaben mit <5 % ohne Tag |
| Kostenverteilung / Chargeback | FinOps / Finanzen | Monatlich | Showback-Bericht nach Produkt und Kostenstelle |
| Budgetierung & Prognosen | FP&A + FinOps | Monatlich / quartalsweise | Budgetobjekte mit Abweichungswarnungen |
| Richtlinien & Durchsetzung | FinOps + Engineering-Leads | Vierteljährliche Überprüfung | Schriftliche Richtliniendokumentation + Durchsetzungsprotokoll |
| Optimierungs- & Architekturprüfungen | Engineering / Architekten | Monatlich | Bericht zu bedarfsgerechter Dimensionierung und Verschwendung |
| Beschaffung & Rabatte | Beschaffung + FinOps | Vierteljährlich | Protokoll der Verpflichtungskäufe und Auslastungsquote |
Transparenz und Tagging bilden die Grundlage. Ohne sie ist jede andere Säule Spekulation. Der Leitfaden zu FinOps-Best-Practices von GSA/ITVMO empfiehlt, organisatorische Ressourcenhierarchien — AWS Organizations, Azure Management Groups, GCP-Ordner — als feste Kostengrenze zu verwenden und Tags für metadatengesteuerte Berichte zu reservieren. Tags gehen kaputt. Hierarchien nicht.
Kostenverteilung und Chargeback übertragen Rohdaten aus der Abrechnung in die Sprache des Geschäfts. Ein Showback-Bericht zeigt einem Produktteam, wie viel es ausgegeben hat; ein Chargeback-Bericht belastet dieses Team mit den Kosten aus seinem Budget. Beginnen Sie mit Showback — so entsteht Vertrauen, bevor Sie von Teams verlangen, für einen Betrag Verantwortung zu übernehmen.
Budgetierung und Prognosen schließen den Kreislauf zwischen Finanzen und Engineering. Budgetobjekte in der Abrechnungskonsole Ihres Cloud-Anbieters, kombiniert mit Abweichungswarnungen bei 80 % und 100 % des Budgets, liefern FP&A die benötigten Signale, ohne eine monatliche manuelle Abstimmung zu erfordern. Die Verbindung mit agilen Finanzmodellierungspraktiken macht Prognosen reaktionsfähiger gegenüber tatsächlichen Nutzungsmustern.
Profi-Tipp: Wenn Ihre Organisation noch am Anfang ihrer Cloud-Entwicklung steht, sollten Sie zunächst Transparenz und Zuordnung priorisieren. Die Optimierung der Beschaffung (reservierte Instanzen, Sparpläne) bringt die größten Einsparungen in absoluten Zahlen, aber erst, wenn Sie Ihre grundlegenden Nutzungsmuster gut genug verstehen, um sich mit Zuversicht festzulegen.
Wie Cloud-Preismodelle funktionieren und welche Stellschrauben den größten Unterschied machen
Eine Branchenumfrage ergab, dass 66 % der Führungskräfte angaben, die Cloud-Migration habe die Gesamtbetriebskosten nicht gesenkt. Ein Drittel nannte unvorhersehbare Kosten und 31 % die Komplexität der Preisgestaltung als wichtigste Hindernisse. Das variable Abrechnungsmodell ist ohne ein Rahmenwerk tatsächlich schwer zu verwalten. Das Verständnis der Preisstrukturen ist die notwendige Voraussetzung.
| Preismodell | Typischer Kostenhebel | Geschäftlicher Kompromiss |
|---|---|---|
| Pay-as-you-go (On-Demand) | Rechte-sizing, Richtlinien für Autoscaling | Volle Flexibilität; höchste Kosten pro Einheit |
| Reservierte Instanzen / Sparpläne | Verpflichtungen über 1 oder 3 Jahre | 30 % Einsparung gegenüber On-Demand; erfordert Vertrauen in die Nutzung |
| Spot- / präemptible Instanzen | Fehlertolerante Batch-Workloads | Niedrigste Kosten; Unterbrechungsrisiko |
| Datenausgang | Zusammenlegung in derselben Region, CDN-Auslagerung | Deutliche Einsparungen; architektonische Änderungen erforderlich |
| Verwaltete Dienste | Auswahl der passenden Dienstklasse, Lebenszyklusrichtlinien | Komfortaufschlag; häufig überdimensioniert |
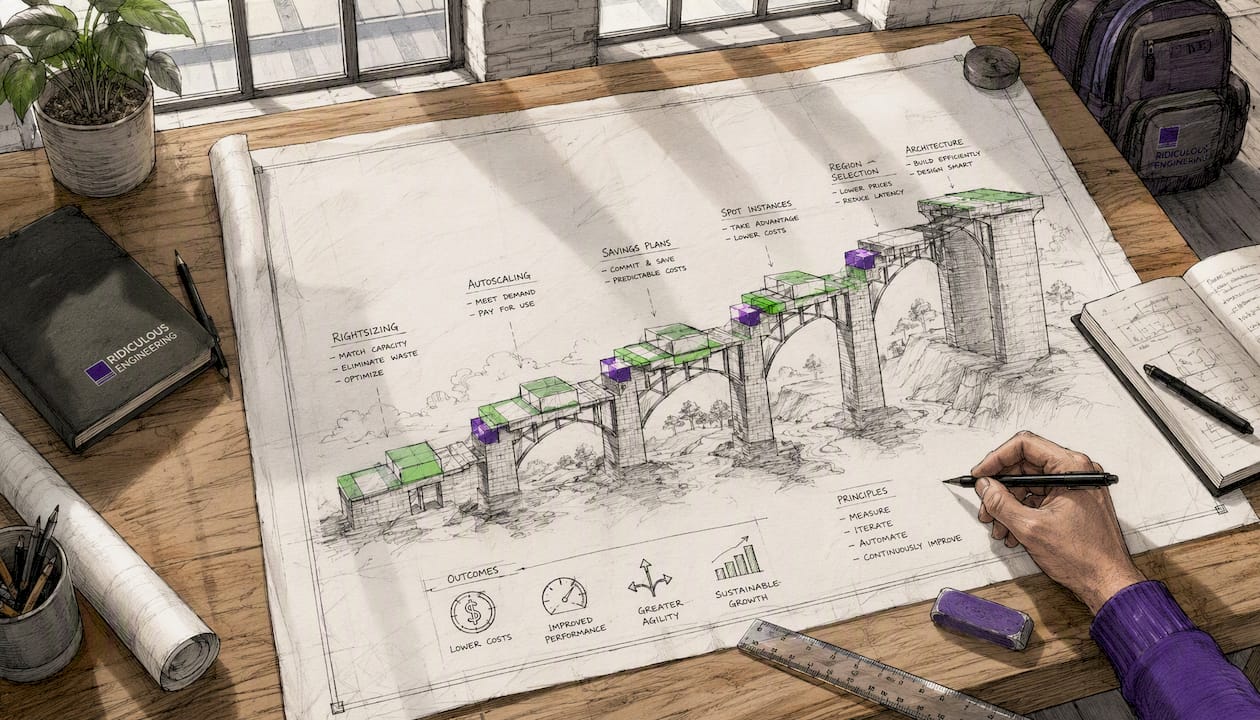
Die zuverlässigsten Hebel, geordnet nach dem Verhältnis von Aufwand zu Einsparungen, sind: Rightsizing und Autoscaling (geringer Aufwand, sofortige Wirkung), der Kauf reservierter Instanzen und Sparpläne (mittlerer Aufwand, große Einsparungen), Spot-Workloads für Batch- und CI/CD-Aufträge (mittlerer Aufwand, hohe Einsparungen bei geeigneten Workloads) sowie die Optimierung des Datenausgangs (höherer Aufwand, wobei Datenausgangskosten häufig der versteckte Kostenposten sind, der Teams überrascht).
Die Auswahl der Region ist wichtiger, als die meisten Teams erkennen. Workloads in einer Region mit niedrigeren Preisen für Rechenleistung auszuführen – unter Berücksichtigung der Anforderungen an den Datenstandort – kann die Kosten pro Einheit ohne architektonische Änderungen senken. Gerade bei KI- und GPU-Workloads lohnt es sich, diesen Kompromiss ausdrücklich zu modellieren, wie im Kontext von Kosten und Geschwindigkeit bei KI-Workloads ausbalancieren.
Profi-Tipp: Bündeln Sie den Kauf von Verpflichtungen (reservierte Instanzen, Sparpläne, Rabatte für zugesagte Nutzung) in einer einzigen FinOps- oder Beschaffungsfunktion. Dezentraler Verpflichtungskauf führt zu sich überschneidenden Käufen und einer zu geringen Auslastung. Überlassen Sie den Produktteams die Entscheidungen über On-Demand-Ausgaben; das zentrale Team sollte die Tarifoptimierung verantworten.
Aufbau des Governance-Rahmens: Rollen, Richtlinien und Durchsetzung
Ein Governance-Rahmen ohne namentlich benannte Verantwortliche ist ein Dokument, kein Programm. Die folgende Tabelle ordnet die fünf Kernrollen ihren Hauptaufgaben zu.
| Rolle | Hauptverantwortung |
|---|---|
| Zentrale FinOps- / Cloud-Finanzabteilung | Tarifoptimierung, Kauf von Verpflichtungen, Erstellung von Richtlinien, Berichterstattung |
| Engineering- / Produktverantwortliche | Tägliche Ausgabenentscheidungen, Einhaltung der Tagging-Vorgaben, Reaktion auf Anomalien |
| Beschaffung | Lieferantenverträge, Workflows zur Genehmigung von Verpflichtungen |
| Plattform-Engineering | IaC-Richtlinien als Code, Kontenhierarchie, Tooling |
| FP&A | Budgetobjekte, Abweichungsanalyse, Prognoseintegration |
Die FinOps-Prinzipien sind in dieser Struktur eindeutig: Eine zentrale FinOps-Funktion ermöglicht Best Practices, während Ingenieurinnen und Ingenieure die täglichen Kostenentscheidungen verantworten. Alles zu zentralisieren, schafft einen Engpass; alles zu dezentralisieren, schafft Chaos. Die Aufteilung besteht in der Ratenoptimierung (zentral) gegenüber Nutzungsentscheidungen (verteilt).
Richtlinientypen, die Ihr Programm vom ersten Tag an benötigt:
-
Tagging-Richtlinie — verpflichtende Tags (Produkt, Umgebung, Team, Kostenstelle) mit Durchsetzung durch IaC-Linting oder Cloud-Richtlinien-Engines
-
Richtlinie zur Kontenhierarchie — welche Konten/Abonnements welchen Geschäftskonstrukten zugeordnet werden
-
Umgang mit Budgets und Budgetüberschreitungen — wer bei 80 % benachrichtigt wird, wer Überschreitungen bei 100 % genehmigt
-
CI/CD-Kostenleitplanken — Kostenschätzung in Pull Requests für Infrastrukturänderungen
-
Beschaffungsregeln — Genehmigungsworkflow für jeden Verpflichtungskauf oberhalb eines festgelegten Schwellenwerts
-
Genehmigungsworkflows — wer Produktionsressourcen ohne Änderungsanfrage bereitstellen darf
Durchsetzungsspektrum: Warnungen sind in der Produktion der Standard. Genehmigungen gelten für die Bereitstellung neuer Ressourcen oberhalb eines Kostenschwellenwerts. Weiche Leitplanken (Budgetobergrenzen, die benachrichtigen, aber nicht beenden) gelten für Entwicklung und Test. Harte Stopps — die automatisierte Beendigung — sind nur für Nicht-Produktionsressourcen angemessen, die einen definierten Schwellenwert für Inaktivität überschreiten, und erst, nachdem eine menschliche Bestätigung in den Workflow integriert wurde. Die Usage.ai-Leitlinien zur Governance sind eindeutig: Eine Benachrichtigung, die vor jeder automatisierten Aktion bei kritischen Diensten eine Bestätigung erfordert, verhindert die Geschäftsunterbrechungen, die harte Stopps regelmäßig verursachen.
Profi-Tipp: Schreiben Sie Ihre erste Tagging-Richtlinie als Pull Request in Ihrem IaC-Repository und nicht als Wiki-Seite. Eine Richtlinie, die als Code vorliegt, wird überprüft, versioniert und durchgesetzt. Eine Richtlinie, die in einem Wiki steht, wird ignoriert.
Tägliche und wöchentliche Betriebskontrollen, die ein Abdriften der Ausgaben verhindern
Die Governance-Richtlinie ist der Bauplan. Betriebskontrollen sorgen tatsächlich dafür, dass die Kosten Woche für Woche im Rahmen bleiben. Die folgenden Kontrollen bilden den minimal erforderlichen Rhythmus für ein Team, das die Pilotphase abgeschlossen hat.
Tägliche Kontrollen:
-
Automatisierte Anomaliewarnungen, die ausgelöst werden, wenn die Ausgaben einen definierten Schwellenwert über dem gleitenden 7-Tage-Durchschnitt überschreiten, und die an Slack oder einen Webhook-Kanal weitergeleitet werden
-
Überprüfung verwaister Ressourcen — automatisierte Erkennung nicht verbundener Volumes, ungenutzter Load Balancer und inaktiver reservierter IPs
-
Bericht zur Tag-Compliance — Prozentsatz der Ausgaben, die durch verpflichtende Tags abgedeckt sind, einschließlich der täglichen Veränderung
Wöchentliche Kontrollen:
-
Rightsizing-Überprüfung: Rufen Sie die Rightsizing-Empfehlungen des Cloud-Anbieters ab und priorisieren Sie sie gemeinsam mit dem zuständigen Engineering-Team
-
Überprüfung der Auslastung reservierter Instanzen: Stellen Sie sicher, dass die Auslastung der Verpflichtungen über dem Zielschwellenwert bleibt (typischerweise über 80 %)
-
Prüfung des Speicherlebenszyklus: Ermitteln Sie Buckets oder Blobs, auf die keine Lebenszyklusrichtlinie angewendet wurde
-
Kostenprüfung der CI/CD-Pipeline: Überprüfen Sie die Infrastrukturkostenschätzungen der Bereitstellungen aus der Vorwoche
Playbook zur Anomaliebehandlung:
-
Warnung wird im Slack-/Webhook-Kanal ausgelöst
-
Die für den Bereitschaftsdienst eingeteilte Ingenieurin bzw. der eingeteilte Ingenieur bestätigt innerhalb einer festgelegten SLA (z. B. innerhalb von 2 Stunden während der Geschäftszeiten)
-
Triage: Ressource, Team und Grundursache ermitteln
-
Abhilfe: skalieren Sie herunter, beenden Sie die Ressource oder eskalieren Sie an die Ressourcenverantwortlichen
-
Postmortem: Grundursache dokumentieren und Richtlinie oder IaC aktualisieren, um eine Wiederholung zu verhindern
Die operative Anleitung von Praktikerinnen und Praktikern bringt es gut auf den Punkt: Die automatisierte Anomalieerkennung verkürzt die durchschnittliche Zeit bis zur Behebung von Monaten auf Stunden, wenn sie als Live-Signal in CI/CD- und Betriebsworkflows integriert ist, statt in einem monatlichen Abrechnungsbericht aufzutauchen.
Profi-Tipp: Weiche Limits mit menschlicher Bestätigung sind bei Produktionssystemen besser als harte Stopps. Automatisieren Sie sichere Aktionen — etwa das Beenden inaktiver Entwicklungsinstanzen oder das Archivieren seltener genutzter Speicherdaten — und verlangen Sie eine menschliche Freigabe für alles, was einen kundenorientierten Dienst beeinträchtigen könnte.
Welche Tools sollten Sie für das Cloud-Kostenmanagement verwenden?
Die richtige Antwort auf die Wahl der Tools hängt von Ihrem Cloud-Footprint, dem Ausgabenvolumen und der internen Engineering-Kapazität ab. Die Entscheidung lautet nicht, welchen Anbieter Sie auswählen sollten — sondern welche Fähigkeitsstufe Sie tatsächlich benötigen.
| Funktion | Cloud-native Abrechnungstools | Plattformautomatisierung (IaC/Policy-as-Code) | CCM-Plattformen |
|---|---|---|---|
| Ausgabenübersicht | Grundlegend (eine Cloud) | Keine | Multi-Cloud, vereinheitlicht |
| Erkennung von Anomalien | Eingeschränkt | Keine | Erweitert, ML-basiert |
| Reservierungsplanung | Anbieterspezifisch | Keine | Cloudübergreifende Optimierung |
| Durchsetzung von Tags | Manuell oder Policy-Engine | Stark (OPA, Sentinel) | Nur Berichte |
| Showback / Chargeback | Grundlegend | Keine | Vollständig |
| Automatisierungsaktionen | Eingeschränkt | Stark | Je nach Plattform unterschiedlich |
Cloud-native Tools — AWS Cost Explorer, Azure Cost Management, GCP Billing — sind der richtige Ausgangspunkt für Unternehmen mit einer einzelnen Cloud und unkomplizierter Abrechnung. Sie sind kostenlos, präzise und für die Pilotphase ausreichend. Die Einschränkung besteht darin, dass sie nicht cloudübergreifend aggregieren und ihre Anomalieerkennung grundlegend ist.
Plattformautomatisierung über Policy-Engines für Infrastructure as Code (Open Policy Agent, HashiCorp Sentinel, AWS Service Control Policies) übernimmt die Durchsetzung von Tags und Leitplanken für die Bereitstellung. Hier findet die von der Entwicklung geleitete Governance statt. Sie erfordert Disziplin bei IaC, erzeugt jedoch dauerhafte, versionskontrollierte Richtlinien.
CCM-Plattformen ergänzen die cloudübergreifende Aggregation, ML-basierte Anomalieerkennung, Empfehlungen zur Reservierungsoptimierung sowie die Automatisierung von Showback und Chargeback. Sie sind sinnvoll, wenn Sie über zwei oder mehr Clouds hinweg arbeiten, Ihre monatlichen Cloudausgaben die Abonnementkosten rechtfertigen oder Ihr internes Team nicht über die Kapazität verfügt, eigene Berichte zu erstellen. Das Framework zur Entscheidung zwischen Eigenentwicklung und Kauf gilt hier unmittelbar: Wenn eine Funktion kein Differenzierungsmerkmal ist und eine Plattform sie zuverlässig bereitstellt, kaufen Sie sie.
Profi-Tipp: Machen Sie die Anomalieerkennung zu Ihrer ersten Investition in Automatisierung – noch vor Dashboards und vor Chargeback. Eine Slack-Benachrichtigung, die innerhalb weniger Minuten nach einem Kostensprung ausgelöst wird, ist mehr wert als ein ansprechender Monatsbericht. Verbinden Sie sie mit einem Webhook, verlangen Sie eine Bestätigung, und Sie verfügen über eine schnelle Feedbackschleife, die das Verhalten von Entwicklern innerhalb weniger Wochen verändert.
Welche Kennzahlen Sie der Entwicklung bzw. Führungskräften präsentieren sollten
Der häufigste Fehler, den die meisten Teams machen, besteht darin, ein einziges Dashboard zu erstellen und es allen zu präsentieren. Die Entwicklungsabteilung benötigt detaillierte Signale nahezu in Echtzeit. Führungskräfte benötigen monatliche Zusammenfassungen in Geschäftssprache. Die Metriken unterscheiden sich – und das sollten auch die Dashboards tun.
Metriken für Engineering und Produktverantwortliche:
-
Kosten pro Ressource (VM, Container, Datenbank) pro Tag
-
Kosten pro Deployment (Infrastrukturänderung durch CI/CD-Läufe)
-
Anomalierate (Anzahl der ausgelösten im Vergleich zu den pro Woche gelösten Warnungen)
-
Prozentsatz nicht gekennzeichneter Ausgaben (Ziel: <5 %)
-
Auslastungsrate von Reservierungen (Ziel: mindestens 80 %)
Metriken für Führungskräfte und FP&A:
-
Gesamte Cloud-Ausgaben nach Produkt, im Monatsvergleich
-
Abweichung zwischen Prognose und Budget (aktueller Monat und rollierende 90 Tage)
-
Mischverhältnis aus gebundenen und On-Demand-Ausgaben
-
Stückkosten: Kosten pro Kunde, Kosten pro Transaktion, Kosten pro API-Aufruf
-
Verschwendung als Prozentsatz der Gesamtausgaben
Das FinOps Framework betont, dass Daten aktuell, korrekt und zugänglich sein müssen, um schnelle Entscheidungen zu ermöglichen. Ein Dashboard, das wöchentlich aktualisiert wird, ist für die Entwicklungsabteilung nicht aktuell genug. Ein Dashboard, das Kosten pro Ressource anzeigt, ist für einen CFO nicht hilfreich. Die Anbindung von Datenpipelines in Echtzeit an Ihren Abrechnungsexport macht das Entwicklungsdashboard tatsächlich operativ statt retrospektiv.
Die Verbesserung der Qualität der Finanzberichterstattung für Cloud-Ausgaben — durch eine Strukturierung, die die Fragen beantwortet, die Finanzteams tatsächlich stellen — ist eine eigenständige Disziplin, und Frameworks zur Verbesserung der Finanzberichterstattung bieten eine hilfreiche Struktur für die FP&A-orientierte Ebene Ihres Governance-Programms.
Profi-Tipp: Verknüpfen Sie Nutzungsmetriken mit Kostenmetriken, um Stückkosten zu ermitteln. Kosten pro Kunde = gesamte Cloud-Ausgaben / aktive Kunden. Erfassen Sie diesen Wert monatlich. Steigt er, haben Sie einen Anlass für ein Gespräch. Sinkt er, können Sie dem Unternehmen einen Erfolg präsentieren.
Wo Governance-Programme scheitern — und wie FinOps die Kultur verändert
Die meisten Misserfolge bei der Governance von Cloud-Kosten sind nicht technischer Natur. Sie sind organisatorischer Natur. Die Muster wiederholen sich vorhersehbar.
Häufige Fallstricke:
-
Governance als Überwachung behandeln. Wenn Ingenieure Kosten-Governance als Compliance-Prüfung statt als unterstützenden Service erleben, umgehen sie sie. Richtlinien werden ignoriert, Tags werden gefälscht, und das Programm verliert an Glaubwürdigkeit.
-
Sich ausschließlich auf Tags zur Zuordnung verlassen. Tags sind fragil. Ingenieure vergessen sie, benennen sie um oder verwenden sie uneinheitlich. Ohne die Konto-/Abonnementhierarchie als feste Grenze werden Zuordnungsberichte unzuverlässig.
-
Einmalige Bereinigungen statt kontinuierlicher Prozesse. Ein vierteljährlicher “Cloud-Bereinigungssprint” ist keine Governance. Er ist ein Beleg dafür, dass keine Governance existiert. Kontinuierliche operative Kontrollen machen Bereinigungssprints überflüssig.
-
Harte Stopps in der Produktion. Die automatische Beendigung von Produktionsressourcen auf Grundlage von Kostenschwellen verursacht Ausfälle. Die Kosten des Ausfalls übersteigen die Kosten der Mehrausgaben.
-
Feedbackschleifen der Governance ignorieren. Einmal verfasste und nie überprüfte Richtlinien veralten. Eine Tagging-Richtlinie für eine dreistufige Webanwendung deckt Kubernetes-Workloads oder serverlose Funktionen ohne Überarbeitung nicht ab.
Das FinOps-Kulturmodell geht diese Punkte direkt an. Die FinOps-Prinzipien verlagern die Verantwortung an die Peripherie: Ingenieure verantworten Nutzungsentscheidungen, während die zentrale FinOps-Funktion für Tarifoptimierung und Befähigung zuständig ist. Dies ist weder eine reine Finanz- noch eine reine Engineering-Funktion. Die Pilotleitlinien von GSA/ITVMO empfehlen eine kleine, funktionsübergreifende Steuerungsgruppe, die Richtlinien dort iterativ anpasst, wo es am wichtigsten ist, statt ein Top-down-Mandat zu erteilen. Die Verankerung der Autonomie der Engineering-Teams im Governance-Modell ermöglicht in der Praxis eine funktionierende verteilte Verantwortung.
Profi-Tipp: Führen Sie Governance als unterstützenden Service ein, nicht als Kontrollfunktion. Das Erste, was das FinOps-Team tun sollte, ist, Engineering-Teams bessere Einblicke in ihre eigenen Kosten zu geben – keine Richtlinien, keine Durchsetzung, nur Daten. Teams, die ihre Kosten sehen können, wollen sie fast immer reduzieren.
Die Einführung über 90 Tage: Meilensteine und Aufwandsstufen Woche für Woche
Die GSA/ITVMO-Leitlinien bestätigen den iterativen Ansatz: Regierungs- und Industriepiloten, die schrittweise FinOps-Einführungen nutzten — beginnend mit Transparenz, dann Zuordnung und anschließend Optimierung — erzielten sowohl bei der Akzeptanz als auch bei nachhaltigen Einsparungen bessere Ergebnisse als Big-Bang-Implementierungen. Der nachstehende 90-Tage-Plan folgt diesem Muster.
| Phase | Wochen | Meilensteine | Verantwortlich | Abnahmekriterien |
|---|---|---|---|---|
| Erkundung | 1–2 | Cloud-Abrechnungsexport konfiguriert; Kontenhierarchie erfasst; Stakeholder-Interviews abgeschlossen | Plattform-Engineering + FinOps | 100 % der Ausgaben in einer zentralen Ansicht sichtbar |
| Transparenzpilot | 3–4 | Tagging-Richtlinie entworfen und in IaC umgesetzt; Anomalie-Warnungen aktiv; erster Showback-Bericht erstellt | Plattform-Engineering + FinOps | geringe nicht markierte Ausgaben; erste Warnung bestätigt |
| Zuordnung | 5–8 | Showback-Berichte für die drei wichtigsten Produkte; Budgetobjekte erstellt; FP&A integriert | FinOps + FP&A | Warnungen bei Budgetabweichungen funktionieren und die Beteiligung von FP&A ist bestätigt |
| Optimierung | — | Empfehlungen zur bedarfsgerechten Dimensionierung geprüft; erste Reservierungskäufe genehmigt | FinOps + Beschaffung | Reservierungsnutzung über dem Zielschwellenwert, was eine effektive Nutzung anzeigt |
| Betrieb verankern | — | Betriebsrhythmus dokumentiert; Runbooks veröffentlicht; Tagging-Compliance >95 % | Alle Verantwortlichen | Wöchentlicher Überprüfungsrhythmus läuft ohne Aufforderung |
Checkliste für Tage 1–30:
-
Abrechnungsexport in einem zentralen Datenspeicher konfigurieren (BigQuery, S3 oder Azure Storage)
-
Konto-/Abonnementhierarchie den Geschäftsstrukturen zuordnen
-
Tagging-Richtlinie als IaC-Pull-Request entwerfen
-
Anomalie-Warnungen mit Slack-/Webhook-Weiterleitung einrichten
-
Ersten Showback-Bericht für das Produkt mit den höchsten Ausgaben erstellen
Checkliste für Tage 31–60:
-
Showback auf die drei wichtigsten Produkte ausweiten
-
Budgetobjekte mit Warnungen bei 80 % und 100 % erstellen
-
Cloud-Ausgabendaten in die FP&A-Planung integrieren
-
Rightsizing-Empfehlungen des Cloud-Anbieters prüfen und priorisieren
-
Die erste Überprüfung der Reservierungsnutzung durchführen
Checkliste für Tage 61–90:
-
Den ersten zentralisierten Kauf einer Reservierung oder eines Sparplans durchführen
-
Betriebliche Runbooks für die Reaktion auf Anomalien veröffentlichen
-
Eine Tagging-Compliance von über 95 % erreichen
-
Den ersten Management-Kostenbericht in Geschäftssprache bereitstellen
-
Vierteljährliche Richtlinienüberprüfung planen
Aufwands- und Kostenschätzungsbereiche:
-
Interne FTE-Stunden: 80–160 Stunden für Plattformentwicklung, FinOps und FP&A während des 90-tägigen Pilotprojekts
-
Cloud-native Tools: 0 $ (in Cloud-Anbieter-Konten enthalten)
-
CCM-Plattformabonnement: 500–5.000 $/Monat, abhängig vom Ausgabenvolumen und der Plattformstufe
-
Optionales Beratungsengagement: abhängig vom Umfang; ein fokussiertes Discovery- und Pilotengagement dauert typischerweise 4–8 Wochen
Profi-Tipp: Der Pilot ist bereit für die Skalierung, wenn drei Bedingungen erfüllt sind: Die Tagging-Compliance liegt über 95 %, mindestens ein Produktteam prüft seinen eigenen Showback-Bericht ohne dazu aufgefordert zu werden, und der Anomaliealarm wurde mindestens einmal ausgelöst und behoben. Diese drei Signale zeigen, dass das Programm organisatorische Unterstützung erfährt und nicht nur über technische Infrastruktur verfügt.
Was in den nächsten 30, 90 und 180 Tagen zu tun ist
Governance-Programme kommen ins Stocken, wenn Führungskräfte eine Planungssitzung ohne konkrete nächste Maßnahme verlassen. Die folgende Liste ist nach Wirkung priorisiert und so angeordnet, dass sie auf den einzelnen Phasen aufbaut.
Sofort (nächste 7–30 Tage):
-
Eine 7-tägige Transparenzanalyse durchführen: Billing-Export konfigurieren und die fünf größten Kostentreiber nach Produkt oder Team ermitteln. Erfolgskennzahl: 100 % der Ausgaben sind einem Geschäftskonstrukt zugeordnet.
-
Die Tagging-Richtlinie als IaC-PR entwerfen. Verantwortlich: Leitung der Plattformentwicklung.
-
Anomalieüberwachung einrichten. Verantwortlich: Plattformentwicklung. Erfolgskennzahl: Der erste Alarm wird innerhalb von 2 Stunden bestätigt.
Kurzfristig (30–90 Tage):
-
Showback-Berichte für die drei wichtigsten Produkte bereitstellen. Verantwortlich: FinOps/Finanzen. Erfolgskennzahl: Produktverantwortliche prüfen ihre eigenen Berichte monatlich.
-
Reduzieren Sie nicht gekennzeichnete Ausgaben auf unter 5 %. Verantwortlich: Platform Engineering und FinOps. Erfolgskennzahl: Tägliches Dashboard zur Tag-Compliance mit einem Wert von <5 %.
-
Budgetobjekte erstellen und in FP&A integrieren. Verantwortlich: FP&A + FinOps. Erfolgskennzahl: Abweichungsalarme werden ausgelöst, bevor es zu Überraschungen zum Monatsende kommt.
Mittelfristig (90–180 Tage):
-
Den ersten zentralisierten Reservierungskauf durchführen. Verantwortlich: Beschaffung + FinOps. Erfolgskennzahl: Reservierungsnutzung über 80 %.
-
Einheitsökonomie (Kosten pro Kunde oder Kosten pro Transaktion) für die beiden wichtigsten Produkte veröffentlichen. Verantwortlich: FinOps + Engineering. Erfolgskennzahl: Die Kennzahl wird monatlich erfasst und in der Produktplanung überprüft.
-
Die erste vierteljährliche Richtlinienüberprüfung durchführen. Verantwortlich: FinOps-Steuerungsgruppe. Erfolgskennzahl: Mindestens eine Richtlinie wird auf Grundlage des betrieblichen Feedbacks aktualisiert.
Wenn das Programm die 90-Tage-Marke erreicht hat und der betriebliche Rhythmus ohne Aufforderung funktioniert, ist der richtige Zeitpunkt gekommen, zu prüfen, ob externe Unterstützung die Optimierungs- und Einheitsökonomiephasen beschleunigen kann. Ein fokussiertes Engagement in dieser Phase erzielt schneller Einsparungen als eines zu Beginn, da die Daten und der organisatorische Kontext bereits vorhanden sind.
Wichtigste Erkenntnisse
Eine wirksame Governance der Cloud-Kosten erfordert Transparenz, verteilte Verantwortung und kontinuierliche betriebliche Kontrollen – keine einmalige Bereinigung oder reine Überwachungsfunktion der Finanzabteilung.
| Punkt | Details |
|---|---|
| Governance vs. Optimierung | Governance ist die Struktur (Rollen, Richtlinien, Kontrollen), die Kostenoptimierung wiederholbar und zu einer klar zugeordneten Aufgabe macht. |
| Hierarchie statt Tags | Konto-/Abonnementhierarchien als feste Kostengrenzen verwenden; Tags für Metadaten und Berichte vorbehalten. |
| Iterative Einführung | Beginnen Sie mit Transparenz und Zuordnung und optimieren Sie anschließend die Beschaffung — Big-Bang-Implementierungen bleiben durchgehend hinter den Erwartungen zurück. |
| Zuerst weiche Kontrollen | Lösen Sie für Produktionssysteme eine Warnung aus und verlangen Sie eine menschliche Bestätigung; automatisieren Sie harte Sperren nur für nicht produktive inaktive Ressourcen. |
| Ridiculous Engineering | Ridiculous Engineering bietet 90-tägige Pilotprojekte an, die ein Kosten-Dashboard, eine Tagging-Richtlinie und ein priorisiertes Optimierungshandbuch als konkrete Ergebnisse liefern. |
Ridiculous Engineering kann Sie beim Aufbau unterstützen
Die Governance von Cloud-Kosten ist ein technisches und organisatorisches Problem, nicht nur ein Finanzproblem. Ridiculous Engineering arbeitet mit Führungskräften aus Technologie und Finanzen zusammen, um Governance-Programme zu entwickeln und umzusetzen, die messbare Ergebnisse erzielen: Kostentransparenz auf Produktebene, eine Tagging-Compliance von über 95 % und Stückkostenmodelle, die Cloud-Ausgaben mit dem Geschäftswert verknüpfen.
Die beiden häufigsten Formen der Zusammenarbeit sind ein 90-tägiges Pilotprojekt (von der Bestandsaufnahme bis zur operativen Verankerung, mit einem Kosten-Dashboard und einem priorisierten Handbuch als Ergebnissen) sowie eine kürzere Bestandsaufnahme und Bewertung (2–4 Wochen, mit einer Analyse des Ist-Zustands, einem Bericht zu Governance-Lücken und einer priorisierten Roadmap). Beide Formen umfassen eine transparente Abgrenzung, festgelegte Ergebnisse und eine klare Übergabe, sodass Ihr Team das Programm nach Ende der Zusammenarbeit eigenständig betreibt.
Wenn Sie eine Führungskraft aus Technologie oder Finanzen sind und statt eines Anbieter-Pitches ein praxisnahes Governance-Framework benötigen, beginnen Sie ein Gespräch mit Ridiculous Engineering. Das erste Gespräch ist eine Arbeitssitzung, kein Verkaufsgespräch.
Nützliche Quellen
-
Übersicht über das FinOps-Foundation-Framework — Die wichtigste Referenz für FinOps-Prinzipien, Geltungsbereiche und das Kulturmodell verteilter Verantwortlichkeit. Beginnen Sie hier mit der konzeptionellen Grundlage.
-
FinOps-Foundation-Prinzipien — Die spezifischen Prinzipien für zentrale Befähigung und verteilte Verantwortung; unerlässlich für die Gestaltung des Rollenmodells.
-
GSA / ITVMO FinOps Best Practices — Von der Regierung validierte Leitlinien zu iterativen FinOps-Pilotprojekten, Tagging-Governance und Organisationshierarchie. Direkt auf Programme der US-Bundesregierung und von Unternehmen anwendbar.
-
Microsoft Cloud Adoption Framework: Cloud-Kosten verwalten — Azure-spezifische Leitlinien zur Zuordnung des Governance-Geltungsbereichs zu Geschäftskonstrukten und zur Durchführung regelmäßiger Überprüfungen.
-
BizTech Magazine: So kontrollieren Sie Cloud-Ausgaben — Branchendaten aus Umfragen zu Kostenunberechenbarkeit und Preiskomplexität als größten Hindernissen für die Realisierung des Gesamtbetriebskostenpotenzials der Cloud.
-
Ridiculous Engineering: Leitfaden zur Kubernetes-Kostenoptimierung — Plattformspezifische Kostentaktiken für containerisierte Workloads; empfohlene Lektüre für Teams, die Kubernetes einsetzen.
-
Ridiculous Engineering: Leitfaden zur Cloud-Migrationsstrategie — Planungshinweise für Migrationsphasen und Kostenprognosen; relevant für die Bestandsaufnahmephase des 90-tägigen Rollouts.
Häufig gestellte Fragen
Was ist Cloud-Kosten-Governance?
Cloud-Kosten-Governance umfasst die Rollen, Richtlinien und Kontrollen, die Cloud-Ausgaben kontinuierlich am Geschäftswert ausrichten. Sie unterscheidet sich von der Kostenoptimierung (einmalige Einsparmaßnahmen) und dem Kostenmanagement (Berichterstattung und Zuordnung), da sie die organisatorische Struktur bereitstellt, die beides wiederholbar macht.
Was bedeutet Kostenmanagement in der Cloud?
Cloud-Kostenmanagement umfasst die Berichterstattung, Zuordnung und Überwachung von Cloud-Ausgaben — Dashboards, Showback-Berichte, Budgetwarnungen und Rechnungsabstimmungen. Governance ist die darüberliegende Ebene, die festlegt, wer verantwortlich ist und welche Richtlinien Ausgabenentscheidungen begrenzen.
Was ist Governance für Cloud Computing?
Governance für Cloud Computing ist der umfassendere Rahmen aus Richtlinien, Kontrollen und Verantwortlichkeitsstrukturen für Sicherheit, Compliance, Kosten und Betriebsstandards in Cloud-Umgebungen. Cloud-Kosten-Governance ist ein spezifischer Bereich innerhalb dieses umfassenderen Rahmens, der sich auf finanzielle Verantwortlichkeit und die Ausrichtung der Ausgaben konzentriert.
Welche Cloud-Strategie eignet sich am besten zur Kostenoptimierung?
Der effektivste Ansatz kombiniert einen iterativen FinOps-Rollout — beginnend mit Transparenz und Zuordnung und anschließend mit der Optimierung der Beschaffung — mit verteilter Verantwortung: Ingenieurinnen und Ingenieure verantworten Nutzungsentscheidungen, während eine zentrale FinOps-Funktion die Optimierung von Tarifen und Verpflichtungen übernimmt. Die Festlegung auf reservierte Instanzen oder Savings Plans nach Ermittlung einer Nutzungsbasis erzielt typischerweise die größten nachhaltigen Einsparungen.