Gouvernance des coûts cloud pour les responsables technologiques et financiers
Gouvernance des coûts cloud pour les responsables technologiques et financiers La gouvernance des coûts cloud consiste à aligner les dépenses cloud sur la valeur métier grâce à des rôles, des politiques et des contrôles définis — et, pour la plupart des organisations, l’étape immédiate suivante consiste à effectuer un scan de visibilité de 7 jours qui...
Gouvernance des coûts cloud pour les responsables technologiques et financiers
La gouvernance des coûts cloud consiste à aligner les dépenses cloud sur la valeur métier grâce à des rôles, des politiques et des contrôles définis — et, pour la plupart des organisations, l’étape immédiate suivante consiste à effectuer un scan de visibilité de 7 jours qui associe chaque ligne de facture cloud à un produit, une équipe ou un centre de coûts.
En bref — ce que vous trouverez dans ce guide :
-
Une définition claire qui distingue la gouvernance de l’optimisation des coûts et du FinOps
-
Les six piliers de la gouvernance et l’artefact minimal requis pour chacun
-
Comment fonctionnent les principaux modèles tarifaires cloud et quels leviers font réellement la différence
-
Un cadre de rôles et de politiques avec un spectre de mise en application
-
Des contrôles opérationnels quotidiens et hebdomadaires pour prévenir la dérive des dépenses
-
Un arbre de décision pour le choix des outils (solutions cloud natives ou plateformes CCM)
-
Des KPI pour les équipes d’ingénierie et pour les fonctions directeur financier/FP&A
-
Les pièges culturels qui font échouer les programmes de gouvernance avant leur passage à l’échelle
-
Un déploiement sur 90 jours, semaine par semaine, avec des fourchettes d’estimation de l’effort et des coûts
Table des matières
-
Ce qu’est réellement la gouvernance des coûts cloud (et ce qu’elle n’est pas)
-
Les six piliers indispensables à tout programme de gouvernance
-
Comment fonctionnent les modèles tarifaires cloud et quels leviers font réellement la différence
-
Construire le cadre de gouvernance : rôles, politiques et mise en application
-
Contrôles opérationnels quotidiens et hebdomadaires pour prévenir la dérive des dépenses
-
Quels indicateurs présenter aux équipes d’ingénierie et aux dirigeants
-
Pourquoi les programmes de gouvernance échouent — et comment le FinOps transforme la culture
-
Le déploiement sur 90 jours : étapes et fourchettes d’effort semaine par semaine
-
Ridiculous Engineering peut vous aider à mettre cela en place
Ce qu’est réellement la gouvernance des coûts cloud (et ce qu’elle n’est pas)
La gouvernance des coûts cloud est la couche organisationnelle qui se situe au-dessus de l’optimisation des coûts. Elle définit qui est responsable des dépenses cloud, quelles politiques les encadrent et comment ces politiques sont appliquées en continu. L’optimisation est une action ponctuelle de réduction des coûts — redimensionner une machine virtuelle, supprimer un compartiment orphelin. La gestion constitue la couche de reporting et d’allocation — tableaux de bord, factures, rapports de refacturation interne. La gouvernance est la structure qui rend ces deux activités reproductibles et attribue clairement les responsabilités.
Le cadre FinOps définit bien ce concept : le FinOps est un cadre opérationnel qui maximise la valeur métier des dépenses cloud grâce à la collaboration entre les équipes d’ingénierie, de finance et métier, selon le principe que la valeur métier guide les décisions technologiques. La gouvernance est le mécanisme qui rend ce principe opérationnel.
Pour les organisations américaines, le périmètre pratique de la gouvernance couvre trois résultats gouvernés : le respect du budget (les dépenses ne dépassent pas les limites approuvées sans décision délibérée), la visibilité des coûts au niveau des produits (chaque dollar est associé à un élément métier) et les règles d’approvisionnement (les achats d’engagement suivent un processus d’approbation). La gouvernance ne doit pas devenir une fonction de contrôle exercée par l’ingénierie. Dès que les ingénieurs perçoivent la gouvernance comme un obstacle plutôt que comme un levier, le programme perd l’appropriation distribuée dont il dépend.
Conseil pratique : Choisissez un périmètre FinOps — un seul produit, environnement ou centre de coûts — pour votre pilote initial. Essayer de gouverner toutes les dépenses cloud dès le premier jour est le meilleur moyen de bloquer les programmes. Un pilote ciblé produit des éléments concrets qui permettent d’obtenir l’adhésion de l’organisation au déploiement plus large.
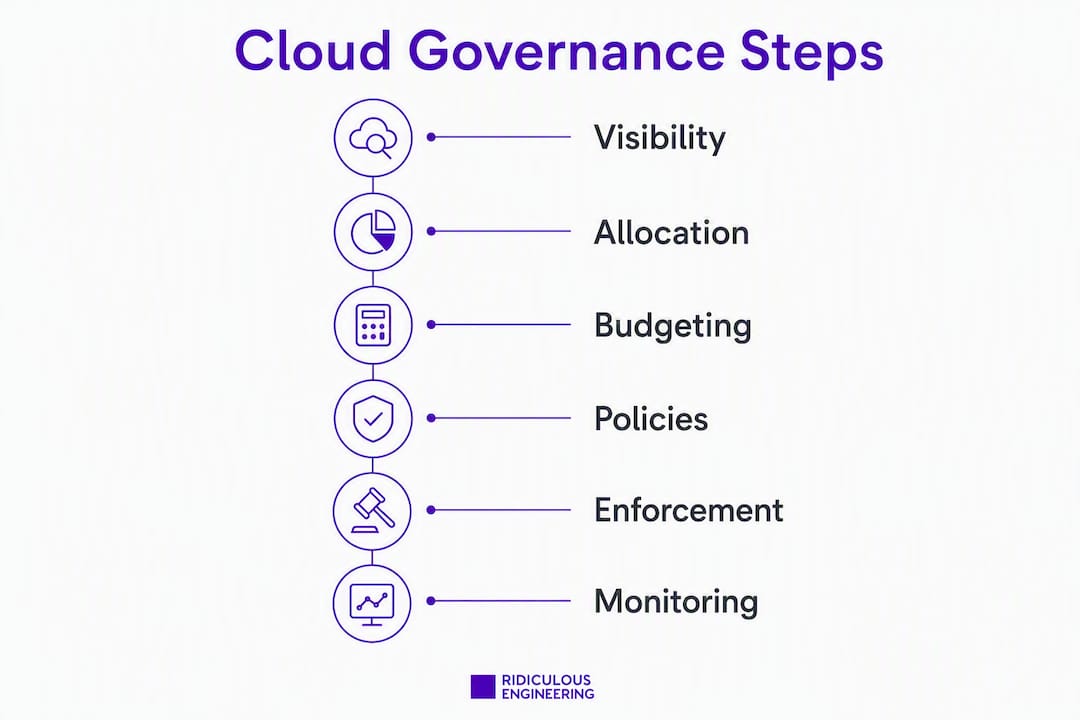
Les six piliers indispensables à tout programme de gouvernance
Les programmes de gouvernance qui s’inscrivent dans la durée reposent sur six piliers. Chacun dispose d’un artefact minimal — l’élément qui prouve que le pilier fonctionne réellement, et n’est pas seulement documenté.
| Pilier | Responsable | Fréquence | Livrable minimal |
|---|---|---|---|
| Visibilité et balisage | Ingénierie de plateforme | Quotidienne | Tableau de bord des dépenses balisées avec moins de 5 % de dépenses non balisées |
| Allocation / refacturation | FinOps / Finance | Mensuelle | Rapport de showback par produit et centre de coûts |
| Budgétisation et prévisions | FP&A + FinOps | Mensuelle / trimestrielle | Objets budgétaires avec alertes d’écart |
| Politique et contrôle | Responsables FinOps + ingénierie | Revue trimestrielle | Document de politique écrit + journal des contrôles |
| Optimisation et revues d’architecture | Ingénierie / architectes | Mensuelle | Rapport de dimensionnement adapté et de gaspillage |
| Approvisionnement et remises | Approvisionnement + FinOps | Trimestrielle | Journal des achats d’engagement et taux d’utilisation |
La visibilité et le balisage constituent le socle. Sans eux, tous les autres piliers reposent sur des suppositions. Les bonnes pratiques FinOps de la GSA/ITVMO recommandent d’utiliser les hiérarchies de ressources organisationnelles — AWS Organizations, Azure Management Groups, dossiers GCP — comme limite stricte des coûts, en réservant les balises aux rapports fondés sur les métadonnées. Les balises peuvent être défaillantes. Les hiérarchies, non.
L’allocation et la refacturation transforment les données brutes de facturation en langage métier. Un rapport de showback indique à une équipe produit ce qu’elle a dépensé ; un rapport de refacturation affecte ce coût à son budget. Commencez par le showback : il instaure la confiance avant de demander aux équipes d’assumer un montant.
La budgétisation et les prévisions bouclent la boucle entre la finance et l’ingénierie. Les objets budgétaires dans la console de facturation de votre fournisseur cloud, associés à des alertes de variance à 80 % et 100 % du budget, fournissent à la FP&A le signal dont elle a besoin sans nécessiter de rapprochement manuel mensuel. La connexion à des pratiques de modélisation financière agiles rend les prévisions plus réactives aux habitudes d’utilisation réelles.
Conseil pratique : Si votre organisation en est encore aux débuts de sa maturité cloud, donnez la priorité à la visibilité et à l’allocation. L’optimisation des achats (instances réservées, plans d’économies) permet de réaliser les économies les plus importantes en valeur absolue, mais seulement après avoir suffisamment compris vos habitudes d’utilisation de référence pour pouvoir vous engager en toute confiance.
Fonctionnement des modèles tarifaires cloud et leviers les plus efficaces
Une enquête sectorielle a révélé que 66 % des dirigeants ont déclaré que la migration vers le cloud n’avait pas réduit le coût total de possession, un tiers citant l’imprévisibilité des coûts et 31 % la complexité tarifaire comme principaux obstacles. Le modèle de facturation variable est réellement difficile à gérer sans cadre. Comprendre les structures tarifaires est le préalable indispensable.
| Modèle tarifaire | Levier de coût habituel | Compromis commercial |
|---|---|---|
| Paiement à l’utilisation (à la demande) | Dimensionnement adapté, politiques d’autoscaling | Flexibilité totale ; coût unitaire le plus élevé |
| Instances réservées / plans d’économies | Engagements d’un ou trois ans | 30 % d’économies par rapport à la demande ; nécessite une bonne visibilité sur l’utilisation |
| Instances Spot / préemptibles | Charges de travail batch tolérantes aux pannes | Coût le plus bas ; risque d’interruption |
| Sortie de données | Colocalisation dans une région, déport vers un CDN | Économies importantes ; modification de l’architecture nécessaire |
| Services managés | Choix du niveau adapté, politiques de cycle de vie | Prime de commodité ; souvent surdimensionnés |
Les leviers les plus fiables, classés selon le rapport entre l’effort et les économies, sont les suivants : dimensionnement adapté et autoscaling (faible effort, effet immédiat), achats d’instances réservées et de plans d’économies (effort moyen, économies importantes), charges Spot pour les tâches batch et les travaux CI/CD (effort moyen, économies élevées pour les charges adaptées), et optimisation de la sortie de données (effort plus important, mais les coûts de sortie constituent souvent le poste caché qui surprend les équipes).
Le choix de la région est plus important que la plupart des équipes ne le pensent. Exécuter les charges de travail dans une région où les tarifs de calcul sont plus bas — tout en tenant compte des exigences de résidence des données — peut réduire les coûts unitaires sans aucune modification de l’architecture. Pour les charges de travail d’IA et de GPU en particulier, ce compromis mérite d’être modélisé explicitement, comme indiqué dans le contexte de l’équilibre entre coût et rapidité dans les charges de travail d’IA.
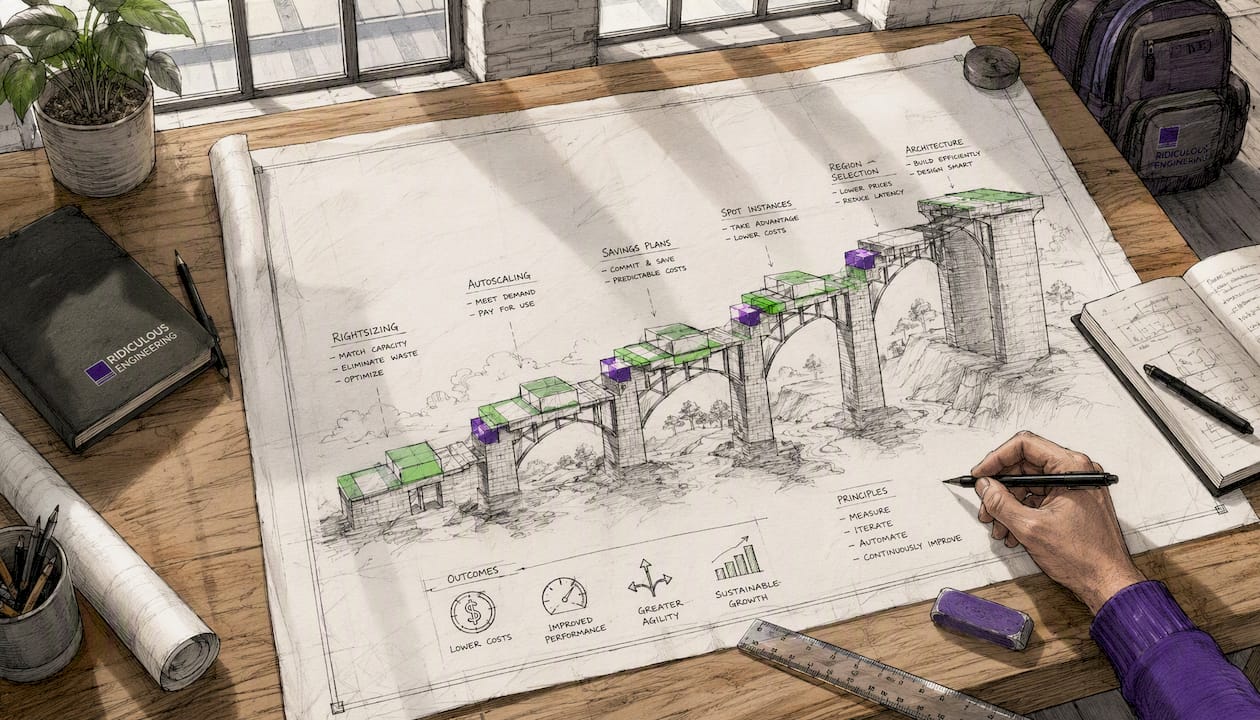
Conseil pratique : Centralisez les achats d’engagements (instances réservées, plans d’économies, remises pour utilisation engagée) au sein d’une seule fonction FinOps ou achats. Les achats d’engagements décentralisés entraînent des acquisitions qui se chevauchent et une sous-utilisation. Laissez les équipes produit gérer les décisions de dépenses à la demande ; laissez l’équipe centrale gérer l’optimisation des tarifs.
Établir le cadre de gouvernance : rôles, politiques et mise en œuvre
Un cadre de gouvernance sans responsables nommément désignés est un document, pas un programme. Le tableau ci-dessous associe les cinq rôles fondamentaux à leurs principales responsabilités.
| Rôle | Responsabilité principale |
|---|---|
| FinOps central / finance cloud | Optimisation des tarifs, achats d’engagements, rédaction des politiques, reporting |
| Responsables ingénierie / produit | Décisions quotidiennes en matière de dépenses, conformité du balisage, réponse aux anomalies |
| Achats | Contrats fournisseurs, workflows d’approbation des engagements |
| Ingénierie de plateforme | IaC en tant que code de politique, hiérarchie des comptes, outillage |
| FP&A | Objets budgétaires, analyse des écarts, intégration des prévisions |
Les principes du FinOps sont explicites concernant cette structure : une fonction FinOps centrale permet l’adoption des bonnes pratiques, tandis que les ingénieurs sont responsables des décisions quotidiennes liées aux coûts. Tout centraliser crée un goulot d’étranglement ; tout décentraliser crée le chaos. La distinction se fait entre l’optimisation des tarifs (centralisée) et les décisions d’utilisation (distribuées).
Types de politiques dont votre programme a besoin dès le premier jour :
-
Politique de balisage — balises obligatoires (produit, environnement, équipe, centre de coûts), avec application via le linting IaC ou les moteurs de politiques cloud
-
Politique de hiérarchie des comptes — quels comptes/abonnements correspondent à quelles structures métier
-
Gestion des budgets et des dépassements budgétaires — qui est averti à 80 %, qui approuve le dépassement à 100 %
-
Garde-fous de coûts CI/CD — estimation des coûts dans les pull requests pour les modifications d’infrastructure
-
Règles d’achat — workflow d’approbation pour tout achat d’engagement supérieur à un seuil défini
-
Workflows d’approbation — qui peut provisionner des ressources de niveau production sans demande de modification
Spectre d’application : Les alertes sont la configuration par défaut pour la production. Les approbations s’appliquent au provisionnement de nouvelles ressources dépassant un seuil de coût. Les garde-fous souples (plafonds budgétaires qui notifient sans interrompre) s’appliquent aux environnements de développement/test. Les arrêts stricts — l’interruption automatisée — ne conviennent qu’aux ressources hors production qui dépassent un seuil d’inactivité défini, et uniquement après l’intégration d’une confirmation humaine au workflow. La Usage.ai directive de gouvernance est claire : exiger une confirmation avant toute action automatisée sur les services critiques évite les interruptions d’activité que les arrêts stricts provoquent régulièrement.
Conseil pratique : Rédigez votre première politique de balisage sous forme de pull request dans votre dépôt IaC, et non comme une page wiki. Une politique qui réside dans le code est révisée, versionnée et appliquée. Une politique qui réside dans un wiki est ignorée.
Contrôles opérationnels quotidiens et hebdomadaires pour éviter les dérives de dépenses
La politique de gouvernance est le plan directeur. Les contrôles opérationnels sont ce qui permet réellement de maintenir les coûts sous contrôle d’une semaine à l’autre. Les contrôles ci-dessous constituent le rythme minimal viable pour une équipe ayant terminé la phase pilote.
Contrôles quotidiens :
-
Alertes automatisées d’anomalie configurées pour se déclencher lorsque les dépenses dépassent d’un seuil défini la moyenne glissante sur 7 jours, puis être acheminées vers Slack ou un canal webhook
-
Recherche des ressources orphelines — identification automatisée des volumes non attachés, des équilibreurs de charge inutilisés et des adresses IP réservées inactives
-
Rapport de conformité du balisage — pourcentage des dépenses couvertes par les balises obligatoires, avec évolution quotidienne
Contrôles hebdomadaires :
-
Revue du dimensionnement : récupérez les recommandations de dimensionnement du fournisseur cloud et triez-les avec l’équipe d’ingénierie concernée
-
Revue de l’utilisation des instances réservées : vérifiez que l’utilisation des engagements reste supérieure au seuil cible (généralement 80 % ou plus)
-
Audit du cycle de vie du stockage : identifiez les buckets ou blobs auxquels aucune politique de cycle de vie n’est appliquée
-
Vérification des coûts du pipeline CI/CD : examinez les estimations de coûts d’infrastructure des déploiements de la semaine précédente
Procédure de réponse aux anomalies :
-
L’alerte se déclenche dans le canal Slack/webhook
-
L’ingénieur d’astreinte confirme la prise en charge dans un délai défini par le SLA (par ex. 2 heures pendant les heures ouvrées)
-
Triage : identifiez la ressource, l’équipe et la cause racine
-
Atténuation : réduisez l’échelle, arrêtez la ressource ou transmettez le problème à son propriétaire
-
Analyse post-incident : documentez la cause racine et mettez à jour la politique ou l’IaC pour éviter toute récurrence
Les recommandations opérationnelles des praticiens l’expliquent bien : la détection automatisée des anomalies réduit le délai moyen de remédiation, qui passe de plusieurs mois à quelques heures lorsqu’elle est intégrée comme signal en temps réel dans les workflows CI/CD et opérationnels, plutôt que présentée dans un rapport de facturation mensuel.
Conseil pratique : Les limites souples avec confirmation humaine sont plus efficaces que les arrêts stricts pour les systèmes de production. Automatisez les actions sans risque — arrêter les instances de développement inactives, archiver le stockage froid — et exigez une validation humaine pour toute action susceptible d’affecter un service destiné aux clients.
Quels outils devriez-vous utiliser pour la gestion des coûts cloud ?
La réponse concernant les bons outils dépend de votre empreinte cloud, du volume de vos dépenses et de la capacité de votre équipe d’ingénierie interne. La question n’est pas de savoir quel fournisseur choisir — mais quel niveau de capacité vous est réellement nécessaire.
| Capacité | Outils de facturation cloud natifs | Automatisation de plateforme (IaC/politiques en tant que code) | Plateformes CCM |
|---|---|---|---|
| Visibilité des dépenses | Basique (un seul cloud) | Aucune | Multi-cloud, unifiée |
| Détection des anomalies | Limitée | Aucune | Avancée, basée sur le ML |
| Planification des réservations | Spécifique au fournisseur | Aucune | Optimisation inter-cloud |
| Mise en œuvre des balises | Manuelle ou via un moteur de politiques | Solide (OPA, Sentinel) | Rapports uniquement |
| Showback / refacturation | Basique | Aucune | Complète |
| Actions d’automatisation | Limitées | Solides | Varie selon la plateforme |
Les outils cloud natifs — AWS Cost Explorer, Azure Cost Management, GCP Billing — constituent le bon point de départ pour les organisations utilisant un seul cloud avec une facturation simple. Ils sont gratuits, précis et suffisants pour la phase pilote. Leur limite est qu’ils n’agrègent pas les données entre les clouds et que leur détection des anomalies reste basique.
L’automatisation de plateforme via des moteurs de politiques d’Infrastructure as Code (Open Policy Agent, HashiCorp Sentinel, AWS Service Control Policies) gère l’application des balises et les garde-fous du provisionnement. C’est là que s’exerce la gouvernance pilotée par l’ingénierie. Elle exige une discipline IaC, mais produit des politiques durables et contrôlées par version.
Les plateformes CCM ajoutent l’agrégation multi-cloud, la détection des anomalies basée sur le ML, les recommandations d’optimisation des réservations et l’automatisation du showback/de la refacturation. Elles sont pertinentes lorsque vous opérez sur deux clouds ou plus, lorsque vos dépenses cloud mensuelles justifient le coût de l’abonnement, ou lorsque votre équipe interne n’a pas la capacité de créer des rapports personnalisés. Le cadre de décision construire ou acheter s’applique directement ici : si cette capacité ne constitue pas un facteur de différenciation et qu’une plateforme la fournit de manière fiable, achetez-la.
Conseil de pro : Mettez en place la détection des anomalies comme premier investissement en automatisation, avant les tableaux de bord et avant la refacturation. Une alerte Slack qui se déclenche quelques minutes après une hausse des coûts vaut mieux qu’un magnifique rapport mensuel. Reliez-la à un webhook, exigez une confirmation de prise en charge, et vous disposerez d’une boucle de rétroaction rapide qui modifiera le comportement des ingénieurs en quelques semaines.
Quels indicateurs présenter aux équipes d’ingénierie par rapport aux dirigeants
L’erreur que commettent la plupart des équipes consiste à créer un seul tableau de bord et à le présenter à tout le monde. L’ingénierie a besoin de signaux détaillés, presque en temps réel. Les dirigeants ont besoin de synthèses en langage métier, selon une cadence mensuelle. Les indicateurs sont différents, et les tableaux de bord doivent l’être aussi.
Indicateurs pour l’ingénierie et les responsables produit :
-
Coût par ressource (VM, conteneur, base de données) par jour
-
Coût par déploiement (écart d’infrastructure lié aux exécutions CI/CD)
-
Taux d’anomalies (nombre d’alertes déclenchées par rapport au nombre d’alertes résolues par semaine)
-
Pourcentage des dépenses non étiquetées (objectif : <5 %)
-
Taux d’utilisation des réservations (objectif : 80 % et plus)
Indicateurs pour les dirigeants et la FP&A :
-
Dépenses cloud totales par produit, d’un mois sur l’autre
-
Écart entre les prévisions et le budget (mois en cours et période glissante de 90 jours)
-
Répartition des dépenses engagées et à la demande
-
Économie unitaire : coût par client, coût par transaction, coût par appel d’API
-
Gaspillage en pourcentage des dépenses totales
Le FinOps Framework souligne que les données doivent être disponibles en temps utile, exactes et accessibles afin de permettre une prise de décision rapide. Un tableau de bord mis à jour chaque semaine n’est pas suffisamment réactif pour l’ingénierie. Un tableau de bord qui affiche les coûts par ressource n’est pas utile à un directeur financier. La connexion de pipelines de données en temps réel à votre export de facturation permet au tableau de bord de l’ingénierie d’être véritablement opérationnel plutôt que rétrospectif.
Améliorer la qualité du reporting financier des dépenses cloud — en le structurant de manière à répondre aux questions que les équipes financières posent réellement — constitue une discipline à part entière, et les frameworks d’amélioration du reporting financier offrent une structure utile pour la couche de votre programme de gouvernance destinée à la FP&A.
Conseil de pro : Associez les indicateurs d’utilisation aux indicateurs de coûts pour produire une économie unitaire. Coût par client = dépenses cloud totales / clients actifs. Suivez-le chaque mois. Lorsqu’il augmente, vous avez matière à discussion. Lorsqu’il diminue, vous avez un succès à partager avec l’entreprise.
Là où les programmes de gouvernance échouent — et comment le FinOps fait évoluer la culture
La plupart des échecs de gouvernance des coûts cloud ne sont pas techniques. Ils sont organisationnels. Les mêmes schémas se répètent de manière prévisible.
Pièges courants :
-
Traiter la gouvernance comme une police. Lorsque les ingénieurs perçoivent la gouvernance des coûts comme un audit de conformité plutôt que comme un service facilitateur, ils la contournent. Les politiques sont ignorées, les étiquettes sont falsifiées et le programme perd sa crédibilité.
-
S’appuyer uniquement sur les étiquettes pour l’allocation. Les étiquettes sont fragiles. Les ingénieurs les oublient, les renomment ou les appliquent de manière incohérente. Sans hiérarchie de comptes ou d’abonnements comme limite structurelle, les rapports d’allocation deviennent peu fiables.
-
Privilégier les opérations de nettoyage ponctuelles plutôt que les processus continus. Un « sprint de nettoyage du cloud » trimestriel n’est pas de la gouvernance. C’est la preuve que la gouvernance n’existe pas. Des contrôles opérationnels continus remplacent le besoin de sprints de nettoyage.
-
Mettre en place des arrêts brutaux en production. La résiliation automatisée des ressources de production fondée sur des seuils de coûts provoque des incidents. Le coût de l’incident dépasse celui du dépassement budgétaire.
-
Ignorer les boucles de rétroaction de la gouvernance. Les politiques rédigées une fois puis jamais révisées deviennent obsolètes. Une politique d’étiquetage conçue pour une application web à trois niveaux ne couvre pas les charges Kubernetes ni les fonctions serverless sans révision.
Le modèle culturel du FinOps répond directement à ces problèmes. Les principes du FinOps transfèrent la responsabilité vers les équipes opérationnelles : les ingénieurs sont responsables des décisions d’utilisation, tandis que la fonction FinOps centrale prend en charge l’optimisation des tarifs et l’accompagnement. Il ne s’agit ni d’une fonction exclusivement financière ni d’une fonction exclusivement technique. Les recommandations du projet pilote GSA/ITVMO préconisent un petit groupe de pilotage transversal qui fait évoluer les politiques là où cela compte le plus, plutôt qu’un mandat descendant. Intégrer l’autonomie des équipes d’ingénierie au modèle de gouvernance est ce qui permet à une responsabilité distribuée de fonctionner en pratique.
Conseil de pro : Lancez la gouvernance comme un service facilitateur, et non comme une fonction de contrôle. La première chose que l’équipe FinOps devrait faire est d’offrir aux équipes d’ingénierie une meilleure visibilité sur leurs propres coûts — sans politiques ni sanctions, simplement des données. Les équipes qui voient leurs coûts veulent presque toujours les réduire.
Le déploiement sur 90 jours : jalons et fourchettes d’effort semaine par semaine
Les directives de la GSA/ITVMO valident l’approche itérative : les projets pilotes gouvernementaux et industriels ayant utilisé des déploiements FinOps progressifs — en commençant par la visibilité, puis l’allocation et enfin l’optimisation — ont obtenu de meilleurs résultats que les mises en œuvre globales en une seule fois, tant en matière d’adoption que d’économies durables. Le plan sur 90 jours ci-dessous suit ce modèle.
| Phase | Semaines | Jalons | Responsable | Critères d’acceptation |
|---|---|---|---|---|
| Découverte | 1–2 | Exportation de la facturation cloud configurée ; hiérarchie des comptes cartographiée ; entretiens avec les parties prenantes terminés | Ingénierie de plateforme + FinOps | 100 % des dépenses visibles dans un tableau de bord unique |
| Projet pilote de visibilité | 3–4 | Politique de balisage rédigée et intégrée à l’IaC ; alertes d’anomalie actives ; premier rapport de refacturation interne | Ingénierie de plateforme + FinOps | faible niveau de dépenses non balisées ; première alerte reconnue |
| Allocation | 5–8 | Rapports de refacturation interne pour les 3 principaux produits ; objets budgétaires créés ; FP&A intégré | FinOps + FP&A | Alertes d’écart budgétaire opérationnelles et participation de FP&A confirmée |
| Optimisation | — | Recommandations de dimensionnement ajustées triées par priorité ; premiers achats de réservations approuvés | FinOps + Achats | Taux d’utilisation des réservations supérieur au seuil cible, indiquant une utilisation efficace |
| Intégration aux opérations | — | Cadence opérationnelle documentée ; procédures publiées ; conformité au balisage >95 % | Tous les responsables | La cadence de revue hebdomadaire fonctionne sans relance |
Liste de contrôle des jours 1–30 :
-
Configurer l’exportation de la facturation vers un stockage de données centralisé (BigQuery, S3 ou Azure Storage)
-
Cartographier la hiérarchie des comptes/abonnements aux structures de l’entreprise
-
Rédiger la politique de balisage sous forme de demande de modification IaC
-
Mettre en place des alertes d’anomalie avec acheminement vers Slack/webhook
-
Produire le premier rapport de refacturation interne pour le produit générant le plus de dépenses
Liste de contrôle des jours 31–60 :
-
Étendre la refacturation interne aux trois principaux produits
-
Créer des objets budgétaires avec des alertes à 80 % et 100 %
-
Intégrer les données de dépenses cloud aux prévisions FP&A
-
Examiner les recommandations de dimensionnement approprié du fournisseur cloud
-
Effectuer la première revue de l’utilisation des réservations
Checklist des jours 61–90 :
-
Effectuer le premier achat centralisé de réservation ou de plan d’économies
-
Publier des procédures opérationnelles pour la réponse aux anomalies
-
Atteindre un taux de conformité du balisage supérieur à 95 %
-
Fournir le premier rapport exécutif sur les coûts dans un langage métier
-
Planifier la revue trimestrielle des politiques
Fourchettes d’estimation de l’effort et des coûts :
-
Heures de travail internes : 80–160 heures réparties entre l’ingénierie de plateforme, la FinOps et la FP&A pour le pilote de 90 jours
-
Outils cloud natifs : 0 $ (inclus dans les comptes des fournisseurs cloud)
-
Abonnement à une plateforme CCM : 500–5 000 $/mois selon le volume de dépenses et le niveau de la plateforme
-
Mission de conseil facultative : variable selon le périmètre ; une mission ciblée de découverte et de pilotage dure généralement 4–8 semaines
Astuce : Le pilote est prêt à passer à l’échelle lorsque trois conditions sont réunies : la conformité du balisage dépasse 95 %, au moins une équipe produit examine son propre rapport de refacturation interne sans qu’on le lui demande, et l’alerte d’anomalie s’est déclenchée puis a été résolue au moins une fois. Ces trois signaux indiquent que le programme bénéficie d’une adhésion organisationnelle, et pas seulement d’une infrastructure technique.
Que faire au cours des 30, 90 et 180 prochains jours
Les programmes de gouvernance s’enlisent lorsque les dirigeants quittent une session de planification sans action suivante précise. La liste ci-dessous est priorisée selon son impact et séquencée pour s’appuyer sur chaque phase.
Immédiat (7–30 prochains jours) :
-
Effectuer un scan de visibilité de 7 jours : configurer l’exportation de la facturation et identifier les cinq principaux facteurs de coûts par produit ou par équipe. Indicateur de réussite : 100 % des dépenses associées à une structure métier.
-
Rédiger la politique de balisage sous forme de PR IaC. Responsable : responsable de l’ingénierie de plateforme.
-
Mettre en place les alertes d’anomalies. Responsable : ingénierie de plateforme. Indicateur de réussite : première alerte reconnue dans les 2 heures.
À court terme (30–90 jours) :
-
Fournir des rapports de refacturation interne pour les trois principaux produits. Responsable : FinOps/Finance. Indicateur de réussite : les responsables produit examinent leurs propres rapports chaque mois.
-
Réduire les dépenses non étiquetées à moins de 5 %. Responsables : ingénierie de la plateforme et FinOps. Indicateur de réussite : tableau de bord quotidien de conformité des balises affichant <5 %.
-
Créer les objets budgétaires et les intégrer à la FP&A. Responsables : FP&A + FinOps. Indicateur de réussite : les alertes d’écart se déclenchent avant les surprises de fin de mois.
À moyen terme (90–180 jours) :
-
Effectuer le premier achat centralisé de réservations. Responsables : achats + FinOps. Indicateur de réussite : utilisation des réservations supérieure à 80 %.
-
Publier les indicateurs d’économie unitaire (coût par client ou coût par transaction) pour les deux principaux produits. Responsables : FinOps + ingénierie. Indicateur de réussite : indicateur suivi chaque mois et examiné lors de la planification produit.
-
Effectuer la première revue trimestrielle des politiques. Responsable : groupe de pilotage FinOps. Indicateur de réussite : au moins une politique mise à jour sur la base des retours opérationnels.
Lorsque le programme atteint 90 jours et que le rythme opérationnel fonctionne sans relance, c’est le bon moment pour évaluer si une aide externe peut accélérer les phases d’optimisation et d’économie unitaire. Une mission ciblée à ce stade permet de réaliser des économies plus rapidement qu’au début, car les données et le contexte organisationnel existent déjà.
Principaux enseignements
Une gouvernance efficace des coûts cloud nécessite de la visibilité, une responsabilité distribuée et des contrôles opérationnels continus — et non un nettoyage ponctuel ou une fonction de contrôle exclusivement financière.
| Point | Détails |
|---|---|
| Gouvernance et optimisation | La gouvernance est la structure (rôles, politiques et contrôles) qui rend l’optimisation des coûts reproductible et permet d’en attribuer la responsabilité. |
| Hiérarchie plutôt que balises | Utiliser les hiérarchies de comptes/abonnements comme frontières de coûts strictes ; réserver les balises aux métadonnées et aux rapports. |
| Déploiement itératif | Commencez par la visibilité et l’allocation, puis optimisez les achats — les mises en œuvre globales échouent systématiquement. |
| Contrôles indirects d’abord | Alertez et exigez une confirmation humaine pour les systèmes de production ; automatisez les blocages stricts uniquement pour les ressources inactives hors production. |
| Ridiculous Engineering | Ridiculous Engineering propose des missions pilotes de 90 jours qui fournissent un tableau de bord des coûts, une politique d’étiquetage et un guide d’optimisation priorisé comme livrables concrets. |
Ridiculous Engineering peut vous aider à mettre cela en place
La gouvernance des coûts cloud est un problème d’ingénierie et d’organisation, pas seulement un problème financier. Ridiculous Engineering travaille avec les responsables technologiques et financiers pour concevoir et mettre en œuvre des programmes de gouvernance produisant des résultats mesurables : visibilité des coûts au niveau des produits, conformité de l’étiquetage supérieure à 95 % et économie unitaire reliant les dépenses cloud à la valeur métier.
Les deux formats de mission les plus courants sont un pilote de 90 jours (de la découverte à l’intégration opérationnelle, avec un tableau de bord des coûts et un guide priorisé comme livrables) et une découverte et évaluation plus courtes (2–4 semaines, produisant une analyse de l’état actuel, un rapport sur les lacunes de gouvernance et une feuille de route priorisée). Les deux missions incluent un périmètre transparent, des livrables fixes et une transmission claire afin que votre équipe soit propriétaire du programme à la fin de la mission.
Si vous êtes un responsable technologique ou financier qui a besoin d’un cadre de gouvernance pratique plutôt que d’un argumentaire commercial, entamez une conversation avec Ridiculous Engineering. Le premier appel est une séance de travail, pas un appel commercial.
Sources utiles
-
Vue d’ensemble du cadre de la FinOps Foundation — La référence principale pour les principes FinOps, les périmètres et le modèle culturel de responsabilité distribuée. Commencez ici pour acquérir les bases conceptuelles.
-
Principes de la FinOps Foundation — Les principes spécifiques régissant l’activation centralisée et la propriété distribuée ; essentiels pour concevoir le modèle des rôles.
-
Bonnes pratiques FinOps de la GSA / ITVMO — Recommandations validées par le gouvernement sur les pilotes FinOps itératifs, la gouvernance de l’étiquetage et la hiérarchie organisationnelle. Directement applicables aux programmes fédéraux et d’entreprise américains.
-
Microsoft Cloud Adoption Framework : gérer les coûts cloud — Recommandations spécifiques à Azure sur l’alignement du périmètre de gouvernance avec les structures métier et la réalisation d’examens périodiques.
-
BizTech Magazine : comment maîtriser les dépenses cloud — Données d’enquête sectorielle montrant que l’imprévisibilité des coûts et la complexité tarifaire sont les principaux obstacles à la réalisation du coût total de possession du cloud.
-
Ridiculous Engineering : guide d’optimisation des coûts Kubernetes — Tactiques d’optimisation des coûts propres aux plateformes pour les charges de travail conteneurisées ; lecture recommandée aux équipes utilisant Kubernetes.
-
Ridiculous Engineering : guide de stratégie de migration cloud — Recommandations de planification pour les phases de migration et la prévision des coûts ; pertinent pour la phase de découverte du déploiement de 90 jours.
FAQ
Qu’est-ce que la gouvernance des coûts cloud ?
La gouvernance des coûts cloud est l’ensemble des rôles, politiques et contrôles qui alignent continuellement les dépenses cloud sur la valeur métier. Elle se distingue de l’optimisation des coûts (actions ponctuelles d’économies) et de la gestion des coûts (reporting et allocation) en fournissant la structure organisationnelle qui rend ces deux activités reproductibles.
Qu’est-ce que la gestion des coûts dans le cloud ?
La gestion des coûts cloud couvre le reporting, l’allocation et le suivi des dépenses cloud — tableaux de bord, rapports de refacturation, alertes budgétaires et rapprochement des factures. La gouvernance est la couche supérieure qui définit les responsabilités et les politiques encadrant les décisions de dépenses.
Qu’est-ce que la gouvernance du cloud computing ?
La gouvernance du cloud computing est le cadre plus large de politiques, contrôles et structures de responsabilité couvrant la sécurité, la conformité, les coûts et les normes opérationnelles des environnements cloud. La gouvernance des coûts cloud est un domaine spécifique de ce cadre plus large, axé sur la responsabilité financière et l’alignement des dépenses.
Quelle est la meilleure stratégie cloud pour optimiser les coûts ?
L’approche la plus efficace combine un déploiement FinOps itératif — en commençant par la visibilité et l’allocation, puis en passant à l’optimisation des achats — avec une propriété distribuée, où les ingénieurs prennent en charge les décisions d’utilisation et où une fonction FinOps centrale gère l’optimisation des tarifs et des engagements. Souscrire à des instances réservées ou à des plans d’économies après avoir établi une référence d’utilisation permet généralement d’obtenir les économies durables les plus importantes.