Optimisation des coûts Kubernetes : Un guide DevOps 2026
Optimisation des coûts Kubernetes : Un guide DevOps 2026 L'optimisation des coûts Kubernetes consiste à réduire le gaspillage de l'infrastructure cloud tout en maintenant la fiabilité, grâce au dimensionnement adéquat des ressources, à l'automatisation du scaling et à l'utilisation d'options de calcul à tarif réduit.
Optimisation des coûts Kubernetes : Un guide DevOps 2026
L'optimisation des coûts Kubernetes consiste à réduire le gaspillage de l'infrastructure cloud tout en maintenant la fiabilité, grâce au dimensionnement adéquat des ressources, à l'automatisation du scaling et à l'utilisation d'options de calcul à tarif réduit. Le problème fondamental est structurel : les factures Kubernetes sont basées sur les demandes de ressources des pods, et non sur l'utilisation réelle, ce qui maintient les coûts des clusters élevés même lors de faibles trafics. L'utilisation moyenne du CPU dans les clusters de production n'est que de 8–12 % de la capacité provisionnée, ce qui signifie que la plupart des équipes paient pour du calcul inactif chaque heure de chaque jour. La bonne nouvelle est que les équipes appliquant le redimensionnement, l'autoscaling et les stratégies d'instances Spot réalisent systématiquement des réductions de 30–60 % des dépenses Kubernetes, avec beaucoup d'économies significatives dès le premier mois.
Comment le redimensionnement des demandes de ressources des pods permet-il de réduire les coûts Kubernetes ?
Le redimensionnement est le levier le plus puissant dans toute démarche de réduction des coûts. Kubernetes planifie les pods en fonction de leurs ressources demandées, et non de ce qu'elles consomment réellement. Un pod demandant 2 cœurs CPU réserve cette capacité sur un nœud, qu'il utilise 0,2 cœur ou non à l'exécution. Cet écart entre les demandes et l'utilisation réelle est là où se cache la plupart des gaspillages budgétaires.
La solution pratique consiste à fixer les demandes au 99e percentile de l'utilisation historique plus une marge de 20 %. Une à deux semaines de surveillance fournissent suffisamment de signaux pour identifier l'écart entre ce que les pods demandent et ce qu'ils consomment réellement. Cet écart correspond souvent à une surestimation de 3 à 8 fois, ce qui signifie que votre cluster pourrait fonctionner avec une fraction de son nombre actuel de nœuds.
Pratiques clés pour un redimensionnement sûr :
-
Audit en premier. Récupérez les métriques d'utilisation réelles depuis Prometheus ou la surveillance native de votre fournisseur cloud’ avant de modifier les demandes.
-
Utilisez le Vertical Pod Autoscaler (VPA) en mode recommandation. Le VPA analyse l'utilisation historique et suggère des valeurs bien dimensionnées sans les appliquer automatiquement, vous donnant le contrôle avant de valider.
-
Définissez les limites de mémoire avec prudence. Les événements OOMKill de mémoire plantent les pods, donc maintenez les limites de mémoire légèrement au-dessus des demandes plutôt qu'égales à celles-ci.
-
Évitez de définir les demandes CPU égales aux limites CPU. Le throttling CPU sous les limites provoque des pics de latence sans planter le pod, ce qui rend la détection plus difficile.
-
Itérez d'abord en environnement de préproduction. Appliquez les nouvelles valeurs de demande aux charges de travail non critiques, mesurez la stabilité pendant une semaine, puis déployez en production.
Les résultats concrets valident cette approche. Les études de cas montrent des factures mensuelles passant de 52 000 $ à 23 000 $ et de 85 000 $ à 34 000 $ en quelques mois grâce au redimensionnement combiné à l'autoscaling. Les économies ne sont pas théoriques.
Conseil d'expert : Ne définissez jamais les demandes CPU égales aux limites CPU en production. Le throttling est silencieux et dégrade les performances sans déclencher d'alertes, ce qui en fait l'une des causes cachées les plus courantes de latence dans les charges de travail Kubernetes.
Quelles stratégies d'autoscaling optimisent l'élasticité des charges de travail ?
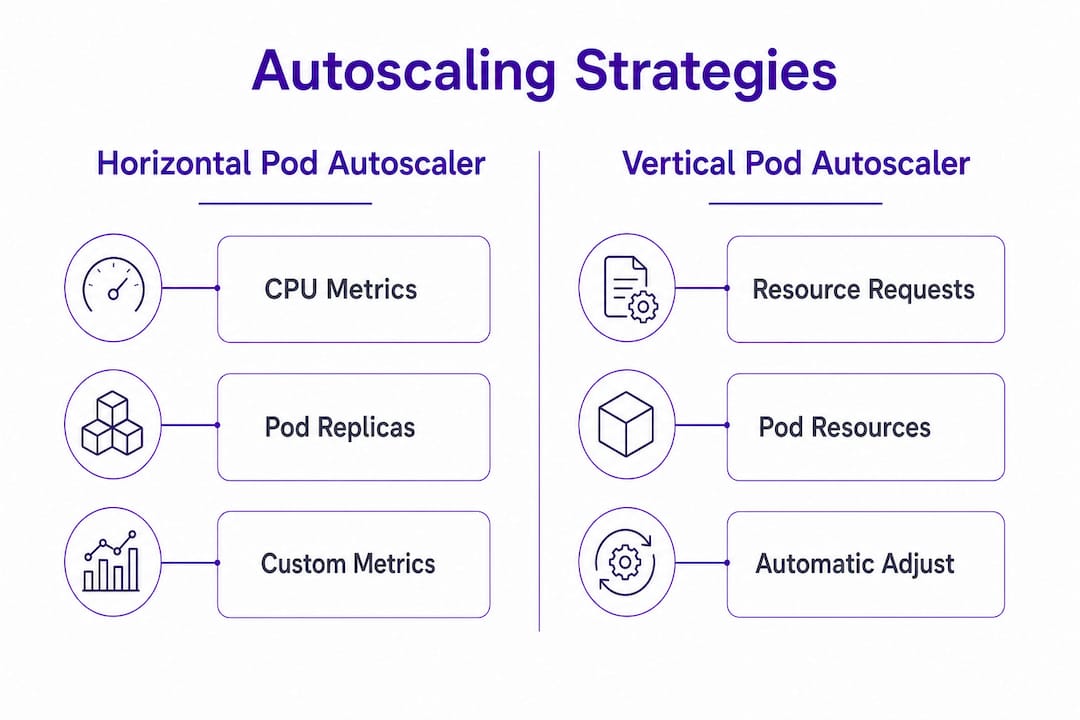
L'allocation statique des ressources est l'ennemi de l'efficacité des coûts. L'autoscaling remplace la capacité fixe par une capacité dynamique qui suit la demande réelle. Trois outils couvrent toute la gamme des besoins de scaling : le Horizontal Pod Autoscaler (HPA), le Vertical Pod Autoscaler (VPA) et KEDA (Kubernetes Event-Driven Autoscaler).
L'HPA scale les réplicas de pods horizontalement en fonction du CPU ou de métriques personnalisées. Le VPA ajuste les demandes de ressources des pods verticalement au fil du temps. KEDA étend l'HPA pour prendre en charge le scaling événementiel à partir de sources comme Kafka, SQS ou les files d'attente HTTP, et surtout, il prend en charge le scale-to-zero pour les charges de travail tolérantes aux démarrages à froid. La séparation des préoccupations entre ces trois outils donne aux équipes un contrôle précis : le VPA gère le dimensionnement de la mémoire, l'HPA gère le nombre de réplicas piloté par le CPU, et KEDA gère les pics événementiels et les modèles d'inactivité.
Le provisionnement des nœuds est là où les plus grandes économies d'infrastructure apparaissent. Karpenter réduit le gaspillage de calcul de 15–30 % par rapport à l'ancien Cluster Autoscaler en sélectionnant dynamiquement les types d'instances les plus rentables parmi des milliers d'options. Karpenter prend également en charge la consolidation automatisée des nœuds, qui regroupe les charges de travail sur moins de nœuds et termine ceux sous-utilisés. C'est le mécanisme derrière les plus grandes réductions de coûts documentées. Pour les équipes gérant des événements de scaling à fort trafic, combiner Karpenter avec l'HPA crée un système qui scale rapidement vers l'extérieur et se réduit agressivement.
Bonnes pratiques d'autoscaling à mettre en œuvre immédiatement :
-
Configurez les fenêtres de stabilisation de scale-down de l'HPA à 5–10 minutes plutôt que la valeur par défaut de 5 minutes pour éviter les oscillations, mais réglez le scale-up pour répondre en moins de 60 secondes.
-
Utilisez les politiques de consolidation de Karpenter pour remplacer automatiquement les nœuds surdimensionnés par des nœuds plus petits et moins chers pendant les périodes de faible demande.
-
Réglez les déclencheurs KEDA pour mettre les jobs batch à zéro entre les exécutions, éliminant entièrement les coûts des pods inactifs.
Conseil d'expert : Configurez l'HPA avec un comportement de scale-down agressif en définissant scaleDown.stabilizationWindowSeconds à 300 et percentPod policies pour supprimer 50 % des pods excédentaires par minute. Cela seul peut réduire les coûts de calcul hors pointe de 20–40 % pour les charges de travail variables.
Comment les instances Spot et les changements d'architecture peuvent-ils amplifier les économies ?
Les choix au niveau de l'infrastructure amplifient les économies issues du redimensionnement et de l'autoscaling. Les instances Spot offrent des économies de 60–90 % par rapport aux tarifs On-Demand, ce qui en fait le levier de tarification le plus impactant. Le piège est le risque d'interruption. Les instances Spot peuvent être récupérées par le fournisseur cloud avec un préavis de deux minutes’, donc le choix des charges de travail est crucial.
Les charges de travail sans état, les jobs batch et les runners CI/CD sont des candidats idéaux pour Spot. Les charges de travail avec état, les bases de données et tout ce qui nécessite des connexions persistantes doivent rester sur des nœuds On-Demand. Implémentez Spot en toute sécurité en combinant les budgets de perturbation des pods avec des tolérances de nœuds ciblant les pools de nœuds Spot. Karpenter gère automatiquement la bascule vers Spot, passant à On-Demand lorsque la capacité Spot n'est pas disponible.
| Optimisation | Économies estimées | Complexité de mise en œuvre |
|---|---|---|
| Instances Spot (charges de travail sans état) | 60–90 % sur le calcul éligible | Moyenne |
| Processeurs ARM Graviton | ~20 % de réduction des coûts | Faible à Moyenne |
| Migration vers les volumes EBS gp3 | ~20 % de réduction des coûts de stockage | Faible |
| Contrôleurs d'ingress consolidés | Variable, réduit le nombre de load balancers | Faible |
| Points de terminaison VPC pour les passerelles NAT | Réduit les frais de transfert de données | Faible |
La migration vers des instances Graviton basées sur ARM permet des coûts environ 20 % inférieurs avec des performances comparables ou meilleures pour la plupart des charges de travail. Karpenter peut cibler automatiquement Graviton lorsque vous spécifiez ARM comme architecture préférée dans votre configuration NodePool. La migration de gp2 à gp3 pour les volumes EBS réduit les coûts de stockage d'environ 20 % sans temps d'arrêt, car la migration se fait en ligne. Ce sont des changements à faible effort avec des rendements garantis.
Les coûts réseau sont souvent négligés. Les frais de transfert de données des passerelles NAT s'accumulent rapidement dans les clusters avec un egress important. L'ajout de points de terminaison VPC pour des services comme S3 et ECR achemine le trafic en privé, contournant entièrement le NAT. La consolidation de plusieurs contrôleurs d'ingress en un seul contrôleur partagé réduit également le nombre de load balancers cloud provisionnés, ce qui abaisse directement les coûts fixes mensuels.
Quelles pratiques de gouvernance soutiennent l'optimisation des coûts Kubernetes ?
Les optimisations techniques se dégradent sans gouvernance. Les équipes reviennent au surprovisionnement lorsqu'il n'y a pas de visibilité sur qui possède quelles dépenses. L'allocation des coûts via le showback et le chargeback donne aux équipes d'ingénierie une visibilité directe sur le coût de leurs charges de travail, ce qui change les comportements plus fiablement que tout document de politique.
La base est un étiquetage cohérent. Chaque espace de noms, déploiement et volume persistant doit porter des étiquettes pour l'équipe, l'environnement et le centre de coûts. L'application de l'étiquetage avec des contrôleurs d'admission comme OPA Gatekeeper ou Kyverno empêche la création de ressources non étiquetées dès le départ. Sans application, la couverture des étiquettes se dégrade avec le temps car les équipes vont vite et sautent l'étiquetage.
Pratiques de gouvernance qui soutiennent les économies :
-
Effectuez des revues de coûts hebdomadaires avec OpenCost ou Kubecost pour mettre en évidence les tendances de dépenses au niveau des espaces de noms.
-
Définissez des alertes budgétaires au niveau de l'espace de noms pour que les équipes reçoivent des notifications avant de dépasser le budget, et non après.
-
Planifiez un nettoyage mensuel des PersistentVolumeClaims orphelines, des espaces de noms inactifs et des ConfigMaps périmées.
-
Assignez un champion FinOps par équipe pour posséder les métriques de coût aux côtés des métriques de fiabilité.
Le changement culturel est aussi important que le réglage technique. Intégrer la responsabilité des coûts dans les revues de sprint et les OKRs d'ingénierie soutient les économies à long terme. Les équipes qui traitent les dépenses cloud comme une métrique d'ingénierie partagée, et non comme un problème financier, surpassent systématiquement celles qui traitent l'optimisation comme un projet ponctuel. La dimension culturelle de l'ingénierie de DevOps est là où réside la discipline durable des coûts.
Conseil d'expert : Commencez par le showback avant le chargeback. Montrer aux équipes leurs coûts sans les facturer d'abord crée une prise de conscience et un engagement. Le chargeback sans contexte crée des frictions et de la résistance plutôt que de l'appropriation.
Points clés
Une optimisation efficace des coûts Kubernetes nécessite d'abord le redimensionnement des demandes de ressources, puis l'ajout de l'autoscaling et du calcul à tarif réduit, et enfin l'intégration de la gouvernance pour empêcher le retour du gaspillage.
| Point | Détails |
|---|---|
| Redimensionnez les demandes des pods en premier | Fixez les demandes à l'utilisation P99 plus 20 % de marge ; utilisez le VPA en mode recommandation avant d'appliquer les changements. |
| Autoscale à chaque couche | Combinez HPA, VPA, KEDA et Karpenter pour adapter la capacité à la demande dynamiquement. |
| Utilisez les instances Spot et Graviton | Spot économise 60–90 % sur les charges de travail éligibles ; Graviton réduit les coûts de calcul d'environ 20 %. |
| Appliquez l'étiquetage et l'allocation | Utilisez OPA Gatekeeper ou Kyverno pour imposer les étiquettes ; exécutez des rapports showback pour construire la responsabilité des équipes. |
| Mesurez avant de couper | Établissez la visibilité des coûts avec OpenCost ou Kubecost avant de faire des changements d'infrastructure. |
Ce que j’ai appris du travail réel sur les coûts Kubernetes
L'erreur la plus courante que je vois les équipes commettre est de sauter directement aux instances Spot ou à la consolidation des load balancers avant de corriger leurs demandes de ressources. Ce sont de vraies économies, mais ce sont des multiplicateurs sur une base de référence brisée. Si vos pods demandent 4 fois ce qu'ils utilisent, la tarification Spot sur ces pods laisse la plupart des gaspillages intacts.
La séquence compte : visibilité d'abord, puis redimensionnement, puis optimisation des tarifs. Les équipes qui suivent cet ordre réalisent systématiquement des réductions plus importantes et plus durables que celles qui poursuivent des gains rapides dans le désordre. J'ai vu des organisations couper leurs factures de moitié en 90 jours en suivant cette séquence, et j'en ai vu d'autres passer des mois à négocier des Instances Réservées tandis que leurs clusters fonctionnaient à 10 % d'utilisation.
Le problème plus difficile est organisationnel. Les ingénieurs ne surprovisionnent pas par négligence. Ils le font parce qu'ils sont mesurés sur la fiabilité, pas sur le coût. Tant que le coût n'apparaît pas dans le même tableau de bord que la disponibilité et la latence, il reste invisible. Les équipes qui maintiennent les économies sont celles qui font du coût une métrique d'ingénierie de premier plan, revue dans la même réunion où elles examinent les SLOs. Ce changement est plus difficile que toute configuration Karpenter, et il compte plus.
— Paul PDG
Ridiculousengineering peut vous aider à réduire les coûts Kubernetes
La réduction des coûts Kubernetes est un défi technique et organisationnel. Bien le relever nécessite une analyse précise des charges de travail, une automatisation bien conçue et des systèmes de gouvernance qui résistent à la pression réelle des équipes d'ingénierie.
Ridiculousengineering travaille avec les responsables IT et les équipes DevOps pour concevoir et construire l'infrastructure cloud, l'automatisation et les outils de gouvernance qui rendent l'efficacité des coûts durable. De l'analyse de redimensionnement aux services d'architecture cloud et DevOps personnalisés, l'équipe apporte à la fois la profondeur technique et l'expérience organisationnelle pour orienter vos dépenses Kubernetes dans la bonne direction. Si vos factures de cluster ne reflètent pas votre charge de travail réelle, cet écart vaut la peine d'être comblé.
FAQ
Quelle est la façon la plus rapide de réduire les coûts Kubernetes ?
Le redimensionnement des demandes de ressources des pods offre les économies les plus rapides. Les équipes voient couramment des réductions de 20–30 % le premier mois en alignant les demandes sur l'utilisation réelle et en supprimant les charges de travail inactives.
En quoi Karpenter diffère-t-il de Cluster Autoscaler ?
Karpenter provisionne les nœuds dynamiquement sur des milliers de types d'instances et prend en charge la consolidation automatisée, réduisant le gaspillage de calcul de 15–30 % par rapport à l'approche statique de groupes de nœuds de Cluster Autoscaler’.
Les instances Spot sont-elles sûres pour les charges de travail Kubernetes de production ?
Les instances Spot sont sûres pour les charges de travail sans état, les jobs batch et les runners CI/CD. Les charges de travail avec état et les bases de données doivent rester sur des nœuds On-Demand pour éviter les perturbations dues aux événements de réclamation Spot.
Quels outils offrent une visibilité sur les coûts Kubernetes ?
OpenCost et Kubecost sont les options open-source et commerciales leaders pour l'allocation des coûts au niveau des espaces de noms. Les deux s'intègrent avec Prometheus et prennent en charge les rapports showback et chargeback.
Comment les étiquettes et les contrôleurs d'admission réduisent-ils le gaspillage Kubernetes ?
Des étiquettes cohérentes permettent une attribution précise des coûts par équipe et environnement. Les contrôleurs d'admission comme OPA Gatekeeper ou Kyverno appliquent l'étiquetage lors de la création des ressources, empêchant l'accumulation de ressources non étiquetées et non suivies.