Modern Data Stack: una roadmap pratica per chi prende decisioni
Modern Data Stack: una roadmap pratica per chi prende decisioni Il modern data stack è un’infrastruttura dati cloud-native basata su ELT/SQL che trasferisce i dati grezzi dai sistemi sorgente a uno stato governato e pronto per l’analisi, ed è attualmente la base più pratica sia per analisi rapide sia per la preparazione all’AI. Se il tuo team sta ancora utilizzando pipeline ETL on-premise, aspetta giorni per i report o si chiede perché i modelli ML continuino a produrre risultati inaffidabili, questa architettura è la risposta diretta.
Modern Data Stack: una roadmap pratica per chi prende decisioni
Il modern data stack è un’infrastruttura dati cloud-native basata su ELT/SQL che trasferisce i dati grezzi dai sistemi sorgente a uno stato governato e pronto per l’analisi, ed è attualmente la base più pratica sia per analisi rapide sia per la preparazione all’AI. Se il tuo team utilizza ancora pipeline ETL on-premise, aspetta giorni per ottenere i report o si chiede perché i modelli ML continuino a produrre risultati inaffidabili, questa architettura è la risposta diretta. I mattoni fondamentali sono l’ELT (caricare prima i dati grezzi e trasformarli nel data warehouse usando SQL), la separazione tra storage e capacità di calcolo e gli strumenti modulari; insieme riducono il carico operativo preservando la cronologia dei dati di cui avranno bisogno i futuri carichi di lavoro AI.
Sommario
-
I componenti fondamentali: cosa fa ogni livello e chi ne è responsabile
-
In che modo uno stack moderno differisce da una piattaforma dati tradizionale?
-
Quali controlli di governance e osservabilità dovresti realizzare fin dal primo giorno?
-
Su quali scelte strategiche dovresti puntare nei prossimi 12–36 mesi?
-
Considerazioni ambientali e di sostenibilità degli stack di dati cloud-native
-
Ridiculous Engineering realizza modern data stack che arrivano davvero in produzione
Che cos’è un modern data stack e cosa lo rende “moderno”?
Il termine viene usato in modo generico, quindi è importante darne una definizione precisa. Un modern data stack sostituisce il monolite ETL legacy con un insieme di servizi gestiti nel cloud, ciascuno responsabile di un livello della pipeline dati e collegati da SQL come interfaccia condivisa. “Moderno” si riferisce a quattro decisioni architetturali specifiche, non a un marchio o a un fornitore.
Principi fondamentali:
-
Servizi gestiti cloud-native. Nessun server da predisporre, nessun cluster del data warehouse da dimensionare in anticipo. La capacità di calcolo si adatta elasticamente e si paga ciò che si utilizza.
-
ELT, non ETL. Carica prima i dati grezzi nel data warehouse, poi trasformali direttamente al suo interno usando SQL. Lo storage dei data warehouse cloud è economico; la capacità di calcolo è elastica e viene fatturata per query. Caricare tutto in formato grezzo preserva la flessibilità: quando i requisiti cambieranno tra sei mesi (succederà), i dati di origine saranno ancora disponibili.
-
SQL come lingua franca. Analisti, analytics engineer e data engineer lavorano tutti nella stessa lingua. I passaggi cognitivi tra la preelaborazione in Python e la reportistica in SQL scompaiono in gran parte.
-
Separazione tra storage e capacità di calcolo. I carichi di lavoro di reporting non competono più con le query ad hoc per la stessa CPU. L’addestramento ML legge le stesse tabelle utilizzate dalla BI senza copiarle. La pianificazione della capacità, il collo di bottiglia dell’era on-premise, in gran parte scompare.
-
Modularità con consolidamento pratico. In teoria ogni livello è sostituibile. In pratica, la direzione del 2026 è avere meno strumenti che fanno di più, non più strumenti che fanno di meno.
Questi principi si collegano direttamente ai risultati aziendali. Il tempo necessario per ottenere insight diminuisce perché gli analisti possono lavorare in autonomia sulle tabelle modellate invece di aspettare che l’IT realizzi i report. I costi diventano più prevedibili quando si utilizza un insieme di strumenti ridotto e disciplinato. E la preparazione all’AI segue naturalmente: dati puliti, governati e accessibili sono il prerequisito affinché qualsiasi modello ML o agente AI produca valore affidabile.
Indicatore dei costi: Un’azienda che utilizza lo stack standard sostiene in genere un budget mensile moderato, che cresce in base alle dimensioni del team e all’utilizzo, con la capacità di calcolo del data warehouse come principale fattore di costo. La variabilità dipende quasi interamente dalla capacità di calcolo del data warehouse, che cresce con il volume delle query e con la disciplina del team nel preferire esecuzioni incrementali rispetto a ricaricamenti completi. Per i team tipici, la spesa mensile varia da 500 a 2.000 dollari per un’azienda di 50 persone e da 5.000 a 20.000 dollari per team del mid-market con 50–200 dipendenti.
I componenti fondamentali: cosa fa ogni livello e chi ne è responsabile
Pensa allo stack analitico come a una pipeline con responsabilità distinte in ogni fase. Confondere i livelli è all’origine della maggior parte degli errori architetturali.
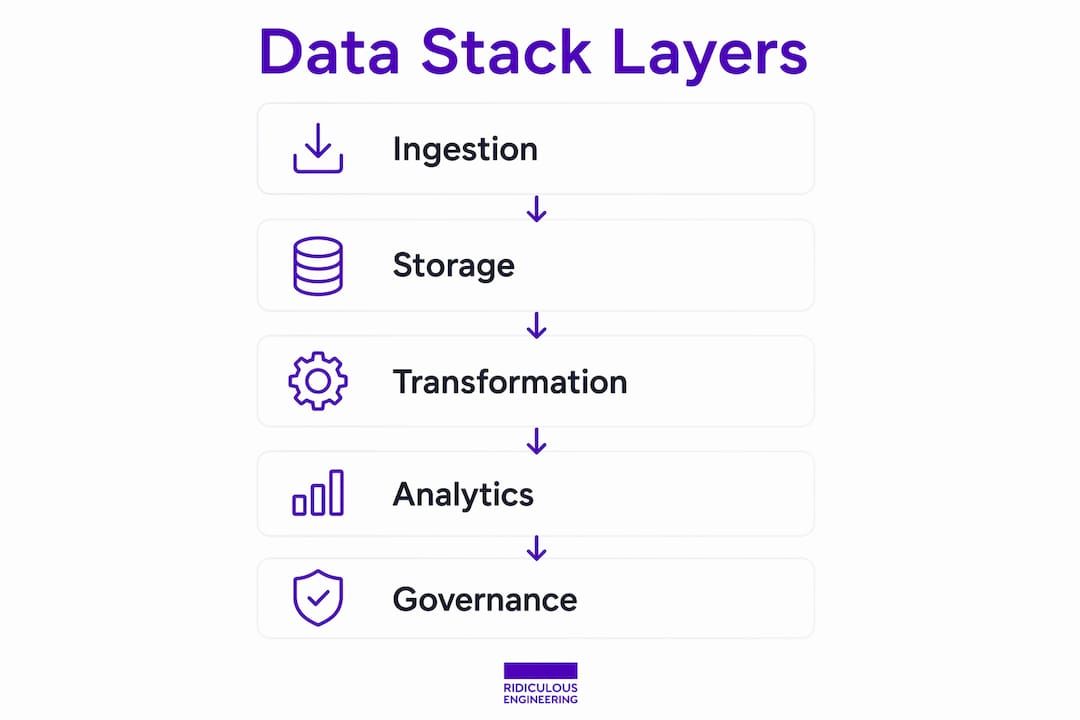
| Livello | Responsabilità | Indicatori chiave / vincoli | Proprietario tipico |
|---|---|---|---|
| Ingestione | Spostare i dati grezzi dalle fonti al data warehouse; gestire il rilevamento dello schema, i caricamenti incrementali e il CDC | Disponibilità dei connettori, gestione dei dati personali, frequenza di sincronizzazione | Data engineer / team della piattaforma |
| Archiviazione / Data warehouse | Archiviare dati grezzi e modellati; eseguire query SQL; scalare il calcolo in modo indipendente | Modello dei costi delle query, concorrenza, supporto ai carichi di lavoro ML | Team della piattaforma |
| Trasformazione | Convertire le tabelle grezze in risorse modellate, testate e documentate usando SQL | Durata dell'esecuzione del modello, strategia incrementale, copertura dei test | Analytics engineer |
| Orchestrazione | Pianificare i DAG, ritentare i fallimenti, inviare avvisi in caso di problemi, bloccare i processi downstream in caso di errore upstream | Complessità delle pipeline, familiarità del team con Python, soluzione gestita o autogestita | Data engineer |
| Qualità dei dati / Osservabilità | Monitorare l'aggiornamento, la deriva dello schema, i tassi di valori nulli e i tassi di superamento dei test; inviare avvisi prima che se ne accorgano gli stakeholder | Sensibilità agli SLA, requisiti dei contratti sui dati | Analytics engineer + team della piattaforma |
| Metriche / Livello semantico | Definire una volta sola le metriche aziendali; esporre valori coerenti in ogni strumento di BI | Governance delle metriche, ambienti BI multi-strumento | Responsabile analytics + proprietari aziendali |
| BI / Analytics | Fornire dashboard, query ad hoc ed esplorazione self-service | Livello tecnico del pubblico, esigenze di incorporamento | Team analytics + proprietari aziendali |
| Reverse ETL / Attivazione | Inviare i dati modellati agli strumenti operativi (CRM, piattaforme di marketing) | Frequenza di sincronizzazione, conformità alla normativa sui dati personali, limiti di frequenza delle API | Data engineer + responsabili delle operazioni marketing/vendite |
| Streaming (quando richiesto) | Gestire l'elaborazione di eventi a bassa latenza quando la cadenza batch è insufficiente | SLA di latenza, frequenza degli eventi, capacità ingegneristica | Piattaforma / data engineering |
È opportuno esplicitare chiaramente alcuni aspetti relativi alle responsabilità. In genere, i proprietari aziendali definiscono il significato delle metriche e approvano le definizioni del livello semantico. I team della piattaforma sono responsabili dell'infrastruttura, dei controlli di accesso e del monitoraggio dei costi. Gli analytics engineer si collocano all'intersezione tra data engineering e analisi, e gli stack moderni spesso prosperano o falliscono proprio in base a questo ruolo. Sono necessari SLA tra i team al confine tra ingestione e data warehouse (chi è responsabile quando si interrompe un connettore della fonte?) e al confine tra trasformazione e BI (chi è responsabile di una metrica errata in una dashboard?).
Dove i team sbagliano più comunemente:
-
Saltare il livello semantico e lasciare che ogni report BI definisca la propria logica delle metriche, producendo numeri discordanti tra i team.
-
Trattare l'orchestrazione come facoltativa finché le pipeline non superano dieci modelli, per poi affrettarsi a integrarla a posteriori.
-
Assegnare l'osservabilità a «chiunque se ne accorga», il che significa a nessuno finché non interviene uno stakeholder.
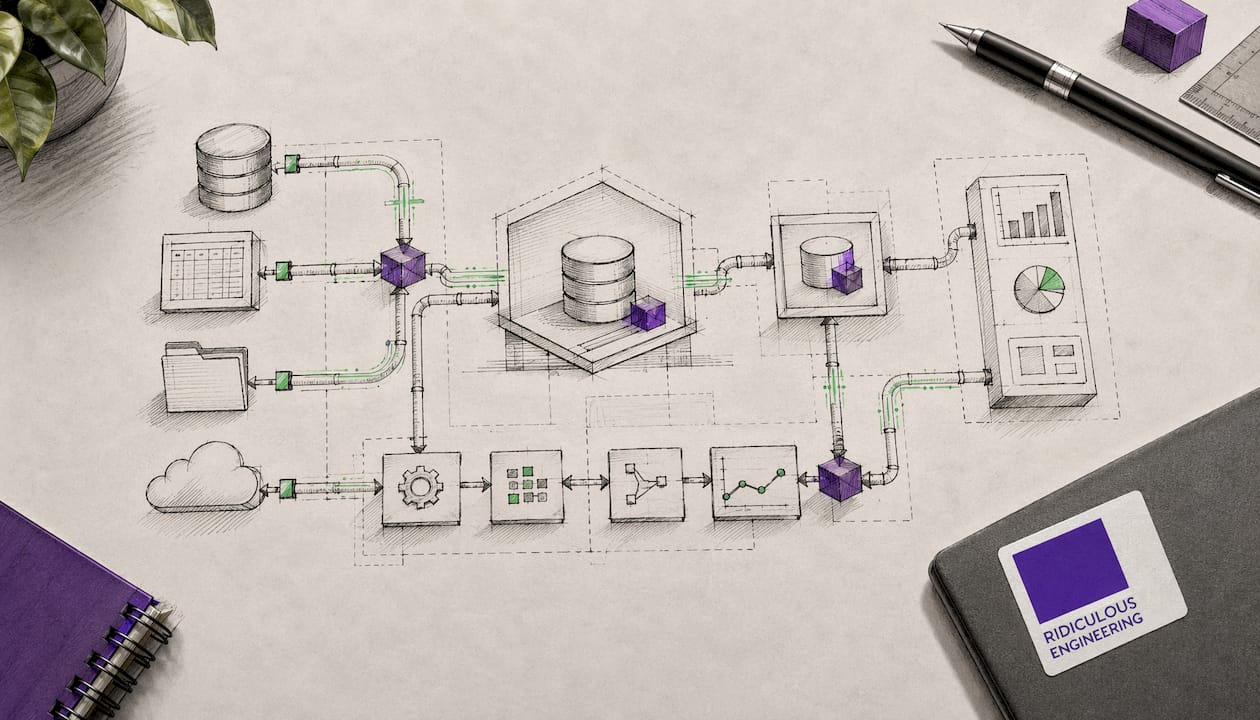
Quale modello architetturale si adatta alla tua situazione?
Centrato sul data warehouse
La scelta predefinita per la maggior parte dei team. Un data warehouse cloud (Snowflake, BigQuery o Databricks SQL) funge da hub. I dati grezzi vi arrivano tramite connettori, dbt li trasforma e gli strumenti di BI li interrogano direttamente. È semplice da gestire, ben documentato e sufficiente per la maggior parte dei carichi di lavoro analitici.
Lakehouse
Formati di tabelle aperti come Apache Iceberg e Delta Lake risiedono su storage a oggetti (S3, GCS, ADLS) e supportano sia l'analisi SQL sia l'addestramento ML sugli stessi dati fisici. I modelli lakehouse riducono il vincolo verso un fornitore per i formati di storage e sono la scelta giusta quando i carichi di lavoro ML sono una componente di primo livello accanto alla BI. Databricks è il punto di ingresso più comune; il supporto di Snowflake per Iceberg ha ridotto considerevolmente il divario.
Ibrido
Un data warehouse gestisce l'analisi governata; un lakehouse o un data lake gestisce la sperimentazione ML e l'archiviazione di dati grezzi su larga scala. Maggiore complessità operativa, ma appropriato per le organizzazioni in cui i team ML e analitici hanno esigenze realmente diverse e sufficiente capacità ingegneristica per mantenere entrambi.
Componenti aggiuntivi per lo streaming
Lo stack moderno è innanzitutto batch. Le architetture di streaming (Kafka più Flink o Spark Streaming) vengono in genere eseguite insieme al data warehouse anziché sostituirlo. La proposta di «batch e streaming unificati» viene decantata da anni; nella pratica, i sistemi in tempo reale coesistono con il data warehouse e raramente condividono codice con esso. Introduci lo streaming solo quando un SLA di latenza lo richiede realmente, non perché suona impressionante. Per un'analisi più approfondita di quando i modelli in tempo reale risultano vantaggiosi, i modelli di dati in tempo reale meritano una revisione prima di impegnarsi nei costi dell'infrastruttura.
Consiglio pratico: Inizia con il modello centrato sul data warehouse. Aggiungi un livello lakehouse solo quando i carichi di lavoro ML sono pronti per la produzione e il team dispone di un platform engineer dedicato alla gestione del formato di tabella aperto. Aggiungi lo streaming solo quando un processo aziendale ha un SLA di latenza documentato inferiore a cinque minuti che il batch non è in grado di soddisfare.
In cosa differisce uno stack moderno da una piattaforma dati tradizionale?
Il contrasto è più netto di quanto riconosca la maggior parte delle proposte di migrazione.
Differenze principali:
-
Modello di distribuzione. Le piattaforme legacy vengono eseguite on-premise o su macchine virtuali autogestite. Gli stack moderni usano servizi cloud completamente gestiti, senza infrastruttura da predisporre.
-
ETL vs. ELT. L'ETL legacy trasforma i dati prima che raggiungano il data warehouse, spesso tramite strumenti proprietari con un controllo delle versioni limitato. L'ELT carica prima i dati grezzi e li trasforma all'interno del data warehouse usando SQL in Git.
-
Monolitico vs. modulare. Le piattaforme legacy riuniscono acquisizione, trasformazione e distribuzione in un unico prodotto. Gli stack moderni li separano, consentendo una scalabilità indipendente e una responsabilità distinta tra i team.
-
Modello di scalabilità. I sistemi on-premise richiedono pianificazione della capacità e approvvigionamento hardware. I data warehouse cloud aumentano la capacità di calcolo in pochi secondi.
-
Reporting self-service vs. controllato dall'IT. I sistemi legacy richiedono in genere che l'IT crei ogni report. Gli stack moderni espongono le tabelle modellate direttamente ad analisti e utenti aziendali.
I cambiamenti architetturali che lo hanno reso possibile sono arrivati in sequenza: lo storage cloud a oggetti ha reso economica la conservazione dei dati grezzi, i data warehouse cloud hanno separato il calcolo dallo storage e dbt ha portato la logica di trasformazione in Git. Questi tre cambiamenti, avvenuti approssimativamente tra il 2016 e il 2020, hanno reso lo stack moderno praticabile per i team privi di grandi budget infrastrutturali.
Antimodelli di migrazione da evitare: Il lift-and-shift senza refactoring (si ottengono costi cloud con un'architettura on-premise), caricamenti incrementali incontrollati che duplicano silenziosamente i record e l'omissione della configurazione della governance con l'idea di aggiungerla in seguito. Non lo farai, finché un incidente non ti costringerà a farlo.
Le piattaforme legacy comportano rischi operativi concreti: le modifiche allo schema rompono i report downstream senza alcuna lineage per tracciarne l'impatto, i vincoli di capacità creano code per la reportistica e le stored procedure accumulano debito tecnico che nessuno vuole toccare. I vantaggi del cloud computing dell'approccio moderno non sono teorici; si manifestano nella riduzione del carico di reperibilità e in cicli di iterazione più rapidi.
Quali strumenti dovresti usare concretamente?
L'ELT con SQL nel data warehouse ha standardizzato il livello di trasformazione e dbt è lo strumento predefinito per gestire i modelli SQL. Il resto dello stack offre più opzioni, ma l'euristica di selezione è coerente: scegli uno strumento per livello, preferisci i servizi gestiti a quelli autogestiti quando la capacità del team è limitata e pianifica i controlli FinOps fin dal primo giorno.
| Livello | Strumenti rappresentativi | Ideale per / note |
|---|---|---|
| Acquisizione | Fivetran, Airbyte, AWS Glue, Azure Data Factory | Fivetran: gestito, molti connettori, operatività minima; Airbyte: opzione open source; Glue/ADF: per organizzazioni native AWS/Azure |
| Data warehouse | Snowflake, Google BigQuery, Databricks | Snowflake: analisi intensive, governance solida; BigQuery: costi su larga scala, serverless; Databricks: carichi di lavoro intensivi di machine learning |
| Trasformazione | dbt (Cloud o Core), SQLMesh | dbt è lo standard; SQLMesh è l’alternativa emergente per esecuzioni consapevoli dello stato |
| Orchestrazione | Apache Airflow, Dagster, Prefect | Airflow è in testa per numero di implementazioni; Dagster sta guadagnando terreno per i flussi di lavoro basati sugli asset; Prefect per i team orientati a Python |
| Qualità dei dati / Osservabilità | Test dbt, Monte Carlo, Soda | I test dbt coprono la maggior parte delle esigenze iniziali; Monte Carlo e Soda per il monitoraggio degli SLA in produzione |
| Metriche / Livello semantico | Livello semantico dbt, Cube | Definisci le metriche una sola volta; rendile disponibili a più strumenti di BI |
| BI / Analisi | Looker, Tableau, Power BI, Metabase | Looker per la governance delle metriche; Metabase per un self-service esteso; Tableau/Power BI per la reportistica direzionale |
| Reverse ETL / Attivazione | Census, Hightouch | Invia i dati modellati a CRM, piattaforme pubblicitarie e strumenti operativi |
| Streaming | Apache Kafka, Apache Flink, RisingWave | In parallelo al data warehouse; introdurlo solo quando lo SLA di latenza lo richiede |
Criteri di selezione per le organizzazioni statunitensi:
-
Se il tuo team ha meno di tre ingegneri dei dati, scegli l’acquisizione gestita (Fivetran) e dbt Cloud invece delle alternative autogestite. Il risparmio operativo supera il costo delle licenze.
-
Snowflake e BigQuery sono entrambi ottime scelte predefinite; la decisione dipende solitamente dai rapporti esistenti con i provider cloud e dal fatto che i carichi di lavoro di machine learning siano prioritari.
-
Una proliferazione di strumenti con otto o più strumenti SaaS crea notevoli difficoltà operative e di costo. Nella pratica, molti team si riducono a quattro componenti principali: data warehouse, dbt, un orchestratore e uno strumento di BI.
-
Apache Airflow è importante da comprendere a livello concettuale, ma eseguirlo su Kubernetes richiede un team dedicato di ingegneria della piattaforma. Airflow gestito (Cloud Composer, MWAA, Astronomer) è la scelta pratica per la maggior parte dei team.
Quali controlli di governance e osservabilità dovresti creare fin dal primo giorno?
La governance implementata dopo un incidente è sempre più costosa della governance integrata fin dall’inizio. Lo stesso vale per l’osservabilità. Trattale entrambe come funzionalità del prodotto con i propri SLA, non come semplici caselle di conformità da spuntare.
Pilastri fondamentali della governance:
-
Controllo degli accessi con il minimo privilegio. Controllo degli accessi basato sui ruoli a livello di data warehouse, con ruoli separati per dati grezzi, dati modellati e colonne contrassegnate come PII. Nessun analista dovrebbe avere accesso in scrittura agli schemi grezzi.
-
Genealogia e catalogazione dei dati. La genealogia integrata di dbt copre il livello di trasformazione. Estendila a monte (sistemi di origine) e a valle (report BI) con uno strumento di catalogazione o con le funzionalità di metadati native del data warehouse.
-
Individuazione e mascheramento delle PII. Contrassegna le colonne PII al momento dell’acquisizione. Applica policy di mascheramento dinamico nel data warehouse, in modo che i modelli a valle non espongano mai PII grezze a ruoli non autorizzati.
-
Registrazione degli audit. Ogni query, ogni modifica dello schema, ogni concessione di ruolo dovrebbe essere registrata. La maggior parte dei data warehouse cloud offre questa funzionalità nativamente; abilitala prima di entrare in produzione.
-
Governance delle metriche. Definisci le metriche aziendali nel livello semantico, non nei singoli report BI. Quando “ricavi” significa la stessa cosa ovunque, non dovrai più partecipare alla riunione in cui due team discutono su quale sia il numero corretto.
Per l’osservabilità, le metriche principali da monitorare sono la freschezza (quando è stato aggiornato l’ultima volta questo table?), la deriva dello schema (è scomparsa una colonna della fonte?), i tassi di valori nulli (un campo critico è improvvisamente vuoto?) e i tassi di superamento dei test dbt. Configura gli avvisi su questi aspetti prima che se ne accorgano gli stakeholder. La qualità dei dati è direttamente correlata all’affidabilità dei modelli di IA, quindi l’osservabilità non è solo una questione operativa; è un investimento nella preparazione all’IA.
Esempi di misure di salvaguardia delle policy da adottare fin dall’inizio: solo gli ingegneri della piattaforma possono eseguire modelli dbt con aggiornamento completo in produzione; le modifiche allo schema nei sistemi sorgente richiedono un preavviso di 48 ore e una revisione dell’impatto sui sistemi downstream; le colonne PII richiedono l’approvazione del responsabile dei dati prima che qualsiasi nuovo modello vi faccia riferimento.
Consiglio utile: Integra il monitoraggio FinOps nel tuo stack di osservabilità fin dal primo giorno. Un singolo aggiornamento completo di dbt non monitorato o una risincronizzazione del connettore in seguito a una modifica dello schema può far aumentare di dieci volte la fattura del data warehouse in una settimana. Configura avvisi sui costi delle query e budget per i crediti del warehouse prima di integrare la tua prima pipeline di produzione. I framework di governance cloud forniscono un modello di policy utile a questo scopo.
Per gli stack con funzionalità di intelligenza artificiale, le considerazioni sulla sicurezza vanno oltre l’accesso ai dati. I rischi per la sicurezza dell’IA agentica sono una preoccupazione emergente di governance che i team della piattaforma dati dovrebbero comprendere prima di esporre dati governati agli agenti di IA.
Come si pianifica e si costruisce uno stack di dati moderno?
Roadmap delle fasi
Fase 1: Scoperta (settimane 1–4). Verifica le fonti di dati esistenti, identifica le tre-cinque domande aziendali a cui lo stack deve rispondere fin dal primo giorno e documenta gli attuali flussi di dati. Risultato: un inventario delle fonti e un elenco prioritario dei casi d’uso.
Fase 2: Progetto pilota MVP (settimane 5–12). Configura un warehouse, un connettore di acquisizione per la fonte con la priorità più alta, un progetto dbt con cinque-dieci modelli e una dashboard BI. Risultato: una pipeline funzionante e testata che risponde end-to-end a una domanda aziendale.
Fase 3: Espansione (mesi 4–9). Aggiungi connettori per le restanti fonti prioritarie, sviluppa il livello dei modelli dbt, introduci l’orchestrazione quando le pipeline superano i dieci modelli e aggiungi il monitoraggio dell’osservabilità. Risultato: uno stack pronto per la produzione che copre i dieci principali casi d’uso.
Fase 4: Messa in operatività (mesi 10–18). Formalizza le policy di governance, implementa il livello semantico, definisci i controlli FinOps e documenta gli SLA. Risultato: uno stack che il team può mantenere ed estendere senza interventi straordinari.
Ruoli e dimensionamento del team
| Ruolo | Responsabilità | Team piccolo (1–5 persone dedicate ai dati) | Mercato intermedio (5) | Enterprise (grande) |
|---|---|---|---|---|
| Ingegnere analytics | Modelli dbt, qualità dei dati, livello semantico | 1 (condiviso con mansioni di analista) | 2–4 | 4–8 |
| Ingegnere dei dati | Acquisizione, orchestrazione, gestione operativa della piattaforma | 1 (condiviso) | 2–4 | 4–10 |
| Piattaforma / infrastruttura dati | Amministrazione del data warehouse, sicurezza, FinOps | Condiviso con il data engineer | 1–2 dedicati | 2–5 dedicati |
| Analytics / BI | Sviluppo di dashboard, supporto agli stakeholder | 1 (condiviso) | 2–4 | 4–10 |
| Governance dei dati / sicurezza | Policy, controllo degli accessi, conformità | Condiviso con il team della piattaforma | 1 part-time | 1–2 dedicati |
Per indicazioni sull'organico necessario a costruire team di dati pronti per l'IA, strategia dei talenti per organizzazioni pronte per l'IA copre le lacune di competenze che la maggior parte dei team sottovaluta.
Checklist di implementazione
-
Seleziona e stipula il contratto per il tuo data warehouse (Snowflake, BigQuery o Databricks) e configura gli avvisi di fatturazione prima che vi arrivino dati.
-
Acquista un servizio di ingestion gestito (Fivetran o equivalente) e documenta gli SLA dei connettori con i responsabili dei sistemi sorgente.
-
Configura un account dbt Cloud e un repository Git; stabilisci la protezione dei branch e i controlli CI sui modelli dbt.
-
Definisci il controllo degli accessi basato sui ruoli nel data warehouse prima di caricare dati adiacenti a informazioni personali identificabili (PII).
-
Configura il monitoraggio dei costi delle query e imposta una soglia di budget mensile che attivi un avviso all'80% di utilizzo.
-
Documenta i criteri di accettazione per il go-live: percentuale minima di test superati, SLA di aggiornamento per ogni tabella e approvazione degli stakeholder su almeno una dashboard end-to-end.
-
Pianifica una revisione a 30 giorni dal lancio per valutare l'affidabilità delle pipeline, i costi effettivi rispetto alle stime e la capacità del team.
Fattori che determinano la stima dei costi: Il calcolo del data warehouse è la variabile dominante e cresce con il volume delle query e la frequenza di esecuzione dei modelli. I costi dei connettori crescono con il numero di origini e la frequenza di sincronizzazione. Le policy di conservazione dei dati incidono moderatamente sui costi di storage. Una strategia dbt incrementale disciplinata, rispetto alle esecuzioni con aggiornamento completo, può ridurre sostanzialmente i costi di calcolo del data warehouse sulle tabelle di grandi dimensioni.
Quali scelte strategiche dovresti fare nei prossimi 12–36 mesi?
Consolidamento verso funzionalità native del data warehouse
Il mercato si sta orientando verso un numero inferiore di piattaforme più capaci. Snowflake ha aggiunto Snowpark e Streamlit. Databricks ha aggiunto Delta Live Tables e un orchestratore. Microsoft Fabric raggruppa ingestion, trasformazione e BI in un unico rapporto di fatturazione. Il calcolo alla base degli acquisti sta cambiando: il sovraccarico d'integrazione e otto rapporti di fatturazione SaaS separati rappresentano di per sé una forma di difficoltà operativa. Per la maggior parte dei team, lo stack giusto nel 2026 è più compatto della versione canonica: un data warehouse, dbt, un orchestratore, uno strumento BI.
L'argomentazione contraria è che gli strumenti best-of-breed continuano a superare gli equivalenti nativi del data warehouse nei singoli livelli. Spesso è vero. La domanda è se il divario prestazionale giustifichi il costo d'integrazione. Per i team con una capacità limitata di ingegneria della piattaforma, di solito non lo giustifica. Per modelli di condivisione e consolidamento dei dati, i vantaggi operativi derivanti da un minor numero di punti d'integrazione sono ben documentati.
La preparazione all'IA come obiettivo progettuale di primo livello
La preparazione all'IA non è una funzionalità da aggiungere a uno stack di dati; è una conseguenza della corretta realizzazione dello stack fin dall'inizio. I prerequisiti sono la qualità dei dati (testati, monitorati, affidabili), la lineage (tracciabile dall'origine al modello fino all'output) e un dataset centrale piccolo e ben governato, di cui gli agenti IA possano fidarsi. I vector store e i feature store sono rilevanti per casi d'uso specifici di ML, ma si basano su un data warehouse ben governato, non lo sostituiscono. Preparazione operativa all'IA generativa dipende dalla stessa base dati.
Consiglio pratico: Prima di investire in un database vettoriale o in un feature store, verifica la copertura dei test sui modelli dbt esistenti. Se la percentuale di test superati è inferiore al 90% sui modelli critici, gli output dell'IA basati su quei dati saranno inaffidabili, indipendentemente dalla sofisticazione del modello. Correggi prima le fondamenta.
Quando assumere e quando coinvolgere un consulente
Assumi un ingegnere della piattaforma dedicato quando il numero delle pipeline supera 20 e il tuo data engineer dedica più del 30% del proprio tempo all'infrastruttura anziché al lavoro sui dati. Rivolgiti a un partner esterno come Ridiculous Engineering quando devi comprimere i tempi dalla fase di discovery all'MVP, quando ti manca esperienza interna di architettura per la progettazione iniziale o quando un audit di governance o di preparazione all'IA richiede una prospettiva esterna. Il compromessi del consolidamento SaaS tra servizi gestiti e opzioni self-hosted meritano di essere compresi prima di assumere impegni a lungo termine con i fornitori.
Considerazioni ambientali e di sostenibilità degli stack di dati cloud-native
Gli stack di dati cloud-native hanno un'impronta ambientale reale, che vale la pena comprendere prima di impegnarsi per una configurazione di warehouse e calcolo. I principali provider cloud (AWS, Google Cloud, Microsoft Azure) hanno pubblicato impegni di neutralità carbonica o di zero emissioni nette, e i loro data center hyperscale operano generalmente con un'efficienza energetica superiore rispetto alle alternative on-premise. Questo vantaggio in termini di efficienza è reale, ma non rende il calcolo cloud privo di emissioni di carbonio.
Le principali leve per ridurre l'impatto ambientale di uno stack di dati sono l'efficienza del calcolo e una gestione disciplinata della conservazione dei dati. Modelli dbt scritti male che eseguono full refresh su tabelle di grandi dimensioni sprecano risorse di calcolo; i modelli incrementali che elaborano solo i nuovi record utilizzano una frazione delle risorse. Dashboard inutilizzate che attivano query pianificate, connettori sincronizzati a intervalli di cinque minuti quando sarebbe sufficiente una frequenza giornaliera e warehouse lasciati in esecuzione senza sospensione automatica contribuiscono tutti a un consumo energetico non necessario. I controlli FinOps che riducono i costi riducono anche le emissioni di carbonio, facendo convergere il caso aziendale e quello della sostenibilità nella stessa direzione.
Anche le policy di conservazione dei dati sono importanti. Archiviare ogni evento grezzo indefinitamente in un warehouse è costoso e ad alta intensità energetica. L'archiviazione a più livelli (dati frequenti nel warehouse, dati freddi nell'object storage) riduce sia i costi sia il sovraccarico di calcolo per i dati storici interrogati raramente. I team che considerano la conservazione dei dati una decisione di governance anziché un'impostazione predefinita tendono a gestire stack più snelli, economici e a minore impatto.
Punti chiave
Un moderno stack di dati basato su ELT, trasformazioni SQL-first e servizi gestiti cloud-native è la base più pratica per analisi rapide e preparazione all'IA nel 2026.
| Voce | Dettagli |
|---|---|
| Inizia in piccolo e mantieni la disciplina | Per la maggior parte dei team, uno stack di 4 strumenti (warehouse + dbt + 1 orchestratore + 1 strumento BI) supera un insieme di 8 strumenti. |
| Prevedi variazioni nei costi di calcolo | Per la maggior parte dei team, la spesa mensile è di 500–2.000 $ per aziende di 50 persone e di 5.000–20.000 $ per aziende mid-market (50–200 dipendenti); il calcolo del warehouse è il principale fattore di costo. |
| Governance fin dal primo giorno | L'accesso con privilegi minimi, il mascheramento dei dati personali e gli avvisi FinOps devono essere configurati prima che i dati di produzione arrivino, non dopo un incidente. |
| La preparazione all'IA richiede innanzitutto la qualità dei dati | La copertura dei test, la lineage e il monitoraggio della freschezza sui modelli dbt sono prerequisiti per ottenere risultati affidabili dall'IA. |
| Ridiculous Engineering accelera l'adozione | Ridiculous Engineering fornisce audit di discovery, progettazione di MVP, ingegneria della piattaforma e configurazione della governance per ridurre il tempo fino alla produzione. |
Ridiculous Engineering realizza stack di dati moderni che arrivano davvero in produzione
La maggior parte dei team che ha difficoltà con l'infrastruttura dei dati non è priva di ambizione. È priva di tempo, esperienza di architettura o di entrambe. Ridiculous Engineering è una società di consulenza di ingegneria del software con sede in Colorado che progetta, realizza e rende operativi sistemi di dati e analisi per organizzazioni che hanno bisogno di uno stack di livello produttivo senza dover attendere sei mesi per renderlo operativo. Il modello di collaborazione è pratico: un audit di discovery mirato per mappare le fonti e i casi d'uso, una progettazione MVP che porta a una pipeline funzionante in poche settimane e supporto di ingegneria della piattaforma per completare governance, configurazione FinOps e valutazione della preparazione all'IA. Se il tuo team dispone del talento necessario ma ha bisogno di una guida architetturale, un breve incarico di consulenza è spesso sufficiente per evitare gli errori più costosi. Contatta Ridiculous Engineering per definire un incarico di discovery.
Fonti utili
-
Il moderno stack di dati, valutato con onestà — La valutazione pratica più diretta dell'architettura a 5 livelli, dei suoi compromessi e della direzione del consolidamento nel 2026. Fonte primaria per gli intervalli di costo, le impostazioni predefinite degli strumenti e i limiti dello streaming citati in questo articolo.
-
Come creare un moderno stack di dati nel 2026 — Guida pratica che tratta il predominio di ELT/SQL, dbt come impostazione predefinita per le trasformazioni e le opzioni di orchestrazione. Utile per definire la sequenza di implementazione.
-
Moderno stack di dati 2026: guida completa a strumenti e architettura — Modelli architetturali che includono lakehouse e formati di tabelle aperti; panoramica degli strumenti di orchestrazione con Airflow, Dagster e Prefect.
-
Che cos'è un moderno stack di dati e perché è importante — Panoramica di ThoughtSpot che collega la qualità dei dati e l'osservabilità alla preparazione all'IA. Utile per le sezioni sulla governance e sulla preparazione all'IA.
-
Architettura di una moderna piattaforma dati: costruire uno stack di dati scalabile — Approfondimento tecnico sulla separazione tra storage e calcolo e sull'SQL come interfaccia condivisa.
-
AWS Glue — Documentazione primaria del fornitore per l'integrazione serverless dei dati su AWS; riferimento per le opzioni di ingestione native AWS e per le pipeline ELT.
-
Azure Data Factory — Documentazione del servizio gestito di integrazione dei dati di Microsoft; riferimento per la configurazione dell'ingestione nativa Azure e delle pipeline ELT/ETL.
-
Apache Software Foundation — Fonte primaria per la documentazione di Apache Airflow, Apache Kafka, Apache Flink, Apache Iceberg e Apache Hudi.
-
Ridiculous Engineering: Cloud computing per la crescita aziendale — Linee guida sull'architettura e sulla strategia cloud per i leader tecnologici che progettano un'infrastruttura dati moderna.
-
Ridiculous Engineering: Comprendere l'IA e la qualità dei dati — Spiega il legame tra qualità dei dati, osservabilità e affidabilità dei modelli di IA.
FAQ
Che cos'è uno stack di dati moderno?
Uno stack di dati moderno è un'infrastruttura dati cloud-native basata su ELT/SQL, che acquisisce dati grezzi dai sistemi di origine, li archivia in un data warehouse cloud o in un lakehouse, li trasforma usando SQL (in genere con dbt) e li rende disponibili agli strumenti di BI e ai carichi di lavoro di IA. Le caratteristiche distintive sono i servizi cloud gestiti, la separazione tra archiviazione e calcolo e una logica di trasformazione sottoposta al controllo delle versioni.
L'idea dello stack di dati moderno è ancora utile?
Sì, i principi fondamentali sono consolidati e rappresentano ancora l'approccio giusto: servizi cloud-native, ELT, trasformazione basata su SQL e separazione tra archiviazione e calcolo. Ciò che sta cambiando è la composizione degli strumenti. L'assemblaggio dei migliori otto strumenti sta lasciando il posto al consolidamento nativo del data warehouse, quindi nel 2026 lo stack moderno è generalmente composto da quattro strumenti, non otto.
Qual è la differenza tra uno stack di dati tradizionale e uno moderno?
Le piattaforme tradizionali usano l'ETL (trasformazione prima del caricamento), funzionano su infrastrutture locali o autogestite e richiedono che l'IT crei ogni report. Gli stack moderni usano l'ELT (caricamento dei dati grezzi e trasformazione nel data warehouse con SQL), funzionano su servizi cloud gestiti ed espongono i dati modellati direttamente agli analisti per l'uso autonomo. Il modello operativo e dei costi è fondamentalmente diverso.
Quali strumenti per gli stack di dati sono di tendenza nel 2026?
Le scelte predefinite sono Snowflake o Google BigQuery per il data warehouse, dbt per la trasformazione, Apache Airflow (o Dagster per i nuovi progetti) per l'orchestrazione e Fivetran per l'acquisizione gestita. La tendenza più ampia è il consolidamento: le funzionalità native del data warehouse stanno riducendo la necessità di strumenti separati e specializzati per ogni livello.
Quanto costa al mese uno stack di dati moderno?
Un'azienda che utilizza lo stack standard spende in genere da 500 a 2.000 dollari al mese per un team di 50 persone e da 5.000 a 20.000 dollari per un'azienda del mercato intermedio (da 50 a 200 dipendenti), con costi determinati principalmente dal calcolo del data warehouse, che aumenta in base alle dimensioni del team e all'utilizzo.
Consigliati
-
Crescita trasformativa con il cloud computing | Ridiculous Engineering | Ridiculous Engineering
-
Strategia di architettura componibile 2026 | Ridiculous Engineering
-
Creare il web moderno: tecnologia CMS headless | Ridiculous Engineering
-
Sette lezioni che il COVID-19 ci ha insegnato sulla strategia dei dati | Ridiculous Engineering