Salesforce Integration : Guide des modèles, API et architecture
Salesforce Integration : Guide des modèles, API et architecture La bonne approche d'intégration Salesforce dépend de trois éléments que vous devez définir avant de toucher à une seule API : votre intention d'intégration (orchestration de processus, synchronisation de données ou accès virtuel/zéro copie), votre exigence de latence (inférieure à la seconde, quasi temps réel ou par lots) et votre volume de données. Pour des expériences client en temps réel, les modèles pilotés par événements utilisant Platform Events ou Change Data Capture sont généralement la bonne solution. Pour l'analytique et l'accès à l'entrepôt de données sans construire de pipeline de réplication,
Salesforce Integration : Guide des modèles, API et architecture
La bonne approche d'intégration Salesforce dépend de trois éléments que vous devez définir avant de toucher à une seule API : votre intention d'intégration (orchestration de processus, synchronisation de données ou accès virtuel/zéro copie), votre exigence de latence (inférieure à la seconde, quasi temps réel ou par lots) et votre volume de données. Pour des expériences client en temps réel, les modèles pilotés par événements utilisant Platform Events ou Change Data Capture sont généralement la bonne solution. Pour l'analytique et l'accès à l'entrepôt de données sans construire de pipeline de réplication, Data 360 zéro copie mérite une sérieuse considération. Pour la synchronisation inter-organisations à grande échelle, Bulk API avec une couche middleware comme MuleSoft Anypoint gère la charge sans épuiser votre budget d'API synchrone.
Avant de choisir un outil, passez en revue cette liste de cinq questions :
- Intention d'intégration : Synchronisez-vous des données, orchestrez-vous un processus ou fédérez-vous l'accès à une source externe ?
- Latence requise : L'entreprise a-t-elle besoin d'une latence inférieure à la seconde, quasi temps réel (moins de 15 minutes), ou un traitement par lots nocturne est-il acceptable ?
- Volume de données : Déplacez-vous des centaines d'enregistrements ou des dizaines de millions ?
- Source unique de vérité : Quel système possède chaque type d'enregistrement, et qui gagne en cas de conflit ?
- Limites d'API : Quelle est la consommation actuelle d'API de votre organisation et quelle marge de manœuvre avez-vous ?
Astuce de pro : Cartographiez uniquement les flux critiques pour l'entreprise avant de choisir la technologie. Le piège du « tout en temps réel » est coûteux et généralement inutile — la plupart des processus métier tolèrent un décalage de 15 minutes sans problème, et les traiter comme des problèmes de streaming ajoute coût et complexité sans bénéfice mesurable.
Points clés à retenir
Choisir le bon modèle d'intégration Salesforce nécessite de définir votre intention d'intégration, votre exigence de latence et votre volume de données avant de sélectionner une API ou un outil.
| Point | Détails |
|---|---|
| Définir l'intention d'abord | Classez chaque flux comme processus, synchronisation de données ou accès virtuel avant de choisir une API ou un outil. |
| Adapter l'API au volume | Utilisez REST pour moins de ~10 000 enregistrements et les appels interactifs ; utilisez Bulk API 2.0 pour tout volume plus important. |
| Préférer les événements au sondage | Platform Events et CDC propagent les modifications efficacement ; le sondage gaspille le quota d'API et ajoute de la latence. |
| Utiliser Data 360 pour l'accès à l'entrepôt de données | La fédération zéro copie interroge Snowflake, Databricks, Redshift et BigQuery sans pipelines de réplication. |
| Appliquer le moindre privilège et l'observabilité | Limitez strictement les utilisateurs d'intégration, utilisez Named Credentials et définissez des alertes d'utilisation d'API avant la mise en production. |
| Ridiculous Engineering | Conçoit et construit des architectures d'intégration de niveau production, de la conception pilotée par API à la zéro copie Data 360 et la synchronisation inter-organisations. |
Table des matières
- Ce que couvre l'intégration Salesforce en 2026
- Modèles d'intégration de base et comment choisir entre eux
- Quelle API Salesforce ou fonctionnalité de plateforme correspond à chaque travail d'intégration
- Quand utiliser middleware, Data 360, Heroku Connect et les connecteurs low-code
- Synchrone vs asynchrone, piloté par événements vs par lots, entrant vs sortant
- Mappage de données, transformations, résolution d'identité et source unique de vérité
- Applications connectées, flux OAuth, autorisations et gouvernance de l'intégration
- Limites API, anti-modèles, nouvelles tentatives, idempotence et stratégies de volume
- Stratégie de test, étapes de déploiement et ce qui détermine les délais et coûts d'intégration
- Liste de contrôle pratique et pièges courants à éviter
- Comment Ridiculous Engineering peut vous aider avec votre architecture d'intégration
- Sources
- FAQ
Ce que couvre l'intégration Salesforce en 2026
L'intégration Salesforce est le plan architectural et l'ensemble d'outils que vous utilisez pour déplacer, accéder et coordonner les données et les processus entre Salesforce et d'autres systèmes. Cette définition semble simple, mais la plateforme s'est considérablement élargie, et les options couvrent désormais un large spectre d'intention, de synchronisation et de complexité technique.
Trois intentions d'intégration distinctes motivent la plupart des projets :
- Synchronisation des données : Réplication ou synchronisation des enregistrements entre Salesforce et un système externe pour que les deux restent cohérents. Cela inclut l'ETL planifié, la synchronisation incrémentale basée sur CDC et les outils déclaratifs comme CRM Analytics SyncIn/SyncOut.
- Intégration des processus : Orchestration de la logique métier entre les systèmes, déclenchement de workflows et coordination des appels API. MuleSoft Anypoint et les services REST Apex personnalisés en font partie.
- Accès virtuel/zéro copie : Interrogation des données externes à l'exécution sans les copier dans Salesforce. Salesforce Data 360 et Salesforce Connect sont les principaux outils.
Les capacités de la plateforme les plus importantes en 2026 incluent :
- API REST pour les opérations CRUD et les appels web/mobiles interactifs
- API SOAP pour les intégrations fortement typées, pilotées par WSDL avec les systèmes hérités
- API Bulk 2.0 pour les chargements et extractions de gros volumes
- API Streaming et API Pub/Sub pour la livraison d'événements à haut débit
- Événements de plateforme pour la messagerie événementielle découplée et durable
- Capture des modifications de données (CDC) pour les notifications de changement quasi en temps réel sur les enregistrements Salesforce
- Salesforce Data 360 (zéro copie) pour l'accès aux requêtes fédérées vers Snowflake, Databricks, Redshift et BigQuery
- Salesforce Connect pour afficher des objets externes sans réplication
- Heroku Connect pour la synchronisation bidirectionnelle entre Salesforce et Heroku Postgres
- MuleSoft Anypoint pour la gestion des API d'entreprise et l'orchestration complexe
Le compromis fondamental qui traverse chaque décision : une latence plus faible signifie généralement une complexité et des coûts plus élevés. La réplication offre des requêtes locales rapides mais crée un risque de dérive. La fédération maintient les données à jour mais ajoute de la latence au moment des requêtes et une dépendance à la disponibilité des systèmes externes. Comprendre les choix de stratégie d'intégration entre fédération et réplication est souvent la première véritable décision architecturale sur un projet.
Les modèles d'intégration de base et comment choisir entre eux
Les modèles d'architecture ne sont pas seulement des catégories académiques. Chacun comporte une charge de maintenance, une surface de défaillance et un modèle de gouvernance différents. Choisir le mauvais modèle dès le départ est l'une des erreurs les plus coûteuses qu'une équipe puisse commettre.
Point à point connecte deux systèmes directement. C'est rapide à construire et adapté à une intégration unique, stable et à faible volume. Le problème est que cela s'étend mal : cinq systèmes avec des connexions point à point signifient jusqu'à dix surfaces d'intégration à maintenir, chacune avec sa propre authentification, gestion des erreurs et couplage de schéma.
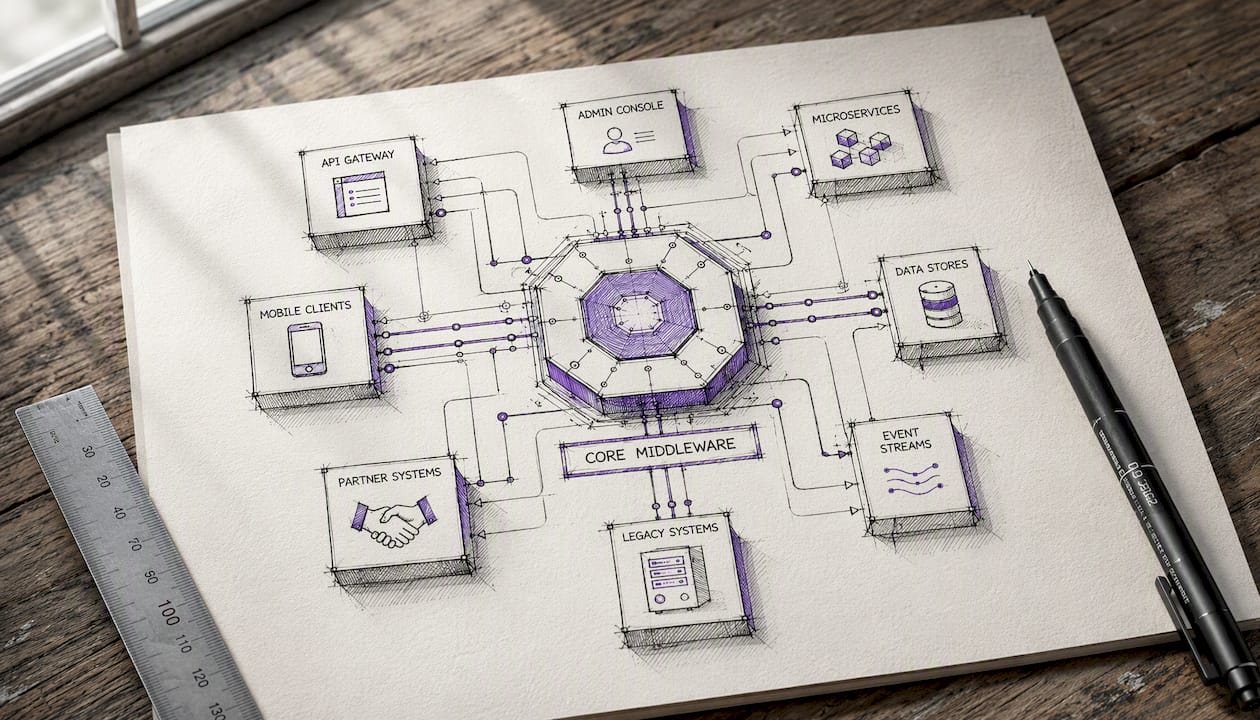
Étoile / middleware achemine toutes les intégrations via une plateforme centrale. MuleSoft Anypoint est l'exemple canonique dans l'écosystème Salesforce. Chaque système se connecte au hub, qui gère la transformation, le routage et la gestion des erreurs. Ce modèle est le bon choix lorsque vous avez plus de trois ou quatre systèmes échangeant des données, lorsque la gouvernance et l'observabilité comptent, ou lorsque vous avez besoin de bibliothèques de connecteurs réutilisables.
Style ESB (Enterprise Service Bus) est une variante de l'étoile avec un accent plus fort sur la transformation des messages et la médiation des protocoles. Il convient aux organisations avec des systèmes hérités hétérogènes qui parlent des protocoles différents. Le compromis est le poids opérationnel : les ESB nécessitent une expertise dédiée et peuvent devenir des goulots d'étranglement.
Connectivité pilotée par API organise les intégrations en trois niveaux : les API système (exposent les données brutes de chaque source), les API de processus (orchestrent la logique métier) et les API d'expérience (adaptent les réponses pour des consommateurs spécifiques comme les applications mobiles ou les portails). La propre méthodologie de MuleSoft formalise ce modèle. C'est l'approche la plus maintenable à l'échelle de l'entreprise car chaque niveau peut évoluer indépendamment.
Fédération virtuelle/zéro copie saute complètement la réplication. Salesforce Data 360 utilise le pushdown de requêtes et les modes de fédération de fichiers/requêtes pour interroger Snowflake, Databricks, Redshift et BigQuery à l'exécution. Salesforce Connect fait quelque chose de similaire pour les objets externes, les affichant dans Salesforce sans les stocker. Ce modèle est idéal lorsque la fraîcheur des données importe plus que la vitesse des requêtes et lorsque le coût de maintenance d'un pipeline de réplication dépasse les avantages.
Utilisez cette liste de déclencheurs de décision pour choisir un modèle :
- Nombre de points de terminaison : Deux ou trois systèmes → le point à point est suffisant. Quatre ou plus → hub ou piloté par API.
- Volume d'événements : Événements à haute fréquence (des milliers par heure) → événementiel avec Pub/Sub ou Platform Events.
- Exigence de temps réel : Sous la seconde → API synchrone ou streaming. Moins de 15 minutes → CDC ou Platform Events. Nuit → batch/API Bulk.
- Équipe propriétaire : Petite équipe avec une expertise middleware limitée → préférer les outils déclaratifs ou les connecteurs préconstruits. Équipe d'intégration dédiée → piloté par API avec MuleSoft.
- Besoins de gouvernance : Industrie réglementée ou exigences d'audit complexes → hub-and-spoke ou piloté par API avec observabilité centralisée.
Astuce de pro : Commencez par des services API-led petits et bien définis pour vos flux à plus forte valeur. Pour les topologies de systèmes de plusieurs à plusieurs, un hub se rentabilise rapidement en réduisant la surface de maintenance — le coût initial de licence et de configuration est presque toujours moins cher que le coût à long terme de débogage d'un réseau de connexions point à point.
Quelle API Salesforce ou fonctionnalité de plateforme correspond à chaque travail d'intégration
Choisir la mauvaise API est l'une des sources les plus courantes de dette technique dans les projets Salesforce. La plateforme offre plusieurs familles d'API, chacune optimisée pour une forme d'intégration spécifique.
| API / Fonctionnalité | Cas d'utilisation idéal | Synchronisation | Quand éviter |
|---|---|---|---|
| API REST | CRUD, mobile/web, appels interactifs, moins de ~10K enregistrements | Synchrone | Chargements volumineux en masse ; épuisera rapidement les limites par organisation |
| API Bulk 2.0 | Chargements/extractions volumineux (des dizaines de milliers à des millions de lignes) | Asynchrone | Besoins à faible latence ; non adapté au temps réel |
| API SOAP | Intégrations ERP héritées, contrats WSDL fortement typés | Synchrone | Nouveaux projets ; REST est plus simple et mieux pris en charge |
| API de streaming / Pub/Sub | Livraison d'événements à haut débit, notifications en temps réel | Streaming | Cas d'utilisation à faible volume ; ajoute de la complexité pour des besoins simples |
| Événements de plateforme | Messagerie événementielle découplée, déclencheurs intersystèmes | Quasi temps réel | Lorsque l'ordre de livraison garanti est critique |
| Capture des modifications de données | Notifications de modifications quasi en temps réel sur les enregistrements Salesforce | Quasi temps réel | Besoins de synchronisation complète des enregistrements ; CDC envoie uniquement des deltas au niveau des champs |
| Salesforce Connect | Affichage d'objets externes sans réplication | Virtuel/temps de requête | Cas d'utilisation à forte écriture ; le système externe doit être hautement disponible |
| Apex REST | Points de terminaison personnalisés avec encapsulation de la logique métier | Synchrone | CRUD standard ; ajoute une surcharge de maintenance inutilement |
| API d'outillage / métadonnées | Déploiements, CI/CD, outillage développeur | Asynchrone | Opérations de données de production |
Pour extractions incrémentielles, Salesforce recommande les getUpdated/getDeleted de l'API SOAP pour des intervalles plus longs, la messagerie sortante pour une fréquence modérée, et la pagination ou l'API Bulk pour de grands ensembles de résultats. Mélanger les stratégies en fonction du volume et de la fréquence est la bonne approche, plutôt que de choisir un mécanisme pour tout.
L'authentification mérite une attention particulière. Pour les intégrations serveur à serveur, le flux JWT Bearer est le choix correct : il ne nécessite pas d'interaction utilisateur, prend en charge les processus d'arrière-plan de longue durée et évite de stocker les informations d'identification utilisateur dans votre couche d'intégration. Le flux OAuth nom d'utilisateur-mot de passe est pratique mais comporte un risque réel — il contourne la MFA et est obsolète dans de nombreuses configurations d'organisation. Utilisez Named Credentials pour les appels sortants de Salesforce vers des systèmes externes ; ils centralisent la gestion des secrets et éliminent les informations d'identification codées en dur dans le code Apex.
Pour les opérations composites, l'API Composite et l'API Composite Graph vous permettent de regrouper plusieurs appels REST dans une seule requête HTTP, ce qui réduit les allers-retours et la consommation d'API. C'est particulièrement utile pour les workflows de création d'enregistrements qui couvrent plusieurs objets liés.
Astuce : Si un travail de données doit un jour dépasser 50 000 lignes, commencez avec Bulk API 2.0 dès le premier jour. Adapter une intégration REST synchrone pour gérer des volumes importants en cours de projet est pénible et nécessite souvent une réécriture complète de la couche de données.
Quand utiliser middleware, Data 360, Heroku Connect et les connecteurs low-code
Les guides de décision d'intégration des architectes Salesforce mappent clairement le choix d'outil au cas d'usage : MuleSoft Anypoint pour la gestion et l'orchestration d'API d'entreprise, Heroku Connect pour la synchronisation basée sur Postgres, et Data 360 pour l'accès aux données harmonisées et piloté par l'analytique. Voici comment chaque outil s'intègre en pratique.
MuleSoft Anypoint est le bon choix lorsque vous avez besoin d'une gestion d'API de niveau entreprise, d'une bibliothèque de connecteurs réutilisables, d'orchestrations complexes en plusieurs étapes ou d'une observabilité centralisée sur de nombreuses intégrations. Il gère les connexions ERP, la médiation de protocoles hérités et le cycle de vie des API. Le compromis réside dans le coût de licence et l'expertise requise pour bien l'exploiter. Pour une équipe sans expérience MuleSoft, la courbe d'apprentissage est réelle.
Salesforce Data 360 (Zero Copy) vous permet d'interroger des données dans Snowflake, Databricks, Redshift et BigQuery sans les copier dans Salesforce, en utilisant le pushdown de requêtes et les modes de fédération fichier/requête. C'est l'outil adapté lorsque vos cas d'usage d'analytique ou de personnalisation nécessitent des données fraîches d'entrepôt et que vous voulez éviter de construire et maintenir un pipeline de réplication. Ce n'est pas l'outil adapté lorsque vous avez besoin d'écriture dans l'entrepôt, d'accès hors ligne ou de temps de réponse de requête inférieurs à la seconde.
Heroku Connect fournit une synchronisation bidirectionnelle entre Salesforce et une base de données Heroku Postgres. Il est spécialement conçu pour les équipes exécutant des applications orientées client sur Heroku qui ont besoin d'accéder aux données Salesforce. La configuration est simple et il gère la résolution de conflits et le mappage de schéma de manière déclarative. Évitez-le pour une synchronisation bidirectionnelle lourde en entreprise sur de nombreux objets — il a été conçu pour un accès au niveau application, pas comme un bus d'intégration généraliste.
Salesforce Connect expose des objets externes dans Salesforce au moment de la requête en utilisant OData ou des adaptateurs personnalisés. Les utilisateurs voient des enregistrements externes dans Salesforce sans aucune réplication. L'inconvénient : le système externe doit être disponible à chaque fois qu'un utilisateur accède à ces enregistrements, et les opérations d'écriture nécessitent que le système externe les prenne en charge. Il convient bien aux scénarios de données de référence à forte lecture.
Connecteurs low-code (packages AppExchange, connecteurs iPaaS préconstruits dans des outils comme Workato ou Boomi) sont appropriés pour des intégrations ponctuelles rapides et bien définies où le connecteur existe déjà et le modèle de données est simple. Ils réduisent le délai de valeur mais peuvent devenir un passif de gouvernance s'ils prolifèrent sans supervision.
Pour la synchronisation moderne des données, CRM Analytics SyncIn et SyncOut offrent des options déclaratives low-code avec synchronisation incrémentale basée sur CDC et suivi des suppressions définitives, ce qui évite les écarts de réconciliation qui affligent les approches de sondage naïves.
Astuce : Utilisez Data 360 zero-copy lorsque vous avez besoin d'un accès au moment de la requête aux données d'entrepôt pour la personnalisation ou l'analytique. Cela élimine toute une classe de travaux de maintenance de pipeline et maintient votre entrepôt comme source faisant autorité. Pour les scénarios de commerce et de paiement, les modèles d'intégration s'étendent naturellement aux flux de traitement des paiements où la cohérence des données entre les systèmes est non négociable.
Synchrone vs asynchrone, événementiel vs batch, entrant vs sortant
Les décisions de mode et de direction façonnent l'expérience utilisateur et la fiabilité du système plus que la plupart des équipes ne le pensent. Se tromper signifie soit une interface utilisateur lente attendant un appel synchrone, soit un processus métier qui réagit à des données obsolètes.
Synchrone les intégrations bloquent le processus appelant jusqu'à ce qu'une réponse arrive. Elles sont appropriées pour les opérations à faible latence orientées utilisateur où le résultat doit être disponible immédiatement, comme la validation d'adresse au moment du paiement ou la vérification de crédit lors de la qualification des prospects. Le risque est que toute lenteur ou défaillance dans le système en aval dégrade directement l'expérience utilisateur.
Asynchrone les intégrations traitent en arrière-plan. L'appelant reçoit un accusé de réception et continue ; le résultat arrive plus tard. C'est le bon modèle pour la plupart des scénarios de synchronisation de données, de notification et de déclenchement de workflows. Cela améliore la résilience car une panne en aval ne bloque pas le flux utilisateur principal.
Événementiel les modèles utilisent Platform Events, Change Data Capture ou l'API Pub/Sub pour propager les changements au fur et à mesure qu'ils se produisent. Platform Events sont durables, découplés et prennent en charge la relecture. CDC se déclenche sur les modifications d'enregistrements Salesforce et fournit des deltas au niveau des champs, ce qui est bien plus efficace que de sonder les modifications d'enregistrements complets. L'API Pub/Sub gère le streaming à haut débit à grande échelle. Pour les scénarios de personnalisation du commerce, l'activation d'événements en quasi temps réel peut générer un impact mesurable sur les revenus lorsque les signaux clients atteignent rapidement les systèmes en aval.
Batch les modèles utilisent des travaux Bulk API planifiés ou des pipelines ETL pour déplacer de grands volumes selon un calendrier. Ils sont rentables, prévisibles et appropriés pour les charges d'analytique, les backfills et les pipelines de reporting où une cadence nocturne ou horaire est acceptable.
Entrant vs sortant la direction compte pour l'authentification, la gestion des erreurs et la propriété :
- Externe → Salesforce (entrant) : Les systèmes externes appellent les API Salesforce. Salesforce gère l'authentification via des applications connectées et OAuth. Les limites de débit s'appliquent côté Salesforce.
- Salesforce → externe (sortant) : Salesforce initie les appels via des callouts Apex, la messagerie sortante ou Platform Events. Les Named Credentials gèrent l'authentification sortante.
- Synchronisation inter-org : Deux orgs Salesforce échangeant des données. Les modèles Data 360, les connexions Salesforce-à-Salesforce (S2S) ou un hub middleware sont les approches courantes selon le volume et les besoins de gouvernance.
Astuce : Privilégiez les modèles pilotés par événements pour la propagation des changements lorsque les règles métier doivent réagir rapidement — mises à jour d'inventaire, routage des leads, escalade des cas. Réservez les chargements par lots aux pipelines d'analyse et aux backfills historiques où quelques heures de décalage n'ont aucune conséquence métier.
Mappage des données, transformations, résolution d'identité et source unique de vérité
Une intégration techniquement correcte qui mappe les mauvais champs ou résout l'identité de manière incohérente corrompra vos données CRM plus rapidement que n'importe quel bug. C'est là que la plupart des projets d'intégration accumulent une dette coûteuse et silencieuse.
Les décisions de mappage au niveau des champs doivent répondre à trois questions : quel est le type de données canonique dans chaque système, où se produit la transformation, et qui possède le champ en cas de conflit. Transformer à la source maintient votre couche d'intégration légère mais la couple aux changements de schéma de la source. Transformer dans un middleware (MuleSoft, un service personnalisé) centralise la logique mais ajoute une couche à maintenir. Transformer dans Salesforce via Apex ou Flow fonctionne pour les cas simples mais peut créer des problèmes de performance à grande échelle.
La résolution d'identité est le problème le plus difficile. Lorsqu'un enregistrement client existe dans Salesforce, votre ERP et votre entrepôt de données, vous avez besoin d'un moyen fiable de les faire correspondre. Les options vont du matching déterministe sur une clé partagée (e-mail, numéro de compte) au matching probabiliste utilisant le moteur de résolution d'identité de Data 360, qui gère les correspondances floues entre les sources de données. Pour la plupart des intégrations B2B, un champ External ID sur l'objet Salesforce est le bon point de départ : il stocke la clé primaire du système source, permettant des opérations d'upsert sans recherche préalable.
Les décisions de source unique de vérité sont architecturales, pas techniques. Décidez quel système possède chaque type d'enregistrement avant de construire quoi que ce soit. Salesforce peut posséder le compte et le contact, tandis que votre ERP possède la commande et la facture. Lorsque les deux systèmes peuvent écrire le même champ, vous avez besoin d'une règle de résolution de conflit — dernier écrit gagne, système source gagne, ou une stratégie de fusion — et cette règle doit être appliquée de manière cohérente.
La dérive de schéma est inévitable. Les systèmes externes modifient leurs modèles de données, les versions de Salesforce ajoutent ou déprécient des champs, et les mappages d'intégration deviennent obsolètes. Les mesures d'atténuation incluent :
- Des tests de contrat qui valident la forme des réponses API par rapport à un schéma défini à chaque déploiement
- Une validation automatisée du mappage qui alerte lorsqu'un champ source disparaît ou change de type
- Un workflow documenté de gestion des changements qui exige que les propriétaires d'intégration approuvent les modifications de schéma avant qu'elles n'atteignent la production
Astuce : Définissez votre stratégie d'External ID dans la phase de découverte et appliquez-la via des règles de validation et une surveillance dès le premier jour. Réadapter la résolution d'identité après que des données ont été chargées depuis plusieurs systèmes sans clé partagée est l'un des problèmes de réconciliation les plus chronophages dans les opérations CRM.
Applications connectées, flux OAuth, autorisations et gouvernance d'intégration
La sécurité dans les intégrations Salesforce ne consiste pas seulement à choisir le bon flux OAuth. Il s'agit de concevoir un système où chaque surface d'intégration est auditable, avec le moindre privilège, et maintenable dans le temps.
Bonnes pratiques d'authentification :
- Utilisez le flux JWT Bearer pour les intégrations serveur à serveur. Il prend en charge l'authentification non interactive, fonctionne avec des certificats et ne nécessite pas de stocker les identifiants utilisateur.
- Évitez le flux OAuth nom d'utilisateur-mot de passe. Il contourne la MFA, est déprécié dans de nombreuses configurations d'organisation et crée un problème de gestion des identifiants.
- Utilisez des identifiants nommés pour tous les appels sortants depuis Salesforce. Ils stockent les identifiants de manière sécurisée dans la plateforme, prennent en charge l'actualisation automatique des jetons et éliminent les secrets codés en dur dans Apex.
Autorisation et moindre privilège :
- N'utilisez jamais un profil d'administrateur système pour un utilisateur d'intégration. Créez un utilisateur d'intégration dédié avec un profil personnalisé limité exactement aux objets et champs dont l'intégration a besoin.
- Utilisez la sécurité au niveau des champs pour restreindre l'accès aux champs sensibles (SSN, données de paiement, informations de santé) même lorsque l'autorisation au niveau de l'objet est accordée.
- Pour les modèles d'accès agentiques ou pilotés par l'IA, les bonnes pratiques des serveurs MCP hébergés recommandent des serveurs SObject limités, des requêtes nommées et des annotations d'outils précises plutôt que de construire des wrappers API personnalisés qui contournent la gouvernance de la plateforme.
Audit, surveillance et observabilité :
- Activez les tableaux de bord d'utilisation API et définissez des alertes pour les pics de consommation inhabituels. Une augmentation soudaine de 10x des appels API est souvent le premier signe d'une intégration incontrôlée ou d'une boucle de réessai mal configurée.
- Consignez la télémétrie au niveau des requêtes pour tous les appels d'intégration : horodatage, système source, objet cible, nombre d'enregistrements et statut de réponse. Ces données sont inestimables lors du débogage des incidents de production.
Garde-fous de gouvernance :
- Traitez votre surface API comme un produit. Documentez-la, versionnez-la et définissez une fenêtre de dépréciation avant de supprimer ou de modifier tout point de terminaison dont un consommateur en aval dépend.
- Exigez des tests de contrat pour chaque API externe que votre intégration consomme. Lorsque le système externe modifie son schéma, votre pipeline CI/CD devrait le détecter avant qu'il n'atteigne la production.
Astuce : Centralisez les secrets dans des identifiants nommés ou un gestionnaire de secrets et faites-les pivoter selon un calendrier. Les intégrations les plus susceptibles de provoquer un incident de sécurité sont celles où les identifiants ont été codés en dur « temporairement » il y a deux ans et jamais revus.
Limites API, anti-modèles, réessais, idempotence et stratégies de traitement par lots
Les limites de la plateforme ne sont pas des suggestions. Salesforce applique des quotas d'appels API par organisation, des limites de livraison d'événements et des plafonds de concurrence Bulk API. Les équipes qui ne planifient pas les limites avant la mise en service ont tendance à les découvrir au pire moment possible.
L'anti-modèle le plus courant est le bavardage : faire un appel API synchrone pour chaque enregistrement dans un processus à volume élevé. Un workflow qui déclenche un appel REST pour chacun des 10 000 enregistrements traités dans un lot épuisera votre quota API quotidien et risque probablement un dépassement de délai. La solution est le traitement par lots : regroupez les enregistrements, utilisez l'API Composite pour regrouper plusieurs opérations par requête, ou passez à Bulk API 2.0 pour tout le travail.
Le fan-out synchrone est un problème connexe. Lorsqu'un déclencheur Salesforce unique envoie des appels sortants à trois systèmes externes en séquence, la latence totale s'additionne et une seule défaillance peut bloquer toute la transaction. Découplez ces appels en utilisant des événements de plateforme ou une couche middleware basée sur une file d'attente.
Modèles de gestion des erreurs qui fonctionnent réellement :
- Backoff exponentiel avec gigue sur les réessais. Lorsqu'un système en aval limite ou est temporairement indisponible, réessayer immédiatement à pleine vitesse amplifie le problème. Ajoutez un délai aléatoire entre les réessais.
- Opérations idempotentes. Concevez chaque opération d'écriture pour que l'exécuter deux fois produise le même résultat que l'exécuter une fois. Utilisez des External IDs et des opérations d'upsert plutôt que des modèles d'insertion puis de mise à jour.
- Gestion des lettres mortes. Les événements échoués qui ne peuvent pas être traités après N réessais doivent atterrir dans une file ou une table de lettres mortes pour examen manuel, pas disparaître silencieusement.
Pour les grands ensembles de résultats, paginez en utilisant queryMore pour les requêtes SOQL et utilisez le modèle basé sur les tâches de l'API Bulk pour les extractions. Le guide des bonnes pratiques pour les grands volumes de données Salesforce recommande getUpdated/getDeleted pour les extractions SOAP incrémentielles et l'API Bulk pour les scénarios de chargement complet à grande échelle — mélanger les stratégies selon le volume est plus efficace que d'appliquer une approche universellement.
Implémenter le backoff exponentiel avec jitter est une bonne pratique documentée pour éviter les tempêtes de nouvelles tentatives qui transforment les événements de limitation en pannes prolongées.
Astuce de pro : Instrumentez votre utilisation de l'API dès le premier jour en production et définissez des alertes à 70% de votre quota quotidien. Réagir à une violation de limite après qu'elle se soit produite signifie des temps d'arrêt. Repérer la tendance tôt signifie que vous avez le temps d'optimiser avant que les utilisateurs ne remarquent quoi que ce soit.
Stratégie de test, étapes de déploiement et ce qui détermine les délais et les coûts d'intégration
Les projets d'intégration échouent en production plus souvent que les projets d'application car les modes de défaillance sont répartis entre les systèmes, et la plupart des équipes ne testent pas suffisamment les frontières.
Liste de contrôle des tests :
- Tests de contrat : Validez que la forme de chaque réponse d'API externe correspond aux attentes de votre intégration. Exécutez-les dans l'intégration continue/déploiement continu à chaque déploiement.
- Tests d'intégration : Testez le parcours complet entre les systèmes dans un environnement sandbox avec des volumes de données représentatifs.
- Scénarios de bout en bout : Parcourez le processus métier du déclencheur au résultat à travers tous les systèmes connectés, y compris les chemins d'erreur.
- Validation du backfill : Pour les projets de synchronisation de données, validez que les enregistrements historiques chargés via l'API Bulk correspondent au système source sur les champs clés et les comptages.
- Tests de charge : Simulez le volume de pointe pour confirmer que vous restez dans les limites de l'API et que la latence répond aux exigences de SLA.
Étapes de déploiement :
- Prototype dans le sandbox : Validez la connexion API, le flux d'authentification et le mappage de données de base. Cela devrait prendre des jours, pas des semaines.
- Pilote dans le sandbox complet : Exécutez l'intégration contre un ensemble de données représentatif avec des scénarios métier réels. Impliquez les utilisateurs finaux.
- Déploiement progressif en production : Activez pour un sous-ensemble d'enregistrements ou d'utilisateurs d'abord. Surveillez la consommation d'API, les taux d'erreur et la qualité des données avant le basculement complet.
- Plan de surveillance et de restauration : Définissez à quoi ressemble une restauration avant de passer en production. Pour les intégrations de synchronisation de données, cela signifie savoir comment restaurer les enregistrements et arrêter la synchronisation sans corrompre les deux systèmes.
Facteurs de délai et de coût :
- Portée des objets et transformations : Une synchronisation à objet unique avec un mappage plat peut être réalisée en quelques jours avec un connecteur préconstruit. Une intégration multi-objets, multi-systèmes avec une logique de transformation complexe prend des semaines à des mois.
- Exigences de volume et de SLA : Les intégrations à volume élevé et à faible latence nécessitent plus d'infrastructure, plus de tests et une gestion des limites plus minutieuse.
- Approbations de sécurité et de conformité : Les secteurs réglementés ajoutent des semaines pour la revue de sécurité, les tests de pénétration et la signature de conformité.
- Licence : MuleSoft Anypoint et Data 360 entraînent des coûts de licence importants qui doivent être pris en compte dès le début dans le business case.
Connecter l'adoption technologique à des résultats commerciaux mesurables est ce qui distingue les projets d'intégration financés de ceux qui restent bloqués au niveau des achats.
Astuce : Construisez d'abord l'intégration minimale viable pour votre flux à plus forte valeur. Cela valide vos hypothèses d'architecture, révèle la complexité réelle tôt et donne aux parties prenantes quelque chose de fonctionnel pour réagir — ce qui est bien plus utile qu'un plan détaillé pour quelque chose qui n'a jamais tourné en production.
Liste de contrôle pratique et pièges courants à éviter
Cette liste de contrôle est organisée par phase. Utilisez-la pour valider les choix d'architecture et attraper les pièges habituels avant qu'ils ne deviennent des incidents de production.
Phase de découverte :
- [ ] Intention d'intégration définie (processus, synchronisation de données ou accès virtuel) pour chaque flux
- [ ] Propriété des données documentée : quel système est faisant autorité pour chaque type d'enregistrement
- [ ] Estimations de volume confirmées : pics d'enregistrements par heure, totaux quotidiens et projections de croissance
- [ ] Marge sur les limites d'API évaluée par rapport à la consommation actuelle de l'organisation
- [ ] SLA de latence convenu avec les parties prenantes métier pour chaque flux
Phase de conception :
- [ ] API sélectionnée en fonction du volume et de la latence (REST, Bulk, Streaming, CDC)
- [ ] Flux d'authentification choisi (JWT Bearer privilégié pour serveur à serveur)
- [ ] Stratégie d'ID externe définie et documentée
- [ ] Gestion des erreurs et stratégie de nouvelle tentative conçues (backoff, idempotence, lettre morte)
- [ ] Processus de changement de schéma et approche de test de contrat convenus
Phase de construction :
- [ ] Identifiants nommés utilisés pour toute authentification sortante ; aucun secret codé en dur
- [ ] Logique de nouvelle tentative implémentée avec backoff exponentiel et gigue
- [ ] Toutes les opérations d'écriture conçues comme des upserts idempotents lorsque possible
- [ ] Surveillance et alertes configurées avant la mise en service, pas après
- [ ] Utilisateur d'intégration créé avec un profil de moindre privilège
Phase d'exploitation :
- [ ] Alertes d'utilisation d'API définies à 70 % du quota quotidien
- [ ] Processus de notification de changement de schéma en place pour toutes les API externes consommées
- [ ] Runbook d'intégration rédigé pour chaque flux de production (propriétaire, SLA, étapes de rollback, contacts d'escalade)
- [ ] Surveillance des coûts en place pour le middleware sous licence et la consommation Data 360
Pièges courants :
- Utilisateurs d'intégration sur-privilégiés avec des profils d'administrateur système
- Interrogation pour les changements au lieu d'utiliser CDC ou Platform Events
- Traiter chaque flux comme temps réel alors que le métier peut tolérer un décalage de 15 minutes
- Télémétrie insuffisante, rendant les incidents de production presque impossibles à diagnostiquer
- Sous-estimation de la dérive de schéma des systèmes externes sur un horizon de 12 mois
Connecter des plateformes modernes à des systèmes hérités ajoute une autre couche de complexité qui mérite sa propre attention architecturale — les modèles d'intégration hérités diffèrent souvent considérablement des approches API-first greenfield.
Astuce : Exigez un runbook d'intégration d'une page pour chaque flux de production avant sa mise en service. Il doit répondre à quatre questions : qui possède ce flux, quelle est la SLA, quelles sont les étapes de rollback, et qui appelez-vous à 2 heures du matin quand ça casse ? Si vous ne pouvez pas répondre à ces questions, l'intégration n'est pas prête pour la production.
Comment Ridiculous Engineering peut vous aider avec votre architecture d'intégration
Ridiculous Engineering conçoit et construit des intégrations Salesforce de niveau production pour les organisations qui ont besoin de plus qu'un connecteur préconfiguré et d'un week-end. Le travail va de la conception d'architecture pilotée par API et la mise en œuvre MuleSoft à la planification zéro copie Data 360, la stratégie de synchronisation inter-org et le support d'intégration à long terme.
Le bon moment pour faire appel à une équipe expérimentée est lorsque le périmètre entre dans le territoire de l'entreprise : plusieurs systèmes, logique de transformation complexe, données réglementées, ou un modèle de gouvernance qui doit tenir sur des années de versions Salesforce. Une architecture d'intégration mal conçue est l'une des choses les plus coûteuses à corriger après coup.
Ce que les clients obtiennent généralement d'un premier engagement avec Ridiculous Engineering :
- Un document d'architecture d'intégration cartographiant les flux, API, modèles et propriété des données
- Une stratégie d'ID externe et de résolution d'identité
- Une revue de sécurité et d'authentification couvrant les applications connectées, les flux OAuth et les identifiants nommés
- Une implémentation pilote du flux à plus forte valeur avec surveillance complète et runbook
- Un plan de déploiement avec liste de contrôle de test et procédures de rollback
Si votre équipe planifie un projet zéro copie Data 360, une synchronisation inter-org ou une stratégie API d'entreprise et a besoin d'un partenaire d'architecture expérimenté, commencez par une conversation sur ce que vous essayez de construire. L'appel de découverte est là où les véritables décisions architecturales sont prises.
Sources
Documentation officielle Salesforce et guides de décision architecturale qui soutiennent les recommandations de cet article :
- Extraction de données et bonnes pratiques pour les grands volumes de données | Développeurs Salesforce
- Data Cloud – Connectivité zéro copie | Salesforce
- Intégration de données avec Salesforce | Guides de décision d'intégration
Prochaines étapes suggérées : Examinez l'utilisation actuelle de l'API de votre organisation dans Configuration → Utilisation de l'API, prototypagez un flux minimal dans un sandbox complet en utilisant l'API qui correspond à votre volume, et exécutez la liste de contrôle de découverte de cet article avant votre prochaine revue d'architecture.
FAQ
Qu'est-ce que l'intégration Salesforce ?
L'intégration Salesforce est le processus de connexion de Salesforce à d'autres systèmes pour partager des données, déclencher des processus ou fournir un accès virtuel à des enregistrements externes. Elle couvre les API, les plateformes middleware, les mécanismes pilotés par événements et les outils de fédération zéro copie.
Avec quoi Salesforce peut-il s'intégrer ?
Salesforce s'intègre avec pratiquement tout système qui expose une API ou prend en charge des formats de données standard, y compris les ERP comme SAP et Oracle, les entrepôts de données comme Snowflake et Databricks, les plateformes marketing, les processeurs de paiement et les applications personnalisées. Les outils natifs comme MuleSoft Anypoint, Heroku Connect et Data 360 zéro copie couvrent les scénarios d'intégration d'entreprise les plus courants.
Combien coûte l'intégration avec Salesforce ?
Le coût varie considérablement. Une intégration simple avec connecteur préconfiguré peut être configurée en quelques jours à un coût minimal. Une intégration d'entreprise impliquant MuleSoft Anypoint, Data 360 zéro copie et une orchestration multi-systèmes peut aller de dizaines de milliers à des centaines de milliers de dollars lorsque les licences, l'architecture, le développement et le support continu sont inclus. Les principaux facteurs de coût sont le volume de données, la complexité de transformation, les exigences de latence et les approbations de sécurité/conformité.
Comment choisir la bonne approche d'intégration Salesforce ?
Commencez par votre intention d'intégration (processus, synchronisation de données ou accès virtuel), votre exigence de latence et votre volume de données. Utilisez REST pour les appels interactifs à faible volume ; Bulk API 2.0 pour les chargements importants ; Platform Events ou CDC pour la propagation de changements pilotée par événements ; et Data 360 zéro copie pour l'analytique et l'accès à l'entrepôt sans réplication. Le processus de revue d'architecture de Ridiculous Engineering mappe ces décisions à vos systèmes spécifiques et exigences métier.
Quelles sont les erreurs d'intégration Salesforce les plus courantes ?
Les problèmes les plus fréquents sont les utilisateurs d'intégration sur-privilégiés, le sondage pour les changements au lieu d'utiliser CDC ou Platform Events, le traitement de chaque flux comme temps réel alors que l'entreprise peut tolérer un décalage, une surveillance insuffisante et la sous-estimation de la dérive de schéma des systèmes externes au fil du temps.