Migration d’un entrepôt de données : guide pratique pour les responsables informatiques
Migration d’un entrepôt de données : guide pratique pour les responsables informatiques Adoptez une migration par phases reposant sur une stratégie hybride : replatteformez les tables critiques pour la production, repensez celles dont la dette technique bloque la montée en charge, et effectuez un simple transfert uniquement pour les actifs rarement consultés ou proches de la mise hors service.
Migration d’un entrepôt de données : guide pratique pour les responsables informatiques
Mettez en œuvre une migration par phases reposant sur une stratégie hybride : replatteformez les tables critiques pour la production, repensez celles dont la dette technique bloque la montée en charge, et effectuez un simple transfert uniquement pour les actifs rarement consultés ou proches de la mise hors service. La chose la plus utile que vous puissiez faire cette semaine est de désigner un responsable et de réaliser un audit de découverte ciblé, en cataloguant vos principales tables de production et leurs principaux consommateurs en aval. Deux risques apparaîtront immédiatement si vous négligez cette étape : des dépendances non documentées qui interrompent les rapports en aval le jour de la bascule, et des années de dette technique accumulée que vous devrez payer pour héberger dans le cloud à un coût par requête supérieur à celui de votre environnement sur site.
Si vous préférez confier cet audit à une équipe expérimentée, Ridiculous Engineering propose des missions d’évaluation structurées, conçues pour transformer les données de découverte en feuille de route de migration priorisée.
Table des matières
-
À quoi ressemble une migration d’entrepôt de données, phase par phase ?
-
Comment auditer votre entrepôt avant le début de la migration ?
-
Quels choix de conception et de modélisation sont les plus importants sur la plateforme cible ?
-
Comment déplacer les données et convertir les pipelines pendant l’exécution ?
-
Que se passe-t-il après la bascule et pourquoi est-ce important ?
-
Quelles catégories d’outils devez-vous évaluer pour votre migration ?
-
Quelles sont les erreurs les plus courantes commises par les équipes ?
-
Combien de temps prend une migration et quel en est le coût ?
À quoi ressemble une migration d’entrepôt de données, phase par phase ?
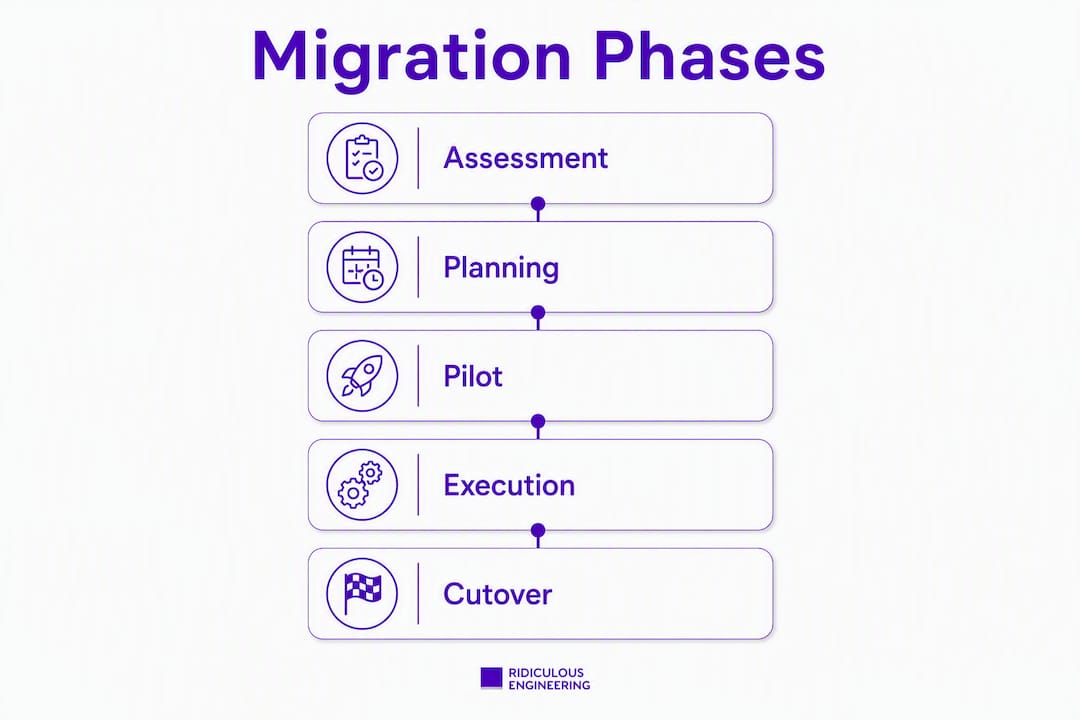
La plupart des migrations réussies adoptent une approche hybride plutôt qu’une stratégie unique, et cette approche hybride ne fonctionne que lorsque chaque phase possède une condition d’entrée claire et un livrable défini. Les six phases ci-dessous constituent le cadre de référence.
-
Évaluation — Livrable : inventaire des systèmes, cartographie des flux de données, matrice des dépendances et registre des risques. La réussite signifie que vous savez ce qui s’exécute en production et ce qui ne s’y exécute pas.
-
Planification — Livrable : feuille de route de migration avec des axes de travail hiérarchisés, les affectations de l’équipe et une grille de décision go/no-go pour chaque actif. La réussite signifie que chaque partie prenante a validé le périmètre.
-
Conception — Livrable : conceptions des schémas cibles, conventions de nommage, modèle de sécurité et stratégie de matérialisation. La réussite signifie que la plateforme cible est conçue en fonction de ses propres caractéristiques, et non copiée du système existant.
-
Exécution — Livrable : données migrées, pipelines ETL/ELT convertis et environnement parallèle opérationnel. La réussite signifie que la source et la cible sont rapprochées et synchronisées.
-
Tests et bascule — Livrable : rapport de validation, comparaisons des indicateurs clés de performance approuvées et plan de bascule signé avec des déclencheurs de retour arrière. La réussite signifie que les utilisateurs métier ont validé la parité des données.
-
Optimisation post-migration — Livrable : journal d’optimisation des requêtes, référence de gouvernance des coûts, tableaux de bord d’observabilité et guides d’exploitation. La réussite signifie que la nouvelle plateforme est plus performante que l’ancien système, et pas seulement différente.
Jalons de décision entre les phases : passez de l’évaluation à la planification uniquement lorsque l’inventaire est complet et que le registre des risques a été examiné. Passez de la planification à la conception uniquement lorsque le périmètre est figé et que la stratégie de migration (lift-and-shift, replatforming ou refonte) est attribuée à chaque actif. Passez de l’exécution aux tests uniquement lorsque les environnements parallèles fonctionnent et que la réconciliation initiale est réussie. Passez des tests à la bascule uniquement lorsque les critères d’acceptation sont remplis et qu’un plan de restauration est documenté.
Un projet pilote ciblé, limité à un seul domaine, à un pipeline ETL représentatif et à une charge de travail de reporting, est la bonne façon de valider les outils et l’approche avant de s’engager dans un déploiement complet.
Comment auditer votre entrepôt avant le début de la migration ?
L’évaluation est la phase dans laquelle la plupart des équipes investissent trop peu, alors que c’est elle qui détermine la réussite du reste du projet. Une découverte incomplète entraîne directement la migration d’actifs inutilisés et une hausse des coûts cloud. Considérez cette phase comme une occasion de supprimer le superflu, et non de le reproduire.
Liste de contrôle de l’inventaire
Pour chaque table ou jeu de données, recueillez :
-
Nom du schéma, nom de la table et propriétaire
-
Nombre de lignes et taille de stockage approximative
-
Stratégie de partitionnement et d’indexation
-
Fréquence d’actualisation et SLA de fraîcheur des données
-
Fréquence des requêtes (à extraire des journaux de requêtes, et non des suppositions)
-
Requêtes les plus consommatrices en coût de calcul
-
Durée d’exécution et taux d’échec des processus ETL
-
Rapports, tableaux de bord et API en aval qui dépendent de cette table
-
Évaluation de la criticité métier par l’équipe responsable
Techniques de découverte
-
Catalogage automatisé : des outils comme Apache Atlas ou les services de catalogage natifs du cloud peuvent analyser les schémas et faire apparaître automatiquement la traçabilité. Commencez par là avant tout travail manuel.
-
Analyse des journaux de requêtes : exportez l’historique des requêtes couvrant plusieurs semaines afin d’identifier les tables réellement lues en production et celles qui n’existent que dans la documentation.
-
Traçage des dépendances : cartographiez les relations de clés étrangères, les définitions de vues et les références aux procédures stockées afin de créer un graphe des dépendances.
-
Entretiens avec les parties prenantes : les responsables BI, les analystes de données et les propriétaires d’applications connaissent les comportements de production non documentés qu’aucun outil de catalogage ne fera apparaître.
Indicateurs à recueillir pour chaque actif
Recueillez le nombre de lignes, la fréquence des requêtes, les requêtes les plus consommatrices, la durée d’exécution des processus ETL, le coût par requête et les fenêtres de fraîcheur des données. Ces indicateurs alimentent directement la grille de notation présentée plus loin dans la section consacrée à l’évaluation.
Conseil de pro : Automatisez l’extraction initiale de l’inventaire à l’aide des vues de schéma d’information de votre entrepôt (par exemple, INFORMATION_SCHEMA.TABLES, INFORMATION_SCHEMA.COLUMNS) et des tables d’historique des requêtes. Exportez les données vers une feuille de calcul ou un outil de catalogage, puis ajoutez les évaluations manuelles de la criticité métier issues des entretiens avec les parties prenantes. Cette approche hybride réduit considérablement le temps d’inventaire par rapport à un catalogage entièrement manuel.
Livrables de cette phase : un inventaire des systèmes, une carte des flux de données, une matrice des dépendances, un registre des risques et un tableau de bord de faisabilité. C’est ce tableau de bord qui guide les décisions entre lift-and-shift, replatforming et refonte.
Quels choix de conception et de modélisation sont les plus importants sur la plateforme cible ?
L’erreur de conception la plus courante lors d’une migration d’entrepôt consiste à copier le schéma existant sur la plateforme cible sans tenir compte de la manière dont cette plateforme facture le calcul et le stockage. Une conception propre à la plateforme implique le partitionnement et le clustering pour les moteurs serverless de type BigQuery, ainsi qu’un choix rigoureux des clés de distribution pour les clouds de type MPP. Les clés de distribution héritées se transposent rarement correctement.
Modèles de modélisation
-
Architecture médaillon (bronze/argent/or) : ingestion brute dans la couche bronze, données nettoyées et conformées dans la couche argent, agrégats prêts pour le métier dans la couche or. Ce modèle fonctionne bien pour les lakehouses cloud et rend la traçabilité transparente.
-
Couches dimensionnelles par rapport aux couches brutes : conservez une couche brute pour assurer l’auditabilité et construisez des dimensions conformées par-dessus. Évitez de les regrouper en une seule couche pendant la migration.
-
Choix de dénormalisation :les entrepôts de données cloud utilisant un stockage en colonnes bénéficient souvent de tables plus larges et dénormalisées. Évaluez la fréquence des jointures et les schémas de requêtes avant de prendre une décision.
-
Types de colonnes et champs imbriqués :utilisez les types natifs tableau et struct lorsque la plateforme les prend en charge afin de réduire la surcharge liée aux jointures, mais uniquement lorsque les consommateurs en aval peuvent gérer cette structure.
Stratégie de matérialisation
-
Utilisez des vues pour les transformations légères exécutées peu fréquemment ou lorsque la fraîcheur des données est essentielle.
-
Utilisez des vues matérialisées pour les agrégations interrogées de manière répétée sur de grands jeux de données.
-
Utilisez des tables agrégées (précalculées) pour les tableaux de bord soumis à des SLA de latence stricts.
-
Le calcul à la lecture est moins coûteux pour les requêtes peu fréquentes ; précalculez les résultats pour les requêtes fréquentes.
Liste de contrôle de la sécurité et de la gouvernance
-
Définissez le contrôle d’accès basé sur les rôles au niveau du schéma et des tables avant la migration, et non après.
-
Classez les données selon leur niveau de sensibilité (PII, PHI, confidentielles, publiques) et appliquez un masquage au niveau des colonnes lorsque cela est requis.
-
Chiffrez les données au repos et en transit ; confirmez les paramètres de chiffrement par défaut de la plateforme cible.
-
Mettez en place un suivi de la traçabilité des données, de l’ingestion à la transformation puis à la production des rapports.
-
Documentez la stratégie d’évolution du schéma : les changements additifs uniquement (nouvelles colonnes, nouvelles tables) sont rétrocompatibles ; les renommages de colonnes et les changements de type ne le sont pas.
Les conventions de nommage comptent davantage que les équipes ne le pensent. Convenez d’une norme (snake_case, préfixe par couche, suffixe selon le type de matérialisation) avant le début de l’exécution, et faites-la respecter lors des revues de code.
Comment déplacer les données et convertir les pipelines pendant l’exécution ?
C’est lors de l’exécution que les plans se confrontent à la réalité. L’objectif est de déplacer les données de manière fiable, de convertir précisément la logique ETL/ELT et de maintenir la synchronisation entre la source et la cible assez longtemps pour valider la parité avant la bascule.
Schémas de déplacement des données
-
Chargement de l’historique complet :extrayez l’ensemble du jeu de données une seule fois. Utilisez cette méthode pour les tables statiques ou rarement mises à jour. Elle est simple, mais crée un instantané ponctuel qui diverge immédiatement si la source est active.
-
Synchronisation incrémentielle :extrayez uniquement les enregistrements modifiés depuis la dernière exécution à l’aide d’une colonne de filigrane (par exemple,
updated_at). Plus rapide que les chargements complets, cette méthode nécessite toutefois un indicateur de modification fiable dans la source. -
Capture des données modifiées (CDC) :la CDC permet une réplication quasi en temps réel en lisant le journal des transactions du système source. Elle réduit les fenêtres de bascule par rapport aux méthodes reposant uniquement sur des chargements en masse et constitue le bon choix pour les sources transactionnelles actives.
Migration du code
Les traducteurs SQL automatisés gèrent les différences de dialecte (par exemple, de Teradata SQL vers BigQuery SQL, d’Oracle vers Snowflake) plus rapidement et plus uniformément que les réécritures manuelles pour le DML standard. Toutefois, les procédures stockées comportant une logique de contrôle complexe, des fonctions spécifiques à un fournisseur et du SQL dynamique nécessitent généralement une refactorisation manuelle. Prévoyez explicitement du temps pour ces tâches ; ce sont elles qui entraînent généralement les retards des projets.
L’automatisation gère la dérive des schémas et les tâches de traduction répétitives de manière plus fiable que les scripts écrits manuellement, ce qui améliore la fiabilité de la bascule. Utilisez des connecteurs et des traducteurs éprouvés pour les tâches répétables, et réservez du temps d’ingénierie à la logique qui nécessite véritablement un jugement humain.
Orchestration et exécutions parallèles
-
Créez des pipelines idempotents : chaque exécution doit produire le même résultat, quel que soit le nombre de fois où elle est exécutée. Les nouvelles tentatives deviennent ainsi sûres.
-
Implémentez une logique de nouvelle tentative avec un temps d’attente exponentiel pour les défaillances transitoires.
-
Exécutez les pipelines source et cible en parallèle pendant l’exécution afin que le rapprochement puisse avoir lieu en continu, et pas uniquement au moment de la bascule.
-
Surveillez la télémétrie du pipeline (nombre de lignes, latence, taux d’erreur) dès le premier jour d’exécution, et pas uniquement pendant la fenêtre de validation.
La connexion des sources existantes aux destinations modernes nécessite une planification rigoureuse de la compatibilité des connecteurs, en particulier lorsque les systèmes sources sont sur site et que les cibles sont natives du cloud.
Comment valider les données et planifier une bascule sécurisée ?
La validation est le moment où les équipes découvrent que la concordance du nombre de lignes est nécessaire, mais loin d’être suffisante. Le comptage des lignes ne permet de détecter que les problèmes les plus évidents ; les exécutions en parallèle et la validation par les utilisateurs métier sont celles qui font apparaître les erreurs de logique et de sémantique.
Étapes de validation
-
Vérifications structurelles : confirmez que toutes les tables, colonnes, données et contraintes existent sur la cible.
-
Rapprochement du nombre de lignes : faites correspondre le nombre de lignes de chaque table entre la source et la cible.
-
Comparaisons de sommes de contrôle et de hachage : calculez des sommes de contrôle sur les colonnes clés afin de détecter toute corruption silencieuse des données.
-
Comparaisons des agrégats : comparez SUM, COUNT, AVG, MIN et MAX pour les indicateurs critiques sur des fenêtres temporelles correspondantes.
-
Rapprochement des KPI : exécutez les mêmes rapports métier sur les deux systèmes et comparez les résultats.
-
Vérification d’un échantillon d’enregistrements : vérifiez ponctuellement des enregistrements individuels dans plusieurs tables, en particulier pour les tables soumises à des transformations complexes.
-
Tests de performance des requêtes : exécutez les 20 principales requêtes de production sur la cible et comparez leurs temps d’exécution à la référence de la source.
Critères d’acceptation
Définissez-les avant le début de l’exécution, et non pendant la fenêtre de validation :
-
Seuil de parité des données (par exemple, valeurs agrégées à 0,01 % près de la source)
-
SLA de performance des requêtes (par exemple, temps de requête P95 inférieur de 20 % au temps de référence de la source)
-
Aucune divergence critique des KPI
-
Approbation des utilisateurs métier d’au moins un responsable par domaine
Options de bascule
| Stratégie | Description | Complexité de la restauration | Cas d’utilisation typique |
|---|---|---|---|
| Exécution en parallèle | Les deux systèmes sont actifs ; le trafic est progressivement transféré | Faible — rétablir le trafic vers la source | La plupart des migrations ; recommandée par défaut |
| Bleu/vert | Bascule complète à une heure planifiée ; la source reste opérationnelle | Moyenne — rétablir le DNS ou les connexions | Environnements bien testés et à moindre risque |
| Par domaine, par phases | Effectuer la bascule un domaine métier à la fois | Faible par domaine | Grand EDW d’entreprise avec des domaines indépendants |
| Bascule en une seule fois | Événement de bascule unique ; mise hors service immédiate de la source | Élevé — aucun retour en arrière | Petits jeux de données ; rarement recommandé |
Réservez une fenêtre de plusieurs jours pour la réconciliation finale en exécution parallèle et les contrôles de cohérence avant de mettre le système existant hors service. Les équipes sous-estiment systématiquement cette fenêtre, et le coût de sa prolongation est bien inférieur à celui du retour en arrière après une mise hors service prématurée.
Plan de communication de la bascule : attribuez un responsable nommé à chaque étape, documentez les critères de retour en arrière (p. ex. écart de KPI supérieur au seuil, taux d’échec des pipelines supérieur à X %), et distribuez le plan à toutes les parties prenantes au moins 48 heures avant l’ouverture de la fenêtre de bascule.
Que se passe-t-il après la bascule, et pourquoi est-ce important ?
L’optimisation post-migration est une phase planifiée, et non une réflexion après coup. Un entrepôt de données migré qui n’a pas été optimisé pour son nouvel environnement est souvent plus lent et plus coûteux que le système existant qu’il remplace, ce qui est une conversation difficile à avoir avec la direction.
Tâches d’optimisation et de maintenance
-
Effectuez le profilage des requêtes de production à fort impact et identifiez les analyses complètes de tables, les clés de clustering manquantes et les schémas de jointure inefficaces.
-
Optimisez le partitionnement et le clustering en fonction des schémas de requêtes réellement observés après la migration, et non des hypothèses antérieures à celle-ci.
-
Exécutez les tâches de vacuum et de compactage sur les tables présentant des taux élevés de mises à jour ou de suppressions.
-
Nettoyez les objets migrés qui avaient été signalés comme prioritaires faibles lors de l’évaluation, mais qui ont tout de même été transférés.
Gouvernance des coûts
Sans refonte, les schémas de requêtes existants et les jointures inutiles gonflent les coûts de calcul dans les entrepôts cloud où le calcul est facturé par requête. Principaux contrôles :
-
Définissez des politiques de cycle de vie du stockage afin de déplacer automatiquement les données froides vers des niveaux moins coûteux.
-
Mettez en œuvre la mise en cache des résultats de requêtes lorsque la plateforme le permet.
-
Surveillez les coûts de sortie si vos consommateurs analytiques se trouvent dans une autre région cloud ou chez un autre fournisseur.
-
Définissez des alertes budgétaires à 80 % et 100 % du budget mensuel de calcul.
Observabilité
-
Instrumentez les pipelines avec des métriques de nombre de lignes, de latence et de taux d’erreur dès le premier jour.
-
Définissez des SLI et des SLO pour la fraîcheur des données (p. ex. « la couche silver est actualisée dans les 30 minutes suivant la validation de la source ») et la latence des requêtes.
-
Configurez la détection des anomalies sur les métriques clés afin que les défaillances silencieuses soient détectées avant que les utilisateurs métier ne les remarquent.
Pour les équipes qui évoluent vers des architectures cloud natives, l’optimisation post-migration est également le moment idéal pour déterminer si le modèle de données actuel prend en charge les charges de travail d’IA/ML que l’entreprise souhaite exécuter ensuite.
Quelles catégories d’outils devez-vous évaluer pour votre migration ?
Choisir les outils avant de comprendre les exigences spécifiques de votre migration est l’une des erreurs les plus coûteuses qu’une équipe puisse commettre. Évaluez-les selon leurs capacités et leur adéquation, et non selon la notoriété de leur marque.
Catégories d’outils à évaluer
-
Connecteurs et plateformes CDC : recherchez la prise en charge native de votre système source, la gestion de la dérive des schémas et l’ingestion idempotente. Vérifiez que le connecteur prend en charge le mode de réplication requis (complète, incrémentielle, CDC).
-
Frameworks ETL/ELT et de transformation : évaluez la couverture de la traduction SQL automatisée pour le dialecte de votre source, la prise en charge des transformations modulaires de type dbt et la capacité à gérer la migration des procédures stockées.
-
Plateformes d’orchestration :évaluer la sémantique des nouvelles tentatives, la gestion des dépendances, les alertes et l’intégration avec vos outils CI/CD existants.
-
Outils de catalogage et de lignage :confirmez qu’ils peuvent analyser automatiquement vos schémas source et cible et faire apparaître le lignage au niveau des colonnes.
-
Outils de test et de validation :recherchez des fonctions intégrées de comparaison des agrégats, de rapprochement des nombres de lignes et de définition de critères d’acceptation personnalisés.
Liste de contrôle des fonctionnalités pour tout outil en cours d’évaluation
-
Détection de la dérive des schémas et gestion automatisée
-
Traduction SQL automatisée avec rapports de couverture
-
Ingestion idempotente (nouvelles tentatives sécurisées)
-
Prise en charge de l’annulation ou du retour en arrière
-
Surveillance et alertes intégrées
-
Intégration cloud native avec votre plateforme cible
Conseils pour le projet pilote
Limitez votre projet pilote à un domaine métier, un pipeline ETL représentatif et une charge de travail de reporting. Définissez les critères de sortie avant le début du projet pilote : débit minimal, taux d’erreur maximal et rapprochement réussi des KPI. Un projet pilote dépourvu de critères de sortie n’est qu’une preuve de concept qui ne se termine jamais.
Une gestion intelligente des coûts pendant la phase pilote, notamment en surveillant dès le premier jour la consommation de stockage et de calcul, permet d’éviter que les mauvaises surprises financières ne s’amplifient lors de la migration complète.
Quelles sont les erreurs les plus courantes commises par les équipes ?
La plupart des échecs de migration sont prévisibles. Les mêmes schémas se répètent dans des projets de toutes tailles.
Liste de contrôle préventive
-
Gelez le périmètre après la phase de planification. Les changements de périmètre pendant l’exécution constituent la principale source de dépassement des délais.
-
Auditez toutes les dépendances en aval avant le début de l’exécution, et non pendant la fenêtre de validation.
-
Planifiez des exécutions en parallèle pour chaque domaine de production, et pas uniquement pour ceux dont vous êtes le plus sûr.
-
Prévoyez une fenêtre de validation d’au moins 48 heures après la bascule avant de mettre hors service le système existant.
-
Désignez un responsable identifié pour chaque table de l’inventaire. Les ressources sans responsable deviennent des blocages.
-
Documentez les déclencheurs d’annulation et testez la procédure d’annulation avant l’ouverture de la fenêtre de bascule.
Pièges courants et mesures d’atténuation
-
Migration de la dette technique :les équipes répliquent les schémas existants sans évaluer si les modèles sous-jacents répondent toujours aux besoins de l’entreprise. Mesure d’atténuation : utilisez la grille de notation de l’évaluation pour signaler les ressources fortement endettées en vue d’une refonte plutôt que d’un simple transfert à l’identique.
-
Sous-estimation du temps de validation de la bascule :le minimum de 48 heures constitue un plancher, pas un objectif. Les environnements complexes comportant de nombreux consommateurs en aval nécessitent davantage de temps. Mesure d’atténuation : ajoutez une marge de validation au plan du projet pendant la planification, et non pendant l’exécution.
-
Dépendances en aval manquantes :une table qui semble inutilisée dans les journaux de requêtes peut être lue par un traitement par lots mensuel exécuté pour la dernière fois il y a six semaines. Mesure d’atténuation : étendez l’analyse des journaux de requêtes à au moins 90 jours et réalisez des entretiens avec les parties prenantes.
-
Négligence de la gouvernance des coûts :les équipes se concentrent sur la parité des données et ignorent les coûts de calcul jusqu’à la réception de la première facture cloud. Mesure d’atténuation : définissez des alertes budgétaires et consultez chaque semaine les tableaux de bord des coûts dès le premier jour de l’exécution.
-
Omission de la gestion du changement :les utilisateurs finaux qui ne sont pas informés du calendrier de la bascule et des plans de formation contourneront le nouveau système ou signaleront des problèmes de qualité des données qui sont en réalité liés à un manque de familiarité. Mesure d’atténuation : incluez un plan de communication avec les parties prenantes dans le plan du projet dès le premier jour.
Combien de temps dure une migration et quel est son coût ?
Le calendrier et le budget varient davantage que ne le reconnaissent la plupart des guides. La réponse honnête dépend du volume de données, de la complexité des transformations, des dépendances en aval et de la quantité de dette technique que vous choisissez de traiter plutôt que de reporter.
Calendriers indicatifs
-
Petite migration (un seul domaine, pipelines limités) : Les petites migrations peuvent être terminées en 4 à 6 semaines. Cas typique : une seule unité opérationnelle déplace un jeu de données bien documenté avec peu de consommateurs en aval.
-
Migration moyenne (plusieurs domaines, complexité modérée) : Les projets de complexité moyenne s’étendent généralement sur 12 à 24 semaines. Cas typique : une organisation de taille moyenne qui consolide plusieurs systèmes sources dans un entrepôt de données cloud.
-
Modernisation d’un EDW d’entreprise : Les modernisations d’entreprise peuvent durer de 8 à 50 semaines selon le volume de données, la complexité de l’intégration et les dépendances en aval. Prévoyez une marge de contingence dans les environnements complexes.
Rôles à pourvoir dans l’équipe
-
Responsable du projet : responsable du périmètre, du calendrier et de la communication avec les parties prenantes
-
Responsable de l’ingénierie des données : responsable de la conversion des pipelines, de la mise en œuvre de la CDC et de l’exécution
-
Responsable de la plateforme et de l’infrastructure : responsable de la configuration de la plateforme cible, de la sécurité et de la gouvernance des coûts
-
Responsable de l’assurance qualité et de la validation : responsable des critères d’acceptation, des scripts de validation et de l’approbation de la bascule
-
Responsable BI et produit : représente les consommateurs en aval et approuve le rapprochement des indicateurs clés de performance
-
Responsable de la conduite du changement : responsable de la formation, de la documentation et de la communication avec les utilisateurs finaux
Facteurs de coût
-
Volume de données et profondeur de l’historique (plus de données = davantage de calcul pour le chargement initial et la validation)
-
Complexité des transformations (les procédures stockées et les fonctions propres aux fournisseurs nécessitent un travail manuel)
-
Tolérance aux interruptions requise (une tolérance plus faible = des coûts d’infrastructure d’exécution parallèle plus élevés)
-
Licences des outils (connecteurs, plateformes d’orchestration, outils de catalogage)
-
Effort d’ingénierie (heures de l’équipe interne et éventuels services de conseil externes)
-
Support post-migration (optimisation, maintenance des procédures d’exploitation et gouvernance continue des coûts)
Prévoyez une marge de contingence de 30 à 50 % pour les migrations complexes. Cette marge n’est pas du pessimisme ; elle correspond au coût des inconnues que la phase d’évaluation n’a pas encore révélées. Les équipes qui ignorent cette réserve sont celles qui demandent des modifications urgentes du périmètre à la huitième semaine.
Aligner les priorités de migration sur les objectifs métier plutôt que sur des critères purement techniques est ce qui distingue les migrations qui produisent un retour sur investissement mesurable de celles qui ne font que déplacer le problème vers un environnement plus coûteux.
Grille d’évaluation de Ridiculous Engineering
Cette grille convertit les données de découverte en une liste de décisions hiérarchisées. Évaluez chaque actif selon cinq dimensions, additionnez les scores, puis appliquez les règles d’action ci-dessous.
Dimensions de notation (échelle de 1 à 5 pour chacune)
| Dimension | 1 (Faible) | 3 (Moyen) | 5 (Élevé) |
|---|---|---|---|
| Criticité métier | Rarement utilisé, aucun SLA | Utilisé chaque semaine, SLA informel | Utilisation quotidienne, SLA formel, lié aux revenus |
| Fréquence des requêtes | < 1 requête/jour | 1–50 requêtes/jour | > 50 requêtes/jour |
| Dette technique | Propre, documenté | Une partie de la logique n’est pas documentée | Nombreuses procédures stockées, aucune documentation |
| Qualité des données | Problèmes connus, faible confiance | Anomalies occasionnelles | Grande confiance, validation régulière |
| Dépendances en aval | 0–1 consommateur | 2–5 consommateurs | 6+ consommateurs |
Exemple d’inventaire avec scores de priorité
| Actif | Criticité | Fréq. des requêtes | Dette technique | Qualité des données | Dépendances | Total |
|---|---|---|---|---|---|---|
orders_fact |
5 | 5 | 3 | 4 | 5 | — |
legacy_staging_v2 |
1 | 1 | 5 | 2 | 1 | — |
customer_dim |
4 | 4 | 2 | 5 | 4 | — |
archive_raw |
1 | 1 | 1 | 3 | 1 | 7 |
marketing_agg |
3 | 3 | 4 | 3 | 3 | — |
Règles d’action
-
Score de 18 à 25 : Replatformer avec refonte. Ces actifs sont essentiels à l’activité et présentent une dette technique ou une complexité en aval suffisante pour qu’une migration à l’identique crée des problèmes persistants.
-
Score de 12 à 17 : Replatformer avec optimisation ciblée. Migrer vers la plateforme cible et traiter les éléments présentant la dette la plus importante, sans qu’une refonte complète soit nécessaire.
-
Score de 7 à 11 : Migrer à l’identique ou archiver. Leur faible criticité et leur faible fréquence d’interrogation en font de bons candidats pour une migration directe ou une mise hors service.
-
Score inférieur à 7 : Archiver ou mettre hors service. Valider avec l’équipe responsable, puis retirer du périmètre.
Liste de contrôle associée aux résultats du barème
-
[ ] Attribuer un score à chaque actif de l’inventaire avant le début de la planification
-
[ ] Signaler tous les actifs obtenant un score d’au moins 18 pour un examen de refonte avec le responsable de l’ingénierie des données
-
[ ] Confirmer les candidats à la mise hors service avec les responsables métier avant de les retirer du périmètre
-
[ ] Documenter la justification du score de chaque actif dans le registre des risques
-
[ ] Réexaminer les scores après les entretiens avec les parties prenantes, car la criticité métier évolue souvent
Conseil pratique : Renseignez automatiquement les scores initiaux de fréquence d’interrogation et de dette technique en interrogeant le schéma d’information et les tables d’historique des requêtes de votre entrepôt de données. Utilisez un simple script SQL pour compter les requêtes par table sur les 90 derniers jours et signaler les tables présentant des dépendances à des procédures stockées. La notation manuelle de la criticité métier et de la qualité des données prend une heure par entretien avec une partie prenante ; automatisez tout le reste.
Points clés à retenir
Une migration d’entrepôt de données par phases, reposant sur une stratégie hybride (replatforming pour les actifs critiques, refonte lorsque la dette technique empêche la mise à l’échelle, lift-and-shift pour les actifs prioritaires faibles), surpasse systématiquement les approches à stratégie unique en matière de coûts, de fiabilité et de délai avant création de valeur.
| Point | Détails |
|---|---|
| L’évaluation guide chaque décision | Une découverte incomplète conduit à migrer des actifs inutilisés et à gonfler les coûts cloud ; répertoriez les tables de production avant de commencer la planification. |
| La stratégie hybride est supérieure à l’approche à mode unique | Attribuez à chaque actif une approche lift-and-shift, de replatforming ou de refonte à l’aide d’une grille d’évaluation pondérée, plutôt que d’une règle générale. |
| La validation prend plus de temps que prévu | Prévoyez une fenêtre d’exécution en parallèle suffisante après la bascule avant de mettre hors service le système existant. |
| La phase post-migration doit être planifiée | Prévoyez dès le départ un budget pour l’optimisation des requêtes, la gouvernance des coûts et l’observabilité ; il ne s’agit pas de tâches de nettoyage facultatives. |
| Ridiculous Engineering à vos côtés | Ridiculous Engineering propose des missions d’évaluation, des projets de replatforming et l’optimisation post-migration aux équipes qui ont besoin d’un accompagnement externe expérimenté. |
Comment Ridiculous Engineering accompagne votre migration
Les migrations d’entrepôts de données comptent parmi les décisions d’infrastructure les plus lourdes de conséquences qu’une organisation puisse prendre, et l’écart entre une migration bien exécutée et une migration mal cadrée se répercute directement sur les coûts cloud, la productivité des analystes et la fiabilité de chaque rapport en aval. Ridiculous Engineering’s services de développement logiciel sur mesure et d’ingénierie des données sont conçus précisément pour ce type de projet complexe et à forts enjeux.
L’équipe de Ridiculous Engineering mène des missions d’évaluation structurées qui produisent l’inventaire, la matrice des dépendances et la grille d’évaluation décrits dans ce guide, afin que vous commenciez l’exécution avec une feuille de route claire et hiérarchisée plutôt qu’avec une liste d’hypothèses. L’équipe prend ensuite en charge les projets de replatforming et de refactorisation, la mise en œuvre de la CDC et de l’orchestration, ainsi que l’optimisation post-migration et la gouvernance des coûts. Pour les organisations qui ont besoin d’un accompagnement continu après la bascule, Ridiculous Engineering propose une ingénierie externalisée et un leadership technique à temps partiel.
Si vous êtes au début d’une migration et avez besoin d’une vision claire du périmètre, des risques et du calendrier avant de vous engager dans un plan de projet complet, l’étape suivante consiste à lancer une mission de découverte ciblée. Contacter Ridiculous Engineering pour discuter d’une évaluation adaptée à votre environnement.
Sources utiles et lectures complémentaires
Les sources suivantes ont servi à élaborer ce guide et méritent d’être consultées directement pour obtenir davantage de détails techniques :
-
Guide de migration d’entrepôt de données et bonnes pratiques (ER/Studio) — Présente les stratégies de migration hybrides, les compromis de conception propres à chaque plateforme et les approches de validation. Utile pour les phases d’évaluation et de conception.
-
Comment utiliser la modélisation des données lors d’une migration vers le cloud (ER/Studio) — Explique pourquoi l’évaluation révèle des comportements de production non documentés et comment utiliser la modélisation des données comme outil de migration plutôt que comme simple exercice de documentation.
-
Outils de migration de bases de données et conseils en matière d’automatisation (Fivetran) — Conseils pratiques sur les capacités d’automatisation, la gestion de la dérive des schémas et les situations où le travail manuel est inévitable.
-
Bonnes pratiques et calendriers de migration des données (Fivetran) — Présente les fenêtres de validation de la bascule, le cadrage des pilotes et la planification du calendrier. Les recommandations concernant une fenêtre de validation minimale de 48 heures proviennent de cette source.
-
Migration d’entrepôt de données : stratégie complète et plan de projet (Exasol) — Conseils détaillés sur le plan de projet, avec des fourchettes de délais pour les migrations de petite taille jusqu’aux migrations d’entreprise.
-
Votre guide sur la migration d’entrepôt de données (Atlan) — Excellente présentation des modèles de CDC et de la manière dont ils réduisent les fenêtres de bascule pour les sources transactionnelles actives.
FAQ
Qu’est-ce qu’une migration d’entrepôt de données ?
La migration d’un entrepôt de données est le processus de déplacement des données, des schémas, des pipelines et des charges de travail de reporting depuis un entrepôt existant ou sur site vers une nouvelle plateforme, généralement un entrepôt de données cloud. Elle comprend l’évaluation, la conception, le déplacement des données, la conversion des processus ETL, la validation et l’optimisation post-migration.
Quels sont les quatre types de migration des données ?
Les quatre types courants sont la migration du stockage (déplacement des données entre systèmes de stockage), la migration de base de données (déplacement entre moteurs de base de données), la migration d’application (déplacement des données dans le cadre d’une modification d’application) et la migration des processus métier (restructuration des données pour prendre en charge de nouveaux flux de travail). Une migration d’entrepôt combine généralement une migration de base de données et une migration d’application.
ETL est-il identique à une migration de données ?
L’ETL (extraire, transformer, charger) est une technique utilisée dans le cadre d’une migration de données, et non un synonyme de celle-ci. La migration est le projet global ; l’ETL ou l’ELT est le mécanisme permettant de déplacer et de transformer les données dans le cadre de ce projet.
Quelles catégories d’outils sont les plus adaptées à la migration de données ?
Aucun outil unique ne répond à toutes les exigences. La plupart des équipes combinent une plateforme de CDC ou de connecteurs pour le déplacement des données, un framework de transformation (tel que dbt) pour la conversion SQL, une plateforme d’orchestration pour la gestion des pipelines et un outil de catalogage pour la traçabilité. Évaluez chaque catégorie en fonction de vos systèmes source et cible spécifiques avant de faire votre choix.
Combien de temps prend généralement une migration d’entrepôt de données ?
Les petites migrations peuvent être réalisées en 4 à 6 semaines ; les projets de complexité moyenne durent généralement de 12 à 24 semaines ; la modernisation d’un entrepôt de données d’entreprise peut prendre de 8 à 50 semaines selon le volume de données, la complexité des intégrations et les dépendances en aval.