Modern Data Stack : une feuille de route pratique pour les décideurs
Modern Data Stack : une feuille de route pratique pour les décideurs Le Modern Data Stack est une infrastructure de données cloud-native, fondée sur l’ELT et SQL, qui fait passer les données brutes des systèmes sources à un état gouverné et prêt pour l’analyse. Il constitue aujourd’hui le socle le plus pratique pour accélérer l’analytique et se préparer à l’IA. Si votre équipe utilise encore des pipelines ETL sur site, attend plusieurs jours pour obtenir des rapports ou se demande pourquoi ses modèles de ML produisent sans cesse des résultats peu fiables, cette architecture est la réponse directe.
Modern Data Stack : une feuille de route pratique pour les décideurs
Le Modern Data Stack est une infrastructure de données cloud-native, fondée sur l’ELT et SQL, qui fait passer les données brutes des systèmes sources à un état gouverné et prêt pour l’analyse. Il constitue aujourd’hui le socle le plus pratique pour accélérer l’analytique et se préparer à l’IA. Si votre équipe utilise encore des pipelines ETL sur site, attend plusieurs jours pour obtenir des rapports ou se demande pourquoi ses modèles de ML produisent sans cesse des résultats peu fiables, cette architecture est la réponse directe. Ses briques fondamentales sont l’ELT — charger d’abord les données brutes, puis les transformer dans l’entrepôt avec SQL —, la séparation du stockage et du calcul, ainsi qu’un outillage modulaire. Ensemble, elles réduisent la charge opérationnelle tout en préservant l’historique des données dont vos futurs workloads d’IA auront besoin.
Table des matières
-
Qu’est-ce qu’un stack de données moderne et qu’est-ce qui le rend « moderne » ?
-
Les composants fondamentaux : rôle de chaque couche et responsable associé
-
En quoi un stack moderne diffère-t-il d’une plateforme de données traditionnelle ?
-
Quels contrôles de gouvernance et d’observabilité devriez-vous mettre en place dès le premier jour ?
-
Comment planifier et construire un stack de données moderne ?
-
Quels choix stratégiques devriez-vous faire au cours des 12 à 36 prochains mois ?
-
Environnement et durabilité des stacks de données cloud-native
-
Ridiculous Engineering conçoit des stacks de données modernes qui passent réellement en production
Qu’est-ce qu’un stack de données moderne et qu’est-ce qui le rend « moderne » ?
Le terme est employé de manière assez vague ; une définition précise est donc importante. Un stack de données moderne remplace le monolithe ETL traditionnel par un ensemble de services gérés dans le cloud, chacun responsable d’une couche du pipeline de données, et reliés par SQL comme interface commune. « Moderne » renvoie à quatre décisions architecturales précises, et non à une marque ou à un fournisseur.
Principes fondamentaux :
-
Services gérés cloud-native.Aucun serveur à approvisionner, aucun cluster d’entrepôt à dimensionner à l’avance. Les ressources de calcul évoluent de manière élastique et vous payez ce que vous utilisez.
-
ELT, et non ETL.Chargez d’abord les données brutes dans l’entrepôt, puis transformez-les sur place avec SQL. Le stockage dans le cloud est peu coûteux ; les ressources de calcul sont élastiques et facturées à la requête. Charger toutes les données brutes préserve les options : lorsque les exigences changent dans six mois — ce qui arrivera — les données sources sont toujours disponibles.
-
SQL comme lingua franca.Les analystes, les analytics engineers et les data engineers travaillent tous dans le même langage. Les transferts cognitifs entre le prétraitement en Python et la génération de rapports en SQL disparaissent en grande partie.
-
Séparation du stockage et du calcul.Les charges de reporting ne se disputent plus le même processeur avec les requêtes ponctuelles. L’entraînement des modèles de ML lit les mêmes tables que les outils de BI, sans les copier. La planification de capacité, qui constituait le goulot d’étranglement à l’ère des infrastructures sur site, disparaît en grande partie.
-
Modularité et consolidation pragmatique.Chaque couche peut en théorie être remplacée. En pratique, l’orientation en 2026 consiste à utiliser moins d’outils plus performants, et non davantage d’outils moins efficaces.
Ces principes se traduisent directement par des résultats métier. Le délai d’accès aux insights diminue, car les analystes peuvent travailler en autonomie sur des tables modélisées au lieu d’attendre que l’IT produise des rapports. Les coûts deviennent plus prévisibles lorsque vous utilisez un ensemble d’outils restreint et rigoureux. La préparation à l’IA suit naturellement : des données propres, gouvernées et accessibles sont indispensables pour qu’un modèle de ML ou un agent d’IA produise une valeur fiable.
Indicateur de coût :Une entreprise utilisant le stack standard dépense généralement un budget mensuel modéré, qui évolue avec la taille de l’équipe et l’usage, le calcul de l’entrepôt constituant le principal facteur de coût. La variation provient presque entièrement du calcul de l’entrepôt, qui évolue en fonction du volume de requêtes et de la rigueur de l’équipe concernant les exécutions incrémentielles par rapport aux actualisations complètes. Pour les équipes types, les dépenses mensuelles vont de 500 à 2 000 $ pour une entreprise de 50 personnes, et de 5 000 à 20 000 $ pour des équipes de taille intermédiaire comptant 50 à 200 employés.
Les composants fondamentaux : rôle de chaque couche et responsable associé
Considérez le stack analytique comme un pipeline dont chaque étape assume des responsabilités distinctes. La plupart des erreurs d’architecture trouvent leur origine dans la confusion entre les couches.
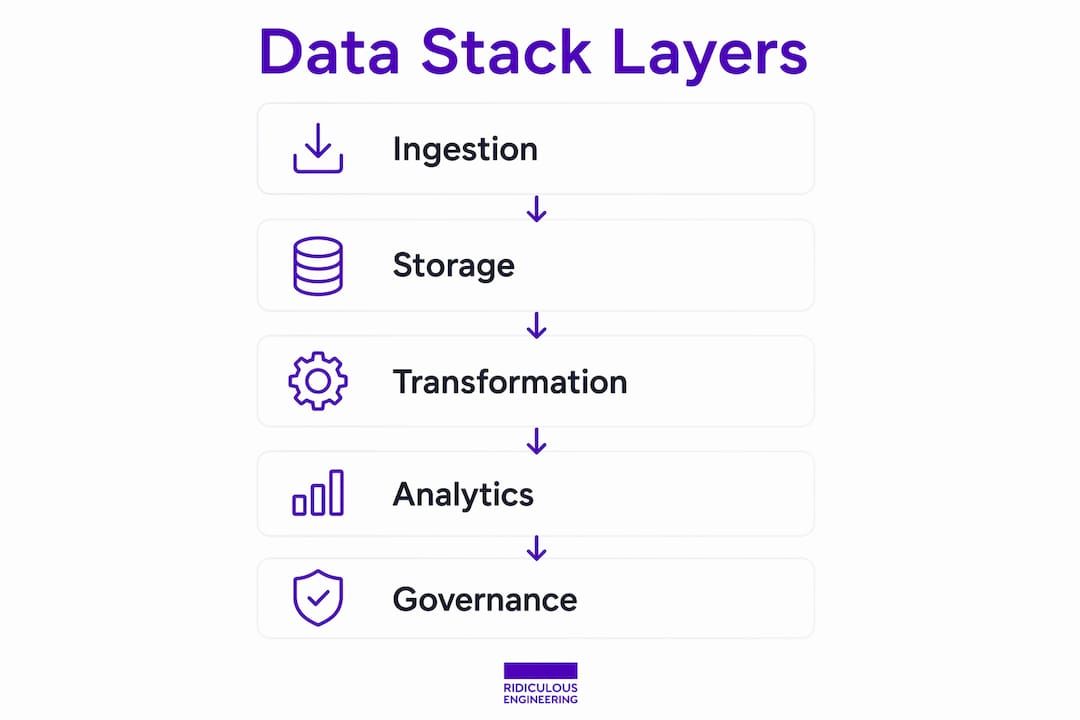
| Couche | Responsabilité | Signaux clés / contraintes | Propriétaire type |
|---|---|---|---|
| Ingestion | Déplacer les données brutes des sources vers l’entrepôt ; gérer la détection du schéma, les chargements incrémentiels et la CDC | Disponibilité des connecteurs, gestion des données personnelles, fréquence de synchronisation | Ingénieur data / équipe plateforme |
| Stockage / entrepôt | Stocker les données brutes et modélisées ; exécuter des requêtes SQL ; faire évoluer la capacité de calcul indépendamment | Modèle de coût des requêtes, concurrence, prise en charge des charges de travail ML | Équipe plateforme |
| Transformation | Convertir les tables brutes en ressources modélisées, testées et documentées à l’aide de SQL | Durée d’exécution des modèles, stratégie incrémentielle, couverture des tests | Ingénieur analytics |
| Orchestration | Planifier les DAG, relancer les échecs, déclencher des alertes en cas de panne et bloquer les traitements en aval lorsqu’un traitement en amont échoue | Complexité des pipelines, maîtrise de Python par l’équipe, solution gérée ou auto-hébergée | Ingénieur data |
| Qualité des données / Observabilité | Surveiller la fraîcheur, la dérive des schémas, les taux de valeurs nulles et les taux de réussite des tests ; déclencher des alertes avant que les parties prenantes ne s’en aperçoivent | Sensibilité aux SLA, exigences des contrats de données | Ingénieur analytics + équipe plateforme |
| Métriques / Couche sémantique | Définir les métriques métier une seule fois ; exposer des chiffres cohérents dans tous les outils de BI | Gouvernance des métriques, environnements BI multi-outils | Responsable analytics + responsables métier |
| BI / Analytics | Fournir des tableaux de bord, des requêtes ad hoc et une exploration en libre-service | Niveau technique du public, besoins d’intégration | Équipe analytics + responsables métier |
| ETL inversé / Activation | Réinjecter les données modélisées dans les outils opérationnels (CRM, plateformes marketing) | Fréquence de synchronisation, conformité relative aux données personnelles, limites de débit des API | Ingénieur data + opérations marketing/ventes |
| Streaming (si nécessaire) | Gérer le traitement d’événements à faible latence lorsque la fréquence des traitements par lots est insuffisante | SLA de latence, débit d’événements, capacité d’ingénierie | Plateforme / ingénierie data |
Quelques remarques sur les responsabilités méritent d’être formulées clairement. Les responsables métier définissent généralement la signification des métriques et valident les définitions de la couche sémantique. Les équipes plateforme sont responsables de l’infrastructure, des contrôles d’accès et du suivi des coûts. Les ingénieurs analytics se situent à l’intersection de l’ingénierie data et de l’analyse ; c’est à cet endroit que la plupart des architectures modernes réussissent ou échouent. Des SLA entre équipes sont nécessaires à la frontière entre l’ingestion et l’entrepôt (qui est responsable lorsqu’un connecteur source tombe en panne ?) ainsi qu’à la frontière entre la transformation et la BI (qui est responsable lorsqu’une métrique d’un tableau de bord est erronée ?).
Les erreurs courantes des équipes :
-
Ignorer la couche sémantique et laisser chaque rapport BI définir sa propre logique de métriques, ce qui produit des chiffres contradictoires entre les équipes.
-
Traiter l’orchestration comme facultative jusqu’à ce que les pipelines dépassent dix modèles, puis se précipiter pour l’intégrer après coup.
-
Attribuer l’observabilité à « qui que ce soit qui le remarque », ce qui signifie personne jusqu’à ce qu’une partie prenante le fasse.
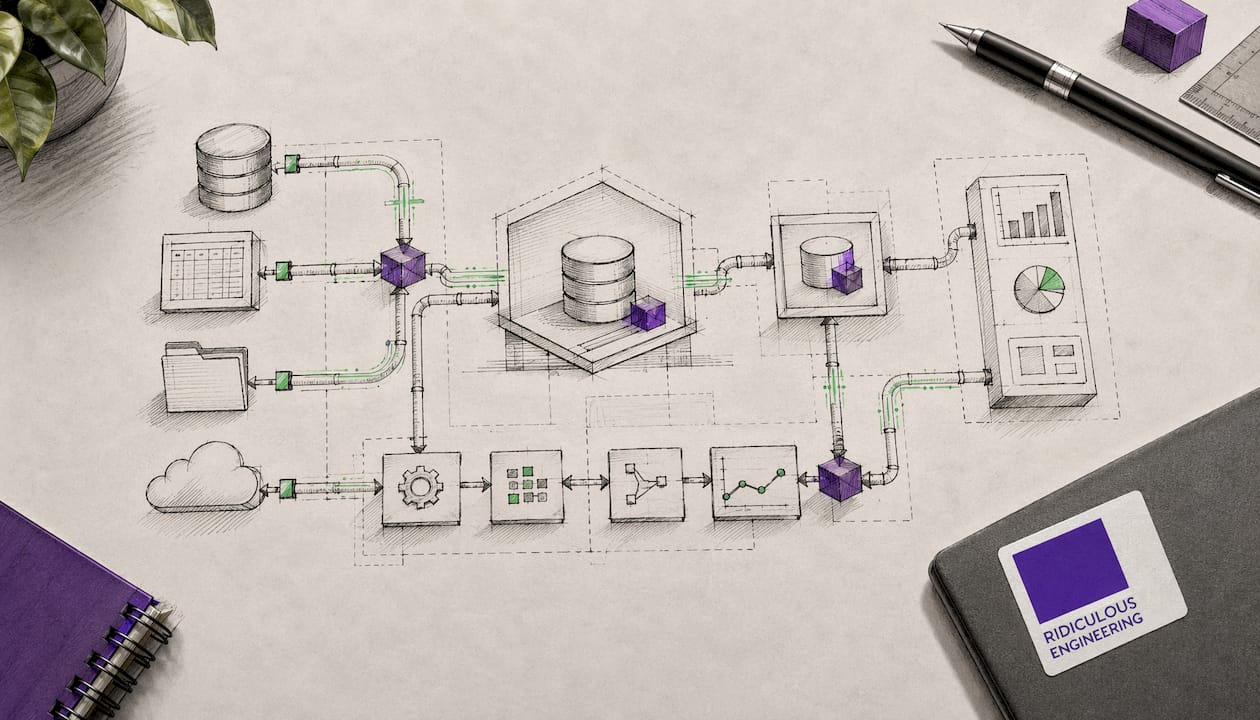
Quel modèle d’architecture correspond à votre situation ?
Centré sur l’entrepôt
Le choix par défaut pour la plupart des équipes. Un entrepôt de données cloud (Snowflake, BigQuery ou Databricks SQL) sert de hub. Les données brutes y sont acheminées via des connecteurs, dbt les transforme et les outils de BI les interrogent directement. Simple à exploiter, bien documenté et suffisant pour la majorité des charges de travail analytiques.
Lakehouse
Des formats de tables ouverts comme Apache Iceberg et Delta Lake reposent sur du stockage objet (S3, GCS, ADLS) et prennent en charge à la fois l’analyse SQL et l’entraînement des modèles de ML à partir des mêmes données physiques. Les architectures lakehouse réduisent la dépendance aux fournisseurs concernant les formats de stockage et constituent le bon choix lorsque les charges de travail de ML sont une priorité au même titre que la BI. Databricks est le point d’entrée le plus courant ; la prise en charge d’Iceberg par Snowflake a considérablement réduit l’écart.
Hybride
Un entrepôt gère les analyses gouvernées ; un lakehouse ou un lac de données gère l’expérimentation ML et le stockage brut à grande échelle. La complexité opérationnelle est plus élevée, mais cette approche convient aux organisations où les équipes ML et analytiques ont réellement des besoins différents et disposent de capacités d’ingénierie suffisantes pour maintenir les deux environnements.
Compléments de streaming
La pile moderne privilégie le traitement par lots. Les architectures de streaming (Kafka avec Flink, ou Spark Streaming) fonctionnent généralement aux côtés de l’entrepôt plutôt que de le remplacer. La promesse d’un « traitement unifié par lots et en streaming » est vantée depuis des années ; en pratique, les systèmes temps réel coexistent avec l’entrepôt et partagent rarement du code avec lui. N’introduisez le streaming que lorsqu’un SLA de latence l’exige réellement, et non parce que cela semble impressionnant. Pour approfondir les situations où les modèles temps réel sont rentables, modèles de données temps réel méritent d’être consultés avant de s’engager dans le coût de l’infrastructure.
Conseil pratique : Commencez par le modèle centré sur l’entrepôt. Ajoutez une couche lakehouse uniquement lorsque les charges de travail ML sont de qualité production et que l’équipe dispose d’un ingénieur plateforme dédié pour maintenir le format de table ouvert. N’ajoutez le streaming que lorsqu’un processus métier possède un SLA de latence documenté inférieur à cinq minutes, que le traitement par lots ne peut pas respecter.
En quoi une pile moderne diffère-t-elle d’une plateforme de données traditionnelle ?
Le contraste est plus marqué que ne le reconnaissent la plupart des propositions de migration.
Différences clés :
-
Modèle de déploiement. Les plateformes historiques s’exécutent sur site ou dans des VM autogérées. Les piles modernes utilisent des services cloud entièrement gérés, sans infrastructure à provisionner.
-
ETL contre ELT. L’ETL historique transforme les données avant leur arrivée dans l’entrepôt, souvent avec des outils propriétaires offrant un contrôle de version limité. L’ELT charge d’abord les données brutes, puis les transforme dans l’entrepôt à l’aide de SQL versionné dans Git.
-
Monolithique contre modulaire. Les plateformes historiques regroupent l’ingestion, la transformation et la mise à disposition dans un seul produit. Les piles modernes les séparent, ce qui permet une mise à l’échelle indépendante et une responsabilité claire entre les équipes.
-
Modèle de mise à l’échelle. Les systèmes sur site nécessitent une planification de capacité et l’achat de matériel. Les entrepôts cloud mettent leurs ressources de calcul à l’échelle en quelques secondes.
-
Reporting en libre-service contre reporting contrôlé par l’IT. Les systèmes historiques exigent généralement que l’IT crée chaque rapport. Les piles modernes exposent directement aux analystes et aux utilisateurs métier des tables modélisées.
Les évolutions architecturales qui ont rendu cela possible sont apparues successivement : le stockage objet cloud a rendu la conservation des données brutes peu coûteuse, les entrepôts cloud ont séparé le calcul du stockage et dbt a placé la logique de transformation dans Git. Ces trois changements, apparus entre environ 2016 et 2020, ont rendu la pile moderne viable pour les équipes sans budgets d’infrastructure importants.
Anti-modèles de migration à éviter : Une migration sans refactorisation (vous obtenez les coûts du cloud avec une architecture sur site), des chargements incrémentiels incontrôlés qui dupliquent silencieusement les enregistrements et l’omission de la mise en place de la gouvernance en supposant que vous l’ajouterez plus tard. Ce ne sera pas le cas, jusqu’à ce qu’un incident vous y contraigne.
Les plateformes historiques comportent de vrais risques opérationnels : les changements de schéma cassent les rapports en aval sans traçabilité permettant d’en mesurer l’impact, les contraintes de capacité créent des files d’attente pour les rapports et les procédures stockées accumulent une dette technique que personne ne veut toucher. Les avantages du cloud computing de l’approche moderne ne sont pas théoriques ; ils se traduisent par une réduction de la charge d’astreinte et des cycles d’itération plus rapides.
Quels outils devriez-vous réellement utiliser ?
L’ELT avec du SQL dans l’entrepôt a standardisé la couche de transformation, et dbt est l’outil par défaut pour gérer les modèles SQL. Le reste de la pile offre davantage de possibilités, mais l’heuristique de sélection reste cohérente : choisissez un outil par couche, privilégiez les services gérés plutôt que l’autogestion lorsque la capacité de l’équipe est limitée et prévoyez des contrôles FinOps dès le premier jour.
| Couche | Outils représentatifs | Idéal pour / remarques |
|---|---|---|
| Ingestion | Fivetran, Airbyte, AWS Glue, Azure Data Factory | Fivetran : géré, nombreux connecteurs, opérations minimales ; Airbyte : option open source ; Glue/ADF : pour les entreprises utilisant nativement AWS/Azure |
| Entrepôt de données | Snowflake, Google BigQuery, Databricks | Snowflake : orienté analytique, gouvernance robuste ; BigQuery : coût à grande échelle, sans serveur ; Databricks : charges de travail intensives en ML |
| Transformation | dbt (Cloud ou Core), SQLMesh | dbt est le choix par défaut ; SQLMesh est l’alternative émergente pour les exécutions tenant compte de l’état |
| Orchestration | Apache Airflow, Dagster, Prefect | Airflow est en tête en nombre de déploiements ; Dagster gagne du terrain pour les workflows fondés sur les actifs ; Prefect pour les équipes axées sur Python |
| Qualité des données / Observabilité | Tests dbt, Monte Carlo, Soda | Les tests dbt couvrent la plupart des besoins au début ; Monte Carlo et Soda assurent le suivi des SLA en production |
| Métriques / Couche sémantique | Couche sémantique dbt, Cube | Définir les métriques une seule fois ; les exposer à plusieurs outils de BI |
| BI / Analytique | Looker, Tableau, Power BI, Metabase | Looker pour la gouvernance des métriques ; Metabase pour un libre-service étendu ; Tableau/Power BI pour les rapports destinés aux dirigeants |
| ETL inversé / Activation | Census, Hightouch | Envoyer les données modélisées vers le CRM, les plateformes publicitaires et les outils opérationnels |
| Flux de données | Apache Kafka, Apache Flink, RisingWave | En parallèle de l’entrepôt ; à introduire uniquement lorsque le SLA de latence l’exige |
Critères de sélection pour les organisations américaines :
-
Si votre équipe compte moins de trois ingénieurs data, choisissez une ingestion gérée (Fivetran) et dbt Cloud plutôt que des alternatives auto-hébergées. Les économies opérationnelles dépassent le coût des licences.
-
Snowflake et BigQuery sont tous deux d’excellents choix par défaut ; la décision dépend généralement des relations existantes avec les fournisseurs cloud et du caractère prioritaire ou non des charges de travail de ML.
-
La multiplication des outils, avec huit outils SaaS ou plus, crée d’importantes frictions opérationnelles et financières. En pratique, de nombreuses équipes se limitent à quatre composants principaux : l’entrepôt, dbt, un orchestrateur et un outil de BI.
-
Apache Airflow est important à comprendre sur le plan conceptuel, mais son exécution sur Kubernetes nécessite une ingénierie de plateforme dédiée. Airflow géré (Cloud Composer, MWAA, Astronomer) constitue le choix pratique pour la plupart des équipes.
Quels contrôles de gouvernance et d’observabilité devriez-vous mettre en place dès le premier jour ?
Une gouvernance ajoutée après un incident coûte toujours plus cher qu’une gouvernance intégrée dès le départ. Il en va de même pour l’observabilité. Considérez-les toutes deux comme des fonctionnalités produit dotées de leurs propres SLA, et non comme de simples cases à cocher de conformité.
Piliers fondamentaux de la gouvernance :
-
Contrôle d’accès selon le principe du moindre privilège.Accès basé sur les rôles au niveau de l’entrepôt, avec des rôles distincts pour les données brutes, les données modélisées et les colonnes marquées comme contenant des données personnelles. Aucun analyste ne devrait avoir un accès en écriture aux schémas bruts.
-
Traçabilité et catalogage des données.La traçabilité intégrée de dbt couvre la couche de transformation. Étendez-la en amont (systèmes sources) et en aval (rapports BI) à l’aide d’un outil de catalogage ou des fonctionnalités de métadonnées natives de l’entrepôt.
-
Détection et masquage des données personnelles.Marquez les colonnes contenant des données personnelles au moment de l’ingestion. Appliquez des politiques de masquage dynamique dans l’entrepôt afin que les modèles en aval n’exposent jamais de données personnelles brutes aux rôles non autorisés.
-
Journalisation des audits. Chaque requête, chaque modification de schéma et chaque attribution de rôle doivent être journalisées. La plupart des entrepôts de données cloud proposent cette fonctionnalité nativement ; activez-la avant la mise en production.
-
Gouvernance des indicateurs. Définissez les indicateurs métier dans la couche sémantique, et non dans les rapports de BI individuels. Lorsque le « chiffre d’affaires » signifie la même chose partout, vous n’avez plus à assister à la réunion où deux équipes se disputent pour savoir laquelle de leurs valeurs est correcte.
Pour l’observabilité, les principaux indicateurs à surveiller sont la fraîcheur (quand cette table a-t-elle été mise à jour pour la dernière fois ?), la dérive du schéma (une colonne source a-t-elle disparu ?), les taux de valeurs nulles (un champ critique est-il soudainement vide ?) et les taux de réussite des tests dbt. Déclenchez des alertes sur ces éléments avant que les parties prenantes ne les remarquent. La qualité des données est directement corrélée à la fiabilité des modèles d’IA ; l’observabilité n’est donc pas seulement une préoccupation opérationnelle : c’est un investissement dans la préparation à l’IA.
Exemples de garde-fous de politique à adopter rapidement : seuls les ingénieurs de la plateforme peuvent exécuter des modèles dbt en actualisation complète en production ; les modifications de schéma dans les systèmes sources nécessitent un préavis de 48 heures et une analyse de l’impact en aval ; les colonnes contenant des informations personnelles identifiables nécessitent l’approbation d’un responsable des données avant que tout nouveau modèle y fasse référence.
Conseil pratique : Intégrez dès le premier jour la surveillance FinOps à votre pile d’observabilité. Une seule actualisation complète dbt non surveillée ou une resynchronisation de connecteur lors d’une modification de schéma peut multiplier par dix votre facture d’entrepôt de données en une semaine. Configurez des alertes sur les coûts des requêtes et des budgets de crédits d’entrepôt avant d’intégrer votre premier pipeline de production. Les cadres de gouvernance cloud fournissent un modèle de politique utile à cet effet.
Pour les piles compatibles avec l’IA, les considérations de sécurité vont au-delà de l’accès aux données. Les risques de sécurité liés à l’IA agentique constituent une préoccupation émergente en matière de gouvernance que les équipes chargées des plateformes de données doivent comprendre avant d’exposer des données gouvernées à des agents d’IA.
Comment planifier et construire une pile de données moderne ?
Feuille de route par phases
Phase 1 : Découverte (semaines 1 à 4). Auditez les sources de données existantes, identifiez les trois à cinq questions métier auxquelles la pile doit répondre dès le premier jour et documentez les flux de données actuels. Livrable : un inventaire des sources et une liste priorisée des cas d’utilisation.
Phase 2 : Projet pilote MVP (semaines 5 à 12). Mettez en place un entrepôt, un connecteur d’ingestion pour la source prioritaire, un projet dbt comprenant cinq à dix modèles et un tableau de bord de BI. Livrable : un pipeline fonctionnel et testé qui répond de bout en bout à une question métier.
Phase 3 : Extension (mois 4 à 9). Ajoutez des connecteurs pour les autres sources prioritaires, développez la couche de modèles dbt, introduisez l’orchestration lorsque les pipelines dépassent dix modèles et ajoutez la surveillance de l’observabilité. Livrable : une pile de niveau production couvrant les dix principaux cas d’utilisation.
Phase 4 : Mise en exploitation (mois 10 à 18). Formalisez les politiques de gouvernance, mettez en œuvre la couche sémantique, établissez des contrôles FinOps et documentez les accords de niveau de service. Livrable : une pile que l’équipe peut maintenir et étendre sans interventions héroïques.
Rôles et dimensionnement de l’équipe
| Rôle | Responsabilité | Petite équipe (1 à 5 personnes chargées des données) | Entreprise de taille intermédiaire (5) | Grande entreprise |
|---|---|---|---|---|
| Ingénieur analytique | Modèles dbt, qualité des données, couche sémantique | 1 (partagé avec des responsabilités d’analyste) | 2 à 4 | 4 à 8 |
| Ingénieur data | Ingestion, orchestration, exploitation de la plateforme | 1 (partagé) | 2 à 4 | 4 à 10 |
| Plateforme / infrastructure de données | Administration de l’entrepôt, sécurité, FinOps | Partagé avec l’ingénieur data | 1–2 dédiés | 2–5 dédiés |
| Analytique / BI | Développement de tableaux de bord, accompagnement des parties prenantes | 1 (partagé) | 2–4 | 4–10 |
| Gouvernance des données / sécurité | Politiques, contrôle des accès, conformité | Partagé avec la plateforme | 1 à temps partiel | 1–2 dédiés |
Pour des conseils sur les effectifs nécessaires à la constitution d’équipes data prêtes pour l’IA, la stratégie de recrutement pour les organisations prêtes pour l’IA couvre les lacunes de compétences que la plupart des équipes sous-estiment.
Liste de contrôle de mise en œuvre
-
Sélectionnez votre entrepôt de données et souscrivez-y (Snowflake, BigQuery ou Databricks), puis configurez des alertes de facturation avant d’y charger la moindre donnée.
-
Achetez une solution d’ingestion gérée (Fivetran ou équivalent) et documentez les SLA des connecteurs avec les responsables des systèmes sources.
-
Configurez un compte dbt Cloud et un dépôt Git ; mettez en place la protection des branches et les contrôles CI sur les modèles dbt.
-
Définissez le contrôle d’accès fondé sur les rôles dans l’entrepôt avant de charger toute donnée proche des informations personnelles identifiables.
-
Configurez le suivi des coûts des requêtes et fixez un seuil budgétaire mensuel déclenchant une alerte à 80 % d’utilisation.
-
Documentez les critères d’acceptation de la mise en production : taux minimal de réussite des tests, SLA de fraîcheur pour chaque table et validation des parties prenantes sur au moins un tableau de bord de bout en bout.
-
Planifiez une revue 30 jours après le lancement afin d’évaluer la fiabilité des pipelines, les coûts réels par rapport aux estimations et la capacité de l’équipe.
Facteurs déterminants de l’estimation des coûts : Le calcul de l’entrepôt est la variable dominante et évolue avec le volume de requêtes et la fréquence d’exécution des modèles. Les coûts des connecteurs évoluent avec le nombre de sources et la fréquence des synchronisations. Les politiques de conservation des données ont une incidence modérée sur les coûts de stockage. Une stratégie dbt incrémentale rigoureuse, plutôt que des exécutions avec actualisation complète, peut réduire considérablement les coûts de calcul de l’entrepôt sur les grandes tables.
Quels paris stratégiques devriez-vous faire au cours des 12–36 prochains mois ?
Consolidation autour des capacités natives de l’entrepôt
Le marché évolue vers un nombre réduit de plateformes plus performantes. Snowflake a ajouté Snowpark et Streamlit. Databricks a ajouté Delta Live Tables et un orchestrateur. Microsoft Fabric regroupe l’ingestion, la transformation et la BI au sein d’une même relation de facturation. Le calcul économique des achats évolue : les frais d’intégration et huit relations de facturation SaaS distinctes constituent en eux-mêmes une forme de difficulté opérationnelle. Pour la plupart des équipes, la stack appropriée en 2026 est plus réduite que la version de référence : un entrepôt, dbt, un orchestrateur et un outil de BI.
L’argument contraire est que les outils spécialisés restent plus performants que leurs équivalents natifs de l’entrepôt à chaque niveau. C’est souvent vrai. La question est de savoir si l’écart de performance justifie le coût d’intégration. Pour les équipes disposant d’une capacité limitée en ingénierie de plateforme, ce n’est généralement pas le cas. Pour les schémas de partage et de consolidation des données, les avantages opérationnels d’un nombre réduit de points d’intégration sont bien documentés.
Faire de la préparation à l’IA un objectif de conception de premier plan
La préparation à l’IA n’est pas une fonctionnalité que l’on ajoute à une stack data ; c’est la conséquence d’une stack correctement conçue dès le départ. Les prérequis sont la qualité des données (testées, surveillées et fiables), la traçabilité (de la source au modèle puis au résultat) et un petit jeu de données central, bien gouverné, auquel les agents d’IA peuvent faire confiance. Les bases vectorielles et les feature stores sont pertinents pour certains cas d’usage du machine learning, mais ils reposent sur un entrepôt bien gouverné et ne le remplacent pas. Préparation opérationnelle à l’IA générative dépend de la même fondation de données.
Conseil de pro : Avant d’investir dans une base de données vectorielle ou un feature store, auditez la couverture des tests de vos modèles dbt existants. Si le taux de réussite des tests est inférieur à 90 % sur les modèles critiques, les résultats d’IA construits à partir de ces données ne seront pas fiables, quelle que soit la sophistication du modèle. Corrigez d’abord les fondations.
Quand recruter et quand faire appel à un consultant
Engagez un ingénieur plateforme dédié lorsque le nombre de vos pipelines dépasse 20 et que votre ingénieur data consacre plus de 30 % de son temps à l’infrastructure plutôt qu’au travail sur les données. Faites appel à un partenaire externe comme Ridiculous Engineering lorsque vous devez raccourcir le délai entre la découverte et le MVP, lorsque vous manquez d’expérience interne en architecture pour la conception initiale, ou lorsqu’un audit de gouvernance ou de préparation à l’IA nécessite un point de vue extérieur. Le compromis de la consolidation SaaS entre les services gérés et les options auto-hébergées mérite d’être compris avant de prendre des engagements à long terme auprès de fournisseurs.
Considérations environnementales et de durabilité des piles de données cloud natives
Les piles de données cloud natives ont une véritable empreinte environnementale, qu’il est utile de comprendre avant de s’engager sur une configuration d’entrepôt et de calcul. Les principaux fournisseurs cloud (AWS, Google Cloud, Microsoft Azure) ont publié des engagements de neutralité carbone ou de zéro émission nette, et leurs centres de données hyperscale fonctionnent généralement avec une meilleure efficacité énergétique que les solutions sur site. Cet avantage en matière d’efficacité est réel, mais il ne rend pas le calcul cloud neutre en carbone.
Les principaux leviers pour réduire l’impact environnemental d’une pile de données sont l’efficacité du calcul et une gestion rigoureuse de la conservation des données. Des modèles dbt mal écrits qui exécutent des actualisations complètes sur de grandes tables gaspillent des ressources de calcul ; les modèles incrémentaux qui ne traitent que les nouveaux enregistrements n’en utilisent qu’une fraction. Les tableaux de bord inutilisés qui déclenchent des requêtes planifiées, les connecteurs synchronisés toutes les cinq minutes alors qu’une fréquence quotidienne suffirait, et les entrepôts laissés actifs sans suspension automatique contribuent tous à une consommation d’énergie inutile. Les contrôles FinOps qui réduisent les coûts réduisent également les émissions de carbone, ce qui fait converger les arguments commerciaux et environnementaux.
Les politiques de conservation des données sont également importantes. Stocker indéfiniment chaque événement brut dans un entrepôt coûte cher et consomme beaucoup d’énergie. Le stockage par niveaux (données actives dans l’entrepôt, données froides dans un stockage objet) réduit à la fois les coûts et la charge de calcul liée aux données historiques rarement interrogées. Les équipes qui considèrent la conservation des données comme une décision de gouvernance plutôt que comme un paramètre par défaut ont tendance à exploiter des piles plus légères, moins coûteuses et à moindre impact.
Points clés à retenir
Une pile de données moderne fondée sur l’ELT, la transformation SQL-first et les services gérés cloud natifs constitue la base la plus pratique pour accélérer l’analytique et la préparation à l’IA en 2026.
| Point | Détails |
|---|---|
| Commencer modestement et rester discipliné | Une pile de 4 outils (entrepôt + dbt + 1 orchestrateur + 1 outil de BI) est plus performante qu’un assemblage de 8 outils pour la plupart des équipes. |
| Prévoir les variations des coûts de calcul | Pour la plupart des équipes, les dépenses mensuelles s’élèvent à 500–2 000 $ pour les entreprises de 50 personnes et à 5 000–20 000 $ pour les entreprises de taille intermédiaire (50–200 employés) ; le calcul de l’entrepôt constitue le principal facteur de coût. |
| Mettre en place la gouvernance dès le premier jour | Les accès selon le principe du moindre privilège, le masquage des informations personnelles identifiables et les alertes FinOps doivent être configurés avant l’arrivée des données de production, et non après un incident. |
| La préparation à l’IA commence par la qualité des données | La couverture des tests, la traçabilité et la surveillance de l’actualité des données dans les modèles dbt sont des prérequis pour obtenir des résultats d’IA fiables. |
| Ridiculous Engineering accélère l’adoption | Ridiculous Engineering fournit des audits de découverte, la conception de MVP, l’ingénierie plateforme et la mise en place de la gouvernance afin de raccourcir le délai de mise en production. |
Ridiculous Engineering crée des piles de données modernes qui passent réellement en production
La plupart des équipes qui rencontrent des difficultés avec l’infrastructure de données ne manquent pas d’ambition. Elles manquent de temps, d’expérience en architecture, ou des deux. Ridiculous Engineering est un cabinet de conseil en ingénierie logicielle basé au Colorado qui conçoit, construit et met en exploitation des systèmes de données et d’analytique pour les organisations qui ont besoin d’une pile de niveau production sans devoir attendre six mois pour la mettre en place. Le modèle d’engagement est pragmatique : un audit de découverte ciblé pour cartographier vos sources et vos cas d’usage, une conception de MVP qui permet d’obtenir un pipeline fonctionnel en quelques semaines, et un accompagnement en ingénierie plateforme pour l’accompagner jusqu’à la gouvernance, la mise en place de FinOps et l’évaluation de la préparation à l’IA. Si votre équipe possède les compétences nécessaires mais a besoin de conseils en architecture, une courte mission de conseil suffit souvent à éviter les erreurs les plus coûteuses. Contactez Ridiculous Engineering pour définir une mission de découverte.
Sources utiles
-
The Modern Data Stack, Honestly Assessed — L’évaluation pratique la plus directe de l’architecture en 5 couches, de ses compromis et de l’orientation vers la consolidation en 2026. Source principale pour les fourchettes de coûts, les outils par défaut et les limites du streaming citées dans cet article.
-
How to Build a Modern Data Stack in 2026 — Guide pratique couvrant la domination de l’ELT/SQL, dbt comme choix par défaut pour la transformation et les options d’orchestration. Utile pour séquencer la mise en œuvre.
-
Modern Data Stack 2026: Complete Guide to Tools and Architecture — Modèles d’architecture incluant le lakehouse et les formats de tables ouverts ; panorama des outils d’orchestration avec Airflow, Dagster et Prefect.
-
What Is a Modern Data Stack and Why It Matters — Vue d’ensemble de ThoughtSpot reliant la qualité des données et l’observabilité à la préparation à l’IA. Utile pour les sections consacrées à la gouvernance et à la préparation à l’IA.
-
Modern Data Platform Architecture: Building a Data Stack That Scales — Analyse technique approfondie de la séparation du stockage et du calcul, ainsi que de SQL comme interface commune.
-
AWS Glue — Documentation principale du fournisseur concernant l’intégration de données serverless sur AWS ; référence pour les options d’ingestion natives AWS et de pipelines ELT.
-
Azure Data Factory — Documentation du service d’intégration de données géré de Microsoft ; référence pour la configuration des pipelines d’ingestion et ELT/ETL natifs Azure.
-
Fondation Apache Software — Source principale pour la documentation d’Apache Airflow, Apache Kafka, Apache Flink, Apache Iceberg et Apache Hudi.
-
Ridiculous Engineering: Le cloud computing au service de la croissance des entreprises — Conseils en matière d’architecture et de stratégie cloud pour les responsables technologiques qui conçoivent une infrastructure de données moderne.
-
Ridiculous Engineering: Comprendre l’IA et la qualité des données — Explique le lien entre la qualité des données, l’observabilité et la confiance accordée aux modèles d’IA.
FAQ
Qu’est-ce qu’une pile de données moderne ?
Une pile de données moderne est une infrastructure de données cloud native, fondée sur ELT et SQL, qui ingère les données brutes des systèmes sources, les stocke dans un entrepôt de données cloud ou un lakehouse, les transforme à l’aide de SQL (généralement avec dbt), puis les met à disposition des outils de BI et des charges de travail d’IA. Ses caractéristiques distinctives sont les services cloud gérés, la séparation du stockage et du calcul, ainsi qu’une logique de transformation contrôlée par version.
La pile de données moderne reste-t-elle une idée pertinente ?
Oui, ses principes fondamentaux sont établis et restent la bonne approche : services cloud natifs, ELT, transformation axée sur SQL et séparation du stockage et du calcul. Ce qui évolue, c’est la composition des outils. L’assemblage de huit outils spécialisés cède la place à la consolidation native de l’entrepôt : en 2026, la pile moderne comprend généralement quatre outils, et non huit.
Quelle est la différence entre une pile de données traditionnelle et une pile moderne ?
Les plateformes traditionnelles utilisent l’ETL (transformation avant chargement), s’exécutent sur une infrastructure sur site ou autogérée et nécessitent que le service informatique crée chaque rapport. Les piles modernes utilisent l’ELT (chargement des données brutes, puis transformation dans l’entrepôt avec SQL), s’exécutent sur des services cloud gérés et exposent directement les données modélisées aux analystes pour permettre le libre-service. Le modèle opérationnel et économique est fondamentalement différent.
Quels outils de pile de données sont tendance en 2026 ?
Les choix par défaut sont Snowflake ou Google BigQuery pour l’entrepôt, dbt pour la transformation, Apache Airflow (ou Dagster pour les nouvelles implémentations) pour l’orchestration, et Fivetran pour l’ingestion gérée. La tendance générale est à la consolidation : les fonctionnalités natives des entrepôts réduisent le besoin d’outils spécialisés distincts à chaque niveau.
Combien coûte une pile de données moderne par mois ?
Une entreprise utilisant la pile standard dépense généralement 500 à 2 000 $ par mois pour une équipe de 50 personnes, et 5 000 à 20 000 $ pour une entreprise de taille intermédiaire (50 à 200 employés). Ces coûts sont principalement dictés par les coûts de calcul de l’entrepôt, qui évoluent en fonction de la taille de l’équipe et de l’utilisation.