Gouvernance des LLM : un cadre pratique pour les dirigeants d’entreprise
Gouvernance des LLM : un cadre pratique pour les dirigeants d’entreprise La gouvernance des LLM regroupe les politiques, les rôles et les contrôles d’exécution qui encadrent le déploiement, la surveillance et la responsabilisation des grands modèles de langage en production.
Gouvernance des LLM : un cadre pratique pour les dirigeants d’entreprise
La gouvernance des LLM regroupe les politiques, les rôles et les contrôles d’exécution qui encadrent le déploiement, la surveillance et la responsabilisation des grands modèles de langage en production. Contrairement à la gouvernance traditionnelle de l’IA, qui vérifie principalement un modèle avant son lancement puis passe à autre chose, la gouvernance des LLM considère le déploiement comme le début de la fenêtre de risque, et non sa fin.
Si vous dirigez la technologie ou la gestion des risques dans votre organisation, voici les cinq premières mesures à prendre :
- Classer chaque cas d’usage par niveau de risque en fonction de son impact métier et de son degré d’autonomie, et pas seulement de la sensibilité des données.
- Désigner un responsable pour chaque modèle ou agent déployé, et pas seulement un responsable de l’« IA » au sens large.
- Mettre en place l’observabilité à l’exécution afin de voir les prompts, les réponses et les dérives au moment où elles se produisent.
- Filtrer le trafic au niveau de la couche API afin que les sorties problématiques soient filtrées avant d’atteindre les clients.
- Établir un plan d’audit couvrant les couches gouvernance, modèle et application, plutôt qu’une seule checklist préalable au lancement.
Voilà l’essentiel en quelques lignes. Le reste de ce guide explique comment le mettre en place.
À retenir
Une gouvernance efficace des LLM repose sur le déplacement du centre de gravité : passer d’une validation unique avant déploiement à une observabilité continue à l’exécution, associée à des audits coordonnés sur trois couches.
| Point | Détails |
|---|---|
| Le périmètre dépasse le modèle | La gouvernance doit couvrir les prompts, les pipelines RAG, les comportements agentiques, les fournisseurs et les flux de données, et pas seulement les poids du modèle. |
| La surveillance à l’exécution est le contrôle principal | L’observabilité continue des prompts, des sorties et des KRI détecte les dérives que les tests préalables au lancement ne permettent pas de repérer. |
| Auditer selon trois couches coordonnées | Les audits de gouvernance, de modèle et d’application doivent s’alimenter mutuellement en preuves, et non fonctionner en vase clos. |
| Désigner des responsables nommément | Chaque cas d’usage à haut risque nécessite un responsable des risques clairement identifié, et non une boîte de réception d’équipe partagée. |
| Faire appel tôt à l’ingénierie | Ridiculousengineering développe l’infrastructure de filtrage du trafic, de journalisation et de surveillance dont dépendent les politiques de gouvernance. |
Table des matières
- Que couvre réellement la gouvernance des LLM ?
- Quels principes doivent guider votre politique de gouvernance des LLM ?
- Quels composants constituent un cadre de gouvernance des LLM ?
- Comment auditer un système LLM ?
- Quels contrôles à l’exécution préviennent réellement les incidents liés aux LLM ?
- Comment mettre en œuvre la gouvernance des LLM au quotidien ?
- Quelles erreurs devez-vous éviter dans la gouvernance des LLM ?
- À quoi doivent ressembler vos 90 premiers jours de gouvernance des LLM ?
- Construire soi-même l’infrastructure de gouvernance
- Sources
- FAQ
Que couvre réellement la gouvernance des LLM ?
La gouvernance des LLM va bien au-delà du fichier du modèle lui-même. Elle couvre le modèle, la surface des prompts, les pipelines de récupération, les workflows agentiques, les intégrations tierces, les contrats fournisseurs et les données qui circulent dans l’ensemble. Si vous ne gouvernez que les poids du modèle, vous ne gérez peut-être qu’un tiers de votre véritable surface de risque.
Voici la distinction qui déroute la plupart des équipes : la gouvernance traditionnelle du ML part du principe qu’un modèle produit des sorties cohérentes et déterministes pour une entrée donnée, et qu’il suffit de le valider une fois sur un jeu de test. Les LLM ne fonctionnent pas ainsi. Le même prompt peut produire des sorties différentes d’une exécution à l’autre. De petites modifications du prompt peuvent entraîner des comportements radicalement différents. Et dès que vous ajoutez la génération augmentée par récupération (RAG) ou l’utilisation d’outils agentiques, vous introduisez des comportements émergents qu’aucune suite de tests statiques ne détecte. Des recherches sur les systèmes LLM multi-agents ont montré que des agents individuellement « sûrs » peuvent malgré tout produire des systèmes dangereux une fois qu’ils interagissent, en raison de défaillances en cascade et d’un biais de conformité entre agents.
Ce risque concerne une plus grande partie de l’entreprise que ne le supposent la plupart des dirigeants. Les systèmes concernés comprennent généralement :
- Les bots de service client et l’automatisation du support
- La gestion des connaissances internes et les outils de recherche
- Les copilotes analytiques qui résument des données sensibles
- L’automatisation des workflows avec accès en écriture aux systèmes de production
- Tout agent capable d’effectuer une action (envoyer un e-mail, émettre un remboursement, modifier un enregistrement)
Conseil pratique : Considérez un cas d’usage comme présentant une « forte matérialité » dès qu’il peut effectuer une action autonome, accéder à des données réglementées ou atteindre un client externe sans étape de validation humaine. C’est la matérialité, et non la taille du modèle, qui doit déterminer le niveau de contrôle de gouvernance appliqué à un cas d’usage.
Quels principes doivent guider votre politique de gouvernance des LLM ?
Toute politique de gouvernance des LLM doit s’appuyer sur un petit ensemble de principes qui se traduisent par de véritables contrôles, et non par des formules ambitieuses destinées à une présentation. Six d’entre eux font l’essentiel du travail :
- Transparence: Les utilisateurs et les parties prenantes internes doivent savoir quand ils interagissent avec un LLM et comprendre approximativement comment il est parvenu à une sortie.
- Responsabilisation: Une personne ou une équipe nommément désignée est responsable du comportement de chaque modèle déployé, de bout en bout.
- Sécurité et fiabilité: Le système se dégrade progressivement et dispose d’un mécanisme de secours lorsque le niveau de confiance est faible.
- Protection des données: Les entrées et les sorties respectent les engagements en matière de résidence des données, de conservation et de confidentialité.
- Équité: Les sorties sont vérifiées pour détecter les impacts disproportionnés entre les groupes d’utilisateurs, et pas seulement l’exactitude globale.
- Auditabilité: Chaque décision importante laisse une trace qu’un tiers pourrait examiner ultérieurement.
Chaque principe correspond à une partie prenante différente, ce qui explique précisément pourquoi la gouvernance échoue lorsqu’elle est considérée comme la responsabilité d’une seule équipe. Le service juridique s’intéresse surtout à la transparence et à la protection des données. La sécurité est responsable de la fiabilité et du contrôle des accès. Le produit est responsable de l’équité et de l’expérience utilisateur. Le conseil d’administration veut surtout de la responsabilisation, c’est-à-dire une réponse claire à la question « qui a validé cela et qui devons-nous appeler en cas de problème ? »
Sur le plan opérationnel, ces principes ne sont pas de simples valeurs : ce sont des artefacts. La transparence devient une notice d’information et une fiche modèle. La responsabilisation devient un registre de validation. L’auditabilité devient une trace conservée des prompts, du contexte récupéré et des sorties. Si un principe ne produit pas un document, un tableau de bord ou un point de contrôle quelque part dans votre pipeline, ce n’est pas encore de la gouvernance : c’est un énoncé d’intention.
Quels composants constituent un cadre de gouvernance des LLM ?
Un cadre de gouvernance des LLM n’est efficace qu’à la mesure des artefacts qui le sous-tendent. Les principes n’empêchent pas un mauvais déploiement ; en revanche, l’absence d’une fiche modèle ou d’un responsable des risques désigné le permet. Voici ce qui doit réellement exister :
Artefacts requis :
- Une grille de classification des risques qui évalue les cas d’usage selon leur autonomie, la sensibilité des données et leur rayon d’impact
- Un inventaire des modèles répertoriant chaque LLM, modèle ajusté et fournisseur API en production
- Des fiches modèles documentant la provenance des données d’entraînement, les limitations connues et l’usage prévu
- Des contrôles d’accès et de tokens définissant quels systèmes et utilisateurs peuvent appeler quels modèles
- La traçabilité des données indiquant quelles données entrent dans les prompts et où les sorties sont stockées
- Des points de validation exigeant une approbation avant la mise en production d’une modification de modèle ou de prompt
- Des procédures d’intervention pour répondre aux incidents lorsqu’un modèle se comporte mal en production
- Des tableaux de bord de surveillance faisant apparaître les indicateurs clés de risque (KRI) presque en temps réel
Éléments de politique et de processus :
- Des validations du cycle de vie à chaque étape : développement, préproduction, production et retrait
- L’évaluation des modèles tiers avant l’achat, avec notamment un examen de la sécurité et des biais
- Des clauses contractuelles couvrant le traitement des données, les notifications de mise à jour du modèle et la responsabilité
- Des accords de niveau de service définissant les seuils acceptables de latence, de disponibilité et de délai d’escalade
Rien de tout cela ne doit être lancé simultanément. Attribuez chaque artefact à un responsable et fixez une échéance : la sécurité prend en charge les contrôles d’accès et la portée des tokens, l’ingénierie les fiches modèles et les tableaux de bord de surveillance, le service juridique les contrats fournisseurs et la documentation de traçabilité des données, et le produit la grille de classification des risques avec la contribution de toutes les autres fonctions. Le MindForge AI Risk Management Handbook présente un modèle opérationnel similaire pour les institutions financières, et sa logique de classification des risques s’applique facilement à presque tout déploiement réglementé ou destiné aux clients.
Comment auditer un système LLM ?
L’audit d’un système LLM exige trois couches distinctes ; considérer l’une d’elles comme suffisante à elle seule est la raison pour laquelle les programmes de gouvernance échouent discrètement. La recherche sur l’audit des grands modèles de langage les présente comme des audits de gouvernance, de modèle et d’application, coordonnés de manière à ce que les preuves de chaque couche éclairent les autres.
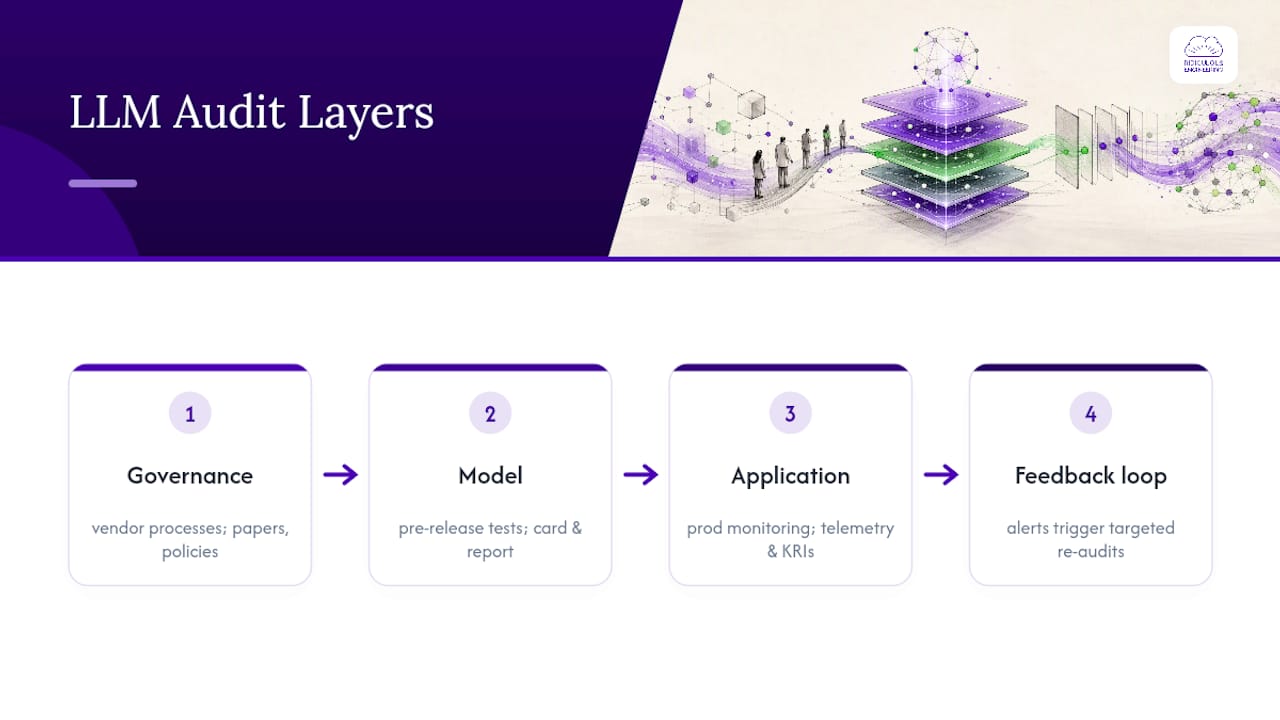
Audits de gouvernance Ils examinent le fournisseur et les processus internes qui produisent le modèle : approvisionnement en données d’entraînement, pratiques de gestion de la qualité et normes de développement documentées. Les preuves sont ici principalement constituées de pistes documentaires, d’attestations de fournisseurs et de documents de politique. Elles indiquent si le processus ayant construit le modèle était solide, mais ne disent rien de son comportement une fois en production.
Audits du modèle Ils interviennent après le pré-entraînement et avant la publication. C’est là que le red teaming et les tests adverses sont utiles : ils recherchent les jailbreaks, les biais, les taux d’hallucination et les défaillances dans les cas limites avant que le modèle n’interagisse avec un client. Le résultat doit être une fiche modèle et un rapport de méthodologie de test avec des seuils de réussite et d’échec. La limite devient évidente : un audit de modèle est un instantané, et le comportement d’un LLM évolue lorsque les prompts, les sources récupérées et les populations d’utilisateurs changent.
Audits d’application C’est la couche que la plupart des organisations négligent, alors qu’elle est la plus importante en pratique. Il s’agit de contrôles continus orientés production qui observent les prompts et les sorties réels, suivent des KRI comme le taux d’hallucination et le taux de refus, et signalent les dérives au moment où elles se produisent. Une analyse de la gestion des risques liés aux modèles d’IA générative l’établit clairement : la validation statique préalable au déploiement ne suffit pas pour les systèmes d’IA générative, et la surveillance continue associée à un examen de conformité augmenté par l’IA joue le rôle principal.
Les trois couches doivent s’alimenter mutuellement. Une modification notable des indicateurs de risque issue de la surveillance des applications doit déclencher un audit ciblé du modèle. Une modification de la déclaration des données d’entraînement d’un fournisseur doit déclencher une actualisation de l’audit de gouvernance.
Conseil pratique : Construisez un pipeline de preuves unique qui archive les rapports d’audit, diffuse la télémétrie d’exécution et consigne les mesures correctives au même endroit. Lorsqu’un régulateur ou un membre du conseil demande « prouvez-le », vous devez pouvoir interroger un seul système, plutôt que solliciter trois équipes.
Quels contrôles à l’exécution préviennent réellement les incidents liés aux LLM ?
Les contrôles à l’exécution, et non les checklists préalables au lancement, détectent la plupart des incidents liés aux LLM avant qu’ils n’atteignent un client. C’est ici que la gouvernance cesse d’être un document de politique pour devenir du code.
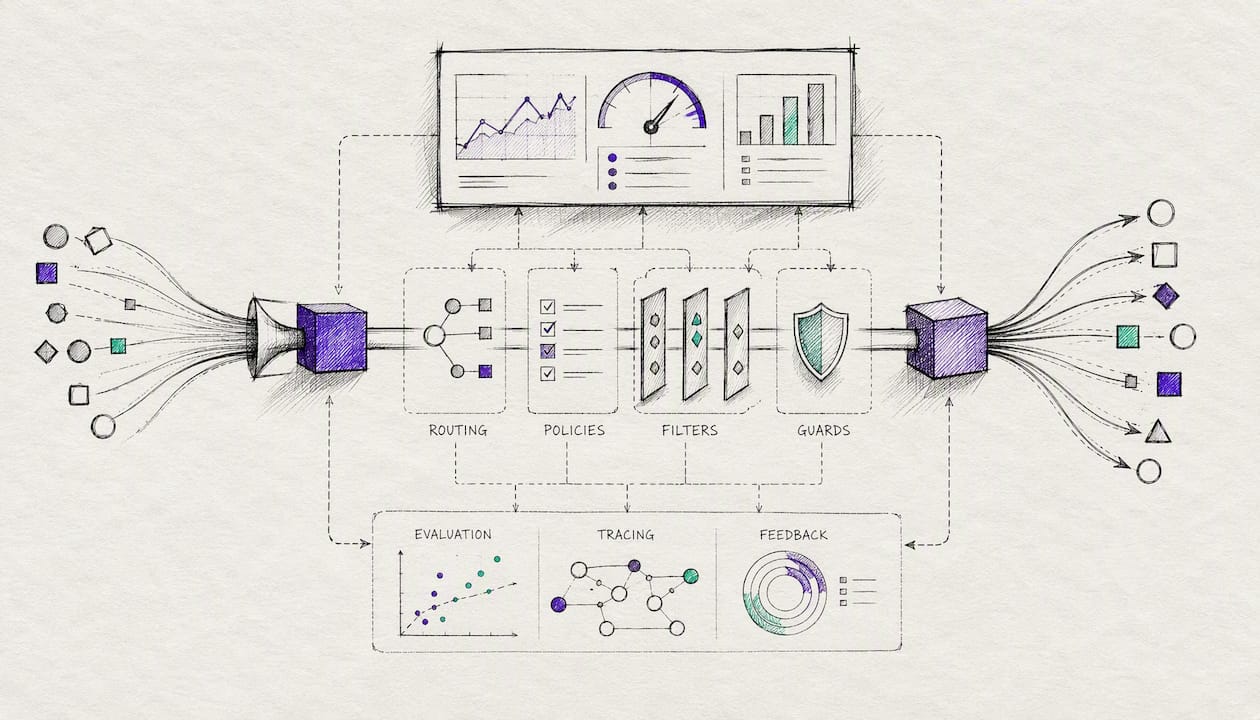
La gouvernance du trafic se situe au niveau de la API passerelle. Le filtrage au niveau de la passerelle peut bloquer les prompts correspondant à des schémas d’injection connus, limiter les tokens afin qu’une intégration donnée ne puisse appeler que des points de terminaison de modèles approuvés et limiter le débit des appels par cas d’usage pour contenir le rayon d’impact en cas de problème. Orienter les cas d’usage à haut risque vers un pool de modèles plus petit et évalué plus rigoureusement, plutôt que vers un modèle généraliste de pointe, réduit encore l’exposition. Les plateformes partenaires conçues pour une gouvernance au niveau API, comme l’ approche de Jundago pour tester et gouverner les API, montrent comment ce modèle s’étend naturellement aux couches REST et GraphQL, au-delà du seul trafic LLM.
Les contrôles RAG et de récupération sont tout aussi importants. Suivez la provenance de chaque fragment récupéré afin de savoir quelle source a servi à produire une réponse. Masquez les champs sensibles avant leur insertion dans un prompt. Mettez en place des garde-fous de rappel lors de la récupération afin que le système ne puise pas silencieusement dans des index obsolètes ou non autorisés. Verrouillez l’accès au magasin d’embeddings avec la même rigueur que celle appliquée à une base de données de production, car c’est effectivement ce qu’il est.
L’observabilité est le tissu conjonctif. Journalisez les prompts et les réponses (avec une rédaction appropriée), capturez les traces de débogage des appels ayant échoué et instrumentez côte à côte les tableaux de bord des coûts, de la latence et des KRI. Les recommandations de SANS sur les contrôles de l’IA fondés sur les risques préconisent de surveiller spécifiquement le taux d’hallucination, les tentatives de jailbreak et la dérive des prompts comme des métriques continues, et non comme des tests ponctuels.
Voici un modèle qu’il vaut la peine d’adopter directement : faites passer les sorties par un panel de modèles juges plus petits et spécialisés, qui les évaluent selon des critères de confidentialité, de sécurité et de conformité réglementaire, puis agrégez les résultats en un score de conformité unique. Cette approche de « profil comme jury », décrite dans des recherches récentes sur la surveillance de la conformité à l’exécution, évite le risque de monoculture lié au fait de s’en remettre à l’auto-évaluation d’un seul modèle.
Checklist d’ingénierie :
- Définir un schéma de journalisation couvrant les prompts, les réponses, le contexte récupéré et la version du modèle
- Définir des politiques de conservation alignées sur vos engagements de protection des données
- Créer des mécanismes d’escalade qui alertent un humain lorsque les KRI dépassent un seuil
- Intégrer le scoring du panel de juges ou du point de contrôle de conformité directement dans le pipeline de déploiement
Comment mettre en œuvre la gouvernance des LLM au quotidien ?
La mise en œuvre de la gouvernance des LLM commence par une structure légère, et non par la création d’un nouveau service. La plupart des organisations ont besoin de trois éléments : un comité central de gouvernance qui définit la politique et les seuils de risque, des responsables des risques intégrés à chaque ligne métier qui connaissent au mieux leurs cas d’usage, et des garde-fous d’ingénierie intégrés directement au pipeline de déploiement.
Le modèle des trois lignes de défense s’adapte bien aux LLM :
- Première ligne: L’équipe qui construit ou déploie le modèle est responsable de la gestion quotidienne des risques, notamment des fiches modèles et des tests initiaux.
- Deuxième ligne: Les équipes risques, juridique et sécurité examinent les déploiements au regard de la politique, mènent des red teams indépendants et assurent la maintenance des points de contrôle de conformité.
- Troisième ligne: L’audit interne vérifie périodiquement que les deux premières lignes font effectivement ce qu’elles déclarent, en utilisant comme sources les preuves issues des audits sur trois couches.
Un rythme opérationnel efficace pourrait être le suivant :
- Réception: Le nouveau cas d’usage est classé par niveau de risque avant le début de tout développement
- Validation: Le responsable des risques et l’évaluateur de deuxième ligne approuvent le niveau et les contrôles requis
- Checklist de déploiement: L’ingénierie confirme que la journalisation, le filtrage et le mécanisme de secours sont actifs avant le lancement
- Revue de la surveillance: Vérification hebdomadaire ou bimensuelle des tableaux de bord KRI pour les cas d’usage du niveau le plus élevé
- Audit trimestriel: Audit coordonné de la gouvernance, du modèle et de l’application pour les systèmes importants
Suivez régulièrement un petit ensemble de KPI et de KRI : taux d’hallucination, taux de réussite des points de contrôle de conformité, taux de faux positifs et de faux négatifs des filtres de contenu, et délai moyen d’atténuation après le signalement d’un problème. Ces chiffres comptent davantage pour un conseil d’administration qu’une description narrative de votre processus, car ils montrent les tendances.
Checklist du déploiement initial :
- Répertorier chaque LLM et agent actuellement en production ou en phase pilote
- Choisir les outils d’observabilité avant les outils de politique ; vous ne pouvez pas gouverner ce que vous ne voyez pas
- Adopter la politique sous forme de code lorsque cela est possible, afin que les points de contrôle soient appliqués automatiquement plutôt que de dépendre d’une revue manuelle
- Définir la durée de conservation des journaux d’audit avant le premier audit trimestriel, et non après
Quelles erreurs devez-vous éviter dans la gouvernance des LLM ?
Les erreurs de gouvernance des LLM les plus coûteuses sont structurelles, et non techniques. Certaines reviennent régulièrement.
Considérer la gouvernance comme un problème informatique uniquement exclut le juridique, le produit et le conseil d’administration de décisions qu’ils devraient prendre. Corrigez cela en désignant des responsables des risques dans les métiers, et pas seulement une file de tickets en ingénierie.
S’appuyer excessivement sur la validation préalable au déploiement donne une fausse impression de confiance. Un modèle qui a réussi un red team en janvier peut avoir dérivé en juin, à mesure que les prompts, les utilisateurs et les sources de récupération changent. C’est la surveillance à l’exécution qui détecte ce phénomène, et non un rapport ponctuel.
Le risque de monoculture apparaît lorsqu’un seul modèle (ou l’auto-évaluation d’une seule famille de modèles) évalue sa propre conformité. Les panels de juges multi-modèles réduisent cet angle mort.
Ignorer la dérive des prompts et des usages signifie que personne ne remarque lorsque vos prompts de production s’écartent progressivement de ceux qui ont été testés. Versionnez et journalisez les prompts comme vous le feriez pour du code.
Des contrats tiers insuffisants vous exposent lorsqu’un fournisseur modifie un modèle sans préavis. Exigez des notifications de mise à jour et des droits d’audit dans chaque accord fournisseur.
Si vous ne devez transmettre qu’un seul avertissement à votre équipe dirigeante, faites-en celui-ci : un audit réussi avant le lancement ne vous apprend presque rien sur le risque du trimestre suivant.
À quoi doivent ressembler vos 90 premiers jours de gouvernance des LLM ?
Mettre en place la gouvernance des LLM en 90 jours est réaliste si vous procédez dans le bon ordre. Essayer de tout faire au cours du premier mois est le meilleur moyen de bloquer le programme.
Jours 1 à 30 :
- Réaliser un inventaire complet des modèles et des cas d’usage
- Classer chaque cas d’usage par niveau de risque à l’aide d’une grille simple : élevé, moyen ou faible
- Désigner des responsables nommément pour chaque cas d’usage de niveau élevé
- Mettre en place une journalisation de base des prompts, des réponses et de la version du modèle
- Définir un mécanisme de secours d’urgence (transfert à un humain ou désactivation de la fonctionnalité) pour les flux à haut risque
Jours 31 à 60 :
- Déployer le filtrage du trafic de la passerelle API pour les flux présentant les risques les plus élevés
- Publier des fiches modèles pour chaque modèle en production
- Automatiser au moins trois KRI (taux d’hallucination, taux de refus, latence)
- Définir votre rythme d’audit et les personnes présentes dans chacune des trois lignes de défense
Jours 61 à 90 :
- Mener un exercice de red team sur votre cas d’usage présentant la plus forte matérialité
- Réaliser un premier audit coordonné couvrant les couches gouvernance, modèle et application
- Rédiger un rapport pour le conseil d’administration résumant les niveaux de risque, les KRI et les mesures correctives en suspens
Parmi les objectifs initiaux utiles, on peut citer la garantie que tous les flux à haut risque disposent d’une procédure d’intervention documentée dans les deux mois, que l’escalade des dépassements d’indicateurs de risque intervient rapidement et que les taux de réussite des points de contrôle de conformité sont suivis fréquemment plutôt qu’occasionnellement.
Construire soi-même l’infrastructure de gouvernance
La plupart des éléments décrits dans ce guide — le schéma de journalisation, la passerelle de trafic, les points de contrôle de conformité et le pipeline de fiches modèles — ne relèvent pas de la définition de politiques. C’est de l’ingénierie logicielle. Et c’est généralement là que les programmes de gouvernance s’enlisent : les équipes juridiques et risques peuvent rédiger la politique, mais quelqu’un doit encore construire la passerelle qui applique la portée des tokens, le tableau de bord qui affiche les KRI en temps réel et la piste d’audit capable de résister aux questions d’un régulateur.
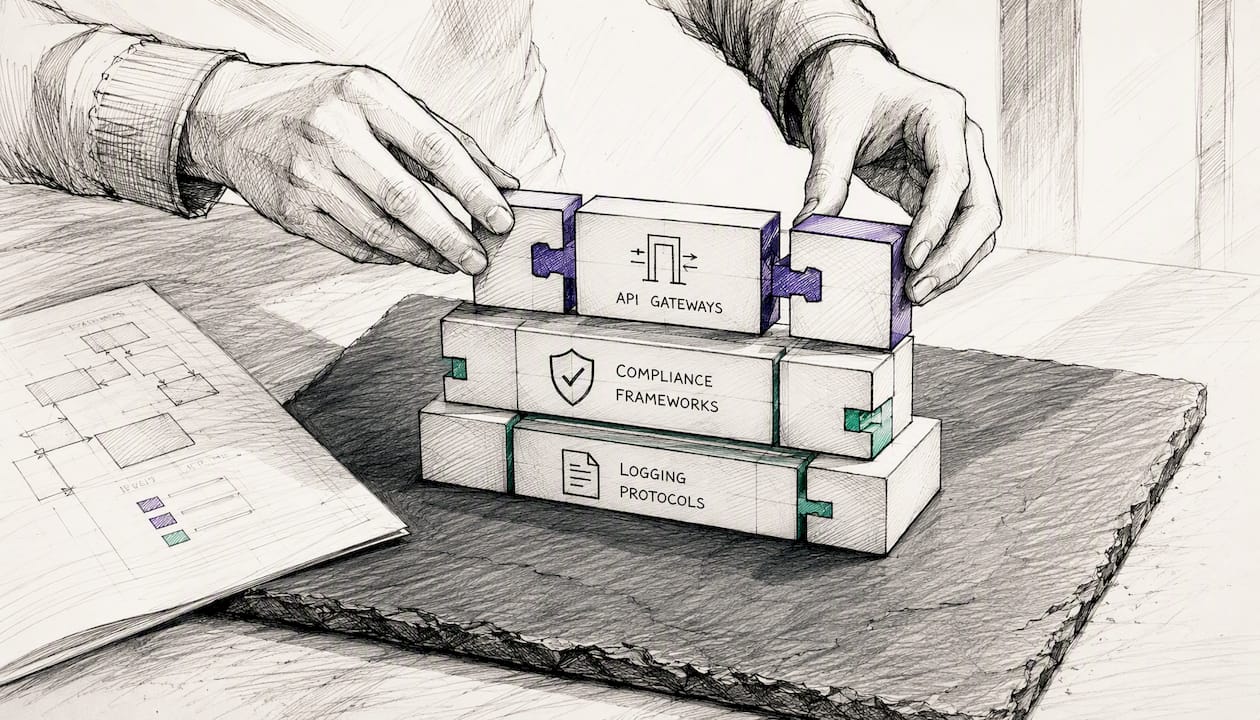
C’est le rôle que joue Ridiculousengineering. Nous construisons l’infrastructure d’exécution, les passerelles API, les pipelines d’observabilité, le renforcement des systèmes RAG et les tableaux de bord de surveillance qui transforment une politique de gouvernance des LLM, document théorique, en un dispositif réellement opérationnel en production. Si vous modernisez des systèmes existants pour ajouter des fonctionnalités d’IA en toute sécurité, ou si vous avez besoin d’un développement logiciel sur mesure pour mettre en place la couche de filtrage du trafic et de journalisation prévue par votre plan de gouvernance, c’est exactement le type de mission que nous menons. Contactez-nous et nous définirons ce à quoi devraient réellement ressembler vos 90 premiers jours de mise en œuvre technique.
Sources
Quelques sources méritent d’être ajoutées à vos favoris si vous développez davantage ce programme. Le NIST AI Risk Management Framework reste la norme la plus facilement transposable pour cartographier, mesurer et gérer les risques liés à l’IA dans tous les secteurs. L’article sur l’audit en trois couches constitue l’explication la plus claire disponible des audits de gouvernance, de modèle et d’application. Pour la conformité à l’exécution, le cadre de gouvernance fondé sur les métriques détaille de manière concrète le scoring par panel de juges et les points de contrôle de conformité. Le manuel MindForge propose un modèle opérationnel pour les secteurs réglementés qui s’applique bien au-delà de la finance. Le modèles-to-metrics framework est utile pour traduire les principes en artefacts mesurables. Enfin, l’analyse de la gestion des risques liés aux modèles d’IA générative défend très solidement la surveillance continue face à la validation statique.
- Auditing large language models: a three-layered approach
- Effective generative AI model risk management (finance/insurance review)
- MindForge AI Risk Management Executive Handbook (MAS consortium)
FAQ
Que signifie LLM ?
LLM signifie « large language model », soit grand modèle de langage : il s’agit d’un type de système d’IA entraîné sur de grands ensembles de données textuelles pour générer et comprendre le langage naturel, comme ChatGPT et Claude.
Quels sont les quatre modèles de gouvernance ?
Les cadres de gouvernance varient selon le domaine, mais la gouvernance d’entreprise et la gouvernance informatique font généralement référence à quatre grands modèles : orienté vers les actionnaires, orienté vers les parties prenantes, hiérarchique ou réglementaire, et en réseau ou collaboratif ; la gouvernance des LLM s’inspire généralement surtout des approches orientées vers les parties prenantes et des approches réglementaires, compte tenu de la combinaison des intérêts juridiques, de sécurité et produit.
ChatGPT est-il un LLM ou une IA générative ?
ChatGPT est les deux : il repose sur un grand modèle de langage (un LLM) et appartient à la catégorie plus large de l’IA générative, qui comprend tout système créant de nouveaux contenus tels que du texte, des images ou du code.
Quel est le salaire associé à un diplôme LLM ?
Cette question fait généralement référence à un diplôme de Master of Laws (LL.M.), une spécialisation juridique, et non à un grand modèle de langage ; les salaires des diplômés d’un LL.M. varient fortement selon la spécialisation, le pays et le cabinet, et cet article ne traite pas des débouchés de la formation juridique.
Comment commencer la gouvernance des LLM lorsqu’aucun programme n’existe aujourd’hui ?
Commencez par réaliser un inventaire complet des modèles et des cas d’usage, classez chaque cas d’usage par niveau de risque, désignez des responsables nommément et mettez en place une journalisation de base avant d’ajouter des documents de politique formels ; le travail d’infrastructure et d’observabilité nécessite souvent un effort d’ingénierie dédié, et un partenaire comme Ridiculousengineering peut accélérer le calendrier.
Recommandé
- Licence morale pour l’IA : stratégies éthiques | Ridiculous Engineering | Ridiculous Engineering
- Perspectives et stratégies commerciales pour réussir une startup | Ridiculous Engineering
- Infrastructure d’IA souveraine et contrôle des données au niveau du conseil d’administration | Ridiculous Engineering