System Data Sync: Ein operatives Handbuch für Engineering- und Business-Leiter
System Data Sync: Ein operatives Handbuch für Engineering- und Business-Leiter Systemdatensynchronisation ist der kontinuierliche oder geplante Prozess der Weitergabe von Änderungen zwischen zwei oder mehr Systemen, sodass jeder Teilnehmer eine konsistente, vereinbarte Sicht auf dieselben Daten hat.
System Data Sync: Ein operatives Handbuch für Engineering- und Business-Leiter
Systemdatensynchronisation ist der kontinuierliche oder geplante Prozess der Weitergabe von Änderungen zwischen zwei oder mehr Systemen, sodass jeder Teilnehmer eine konsistente, vereinbarte Sicht auf dieselben Daten hat. Verwenden Sie es, wenn mehrere Systeme über die Zeit einen Live- oder nahezu Live-Status teilen müssen. Wählen Sie stattdessen Migration, wenn Sie eine einmalige Umstellung benötigen, und Replikation, wenn Ihr Ziel Leseskalierung oder Disaster Recovery ist und nicht systemübergreifende Konsistenz.
Urteil: Wenn Ihr CRM, ERP und Data Warehouse jeweils eine andere Version desselben Kundendatensatzes halten, haben Sie ein Sync-Problem. Die richtige Lösung beginnt mit einer Sync-Bereitschafts-Checkliste, nicht mit einem Tool-Kauf.
Bevor Sie weiterlesen, sind drei Dinge zu bestätigen:
- Sie haben identifiziert, welches System den maßgeblichen Datensatz für jede Datendomäne besitzt.
- Sie wissen, ob Ihre Latenzanforderung Sub-Sekunden, Minuten oder Stunden beträgt.
- Sie haben einen Rollback-Plan, falls die Sync-Pipeline beschädigte oder doppelte Datensätze erzeugt.
Profi-Tipp: Führen Sie eine Feld-Ebene-Zuordnungsübung durch, bevor Sie ein Tool bewerten. Teams, die diesen Schritt überspringen, verbringen Wochen damit, Schemaunterschiede nachzurüsten, nachdem die Pipeline bereits in Produktion ist.
Wichtige Erkenntnisse
Effektive Systemdatensynchronisation erfordert vorausschauende Governance-Entscheidungen, nicht nur Tool-Auswahl. Die Konfliktrichtlinie, das Eigentumsmodell und die Überwachungsstrategie, die Sie vor dem Schreiben von Code definieren, bestimmen, ob die Pipeline im zwölften Monat zuverlässig bleibt.
| Punkt | Details |
|---|---|
| Eigentum zuerst erklären | Weisen Sie jedem Datendomänen ein maßgebliches System zu, bevor Sie ein Tool auswählen oder Pipeline-Code schreiben. |
| Timing an Geschäftsbedarf anpassen | Nahezu Echtzeit-CDC deckt die meisten Unternehmensanwendungsfälle ab; reservieren Sie vollständiges Event-Streaming für Sub-Sekunden-Anforderungen. |
| Bulk-Operationen benötigen explizite Handhabung | Bulk-Läufe umgehen Änderungsverfolgungs-Trigger, sofern nicht anders konfiguriert, und erzeugen stillen Datendrift. |
| Abgleich-Deltas überwachen | Connector-Gesundheitsmetriken allein übersehen Datendrift; fügen Sie periodische Datensatzanzahl- und Prüfsummenvergleiche hinzu. |
| Ridiculous Engineering liefert End-to-End | Von CDC-Pipeline-Architektur über Governance-Programme bis hin zu Produktionsüberwachung deckt Ridiculous Engineering den gesamten Sync-Lieferlebenszyklus ab. |
Inhaltsverzeichnis
- Was ist Systemdatensynchronisation und welcher Typ passt zu Ihrem Anwendungsfall?
- Wie Sync tatsächlich implementiert wird: Methoden und Technologien
- Auf welchem Architekturmuster sollten Sie aufbauen?
- Wie lösen Sie Konflikte und verwalten den Golden Record?
- Implementierungs-Checkliste: vom Design bis zum Rollback
- Was sollten Sie überwachen und wie erkennen Sie Probleme frühzeitig?
- Welche Tools und Plattformen handhaben Datensynchronisation?
- Sicherheits-, Datenschutz- und Compliance-Überlegungen
- Migration vs. Sync vs. Replikation: Welche Strategie passt?
- Wie Ridiculous Engineering komplexe Sync-Programme angeht
- Quellen
- FAQ
Was ist Systemdatensynchronisation und welcher Typ passt zu Ihrem Anwendungsfall?
Der Branchenbegriff lautet Datensynchronisation, manchmal abgekürzt als Datensync. „Systemdatensync“ beschreibt dasselbe Konzept auf der Integrationsebene: zwei oder mehr Anwendungsdatenbanken oder -dienste ohne manuellen Eingriff konsistent halten. Die Wahl des Sync-Modells hängt von zwei unabhängigen Achsen ab: Richtung und Zeitpunkt.
Richtung: einseitig, zweiseitig und mehrseitig
Einseitig (Push/Publish) bewegt Änderungen von einer einzigen Quelle zu einem oder mehreren Zielen. Die Quelle ist maßgeblich; Ziele sind schreibgeschützte Konsumenten. Dies ist das einfachste Modell und die richtige Standardwahl, wenn ein System die Daten klar besitzt, z. B. das Pushen bestätigter Bestellungen von einem ERP zu einem Erfüllungslager.
Zweiseitig (aktiv-aktiv) ermöglicht Änderungen, die in beiden Systemen entstehen und sich zum jeweils anderen propagieren. CRM-zu-ERP-Kontosync ist das kanonische Beispiel: Vertriebsmitarbeiter aktualisieren Kontakte in Salesforce, Finanzen aktualisiert Rechnungsadressen im ERP, und beide müssen aktuell bleiben. Zweiseitiger Sync birgt Konfliktrisiko, sobald beide Seiten denselben Datensatz vor dem nächsten Sync-Zyklus ändern.
Mehrseitig und hybrid erweitern das Muster auf drei oder mehr Systeme oder kombinieren einseitige und zweiseitige Flüsse innerhalb derselben Pipeline. Eine HR-Plattform könnte Kopfzahlen einseitig an Finanzen pushen, während sie Mitarbeiterprofile zweiseitig mit einem Identitätsanbieter synchronisiert. Die Komplexität wächst hier schnell, und der Governance-Overhead wächst mit.
Zeitpunkt: Echtzeit, nahezu Echtzeit und Stapel
| Zeitmodell | Typische Latenz | Beste Passung |
|---|---|---|
| Echtzeit / unter einer Sekunde | Unter 1 Sekunde | POS-Bestand, Finanzhandels-Feeds, Live-Zusammenarbeit |
| Nahezu Echtzeit | Sekunden bis Minuten | CRM-ERP-Kontosync, Logistikverfolgung |
| Geplanter Stapel | Minuten bis Stunden | Analyse-Pipelines, nächtliche Berichte, Archiv-Sync |
Echtzeit-Sync trägt die höchsten Infrastruktur- und Betriebskosten. Stapel ist billiger und einfacher, erzeugt aber veraltete Fenster, die Ihre Geschäftsanwender irgendwann bemerken werden. Nahezu Echtzeit, typischerweise erreicht mit CDC oder Event-Streaming, trifft den praktischen Sweet Spot für die meisten Enterprise-Integrationsarbeiten.
Pro-Tipp: Wenn ein Geschäftsakteur sagt, er brauche „Echtzeit“-Sync, fragen Sie, welche Entscheidung er mit diesen Daten trifft und wie veraltet sie sein können, bevor sie ein Problem verursachen. Die Antwort ist fast immer „fünf Minuten sind in Ordnung“, was die Tür zu einem weitaus einfacheren Nahezu-Echtzeit-Design öffnet.
Wie Sync tatsächlich implementiert wird: Methoden und Technologien
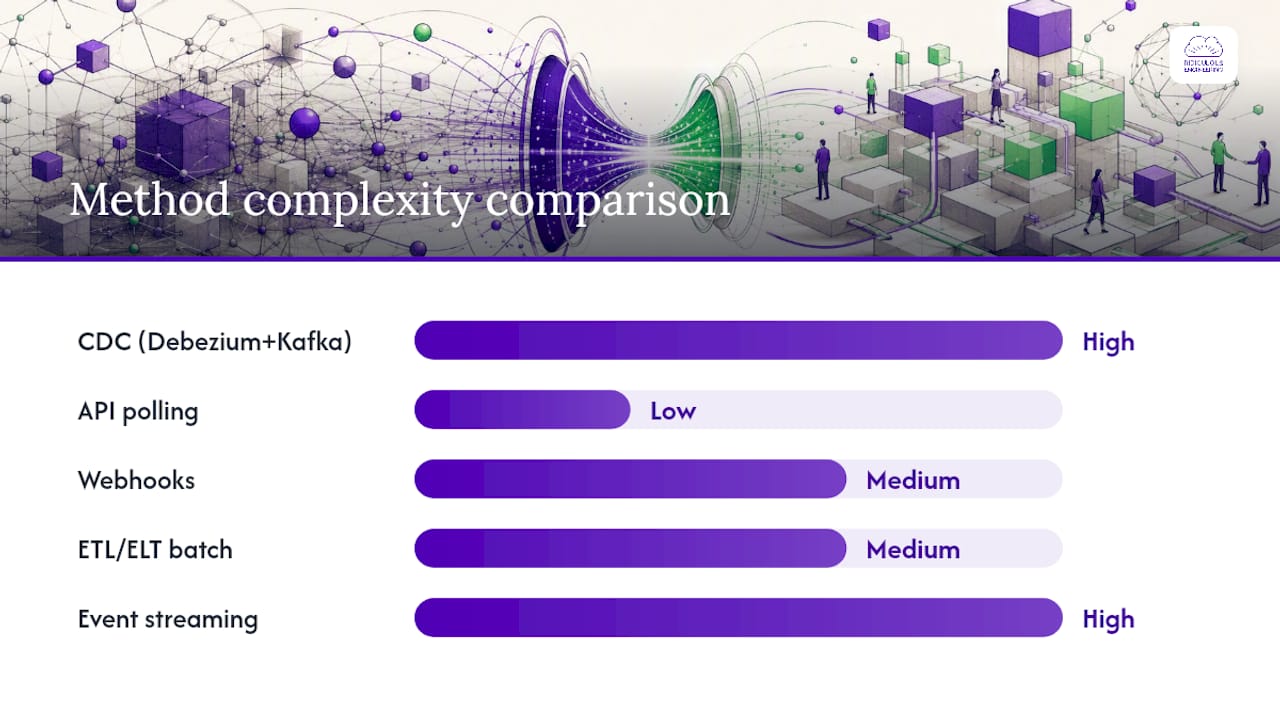
Fünf primäre Methoden decken die überwiegende Mehrheit der Produktions-Sync-Arbeit ab. Jede hat ein eigenes Latenzprofil, Auswirkung auf das Quellsystem und Fehlermodus.
Change Data Capture (CDC)
CDC liest das Datenbank-Transaktionsprotokoll, anstatt Tabellen abzufragen, sodass es jeden Einfüge-, Aktualisierungs- und Löschvorgang mit minimaler Last auf der Quelle erfasst. Eine typische Pipeline sieht so aus:
Quell-DB-Transaktionsprotokoll
  → CDC-Konnektor (z. B. Debezium)
    → Nachrichtenbroker (z. B. Apache-Kafka-Thema)
      → Senken-Konnektor
        → Zielsystem
Debezium ist der am weitesten verbreitete Open-Source-CDC-Konnektor. Er unterstützt PostgreSQL, MySQL, SQL Server, MongoDB und andere und veröffentlicht Änderungsereignisse an Kafka-Themen mit Schema-Informationen, die über Confluent Schema Registry oder Apicurio eingebettet sind. Apache Kafka bietet das dauerhafte, geordnete Protokoll, das die Quelle von jedem nachgelagerten Konsumenten entkoppelt, sodass Sie eine neue Analyse-Senke hinzufügen können, ohne die Quell-Pipeline zu berühren.
Eine kritische Einschränkung: Massenoperationen umgehen oft Änderungsverfolgungs-Trigger es sei denn, Optionen wie FIRE_TRIGGERS sind explizit gesetzt. Ein nächtlicher Bulk-Load, der Trigger überspringt, kann stille Datendrift verursachen, die Ihr Monitoring möglicherweise nicht rechtzeitig erkennt.
API- und Webhook-basierte Synchronisierung
Das Abfragen einer API nach Zeitplan ist der einfachste Ansatz und die häufigste Quelle für Rate-Limit-Verstöße. Webhooks kehren das Modell um: Das Quellsystem pusht eine Benachrichtigung, wenn eine Änderung auftritt, und Ihre Integrationsschicht verarbeitet sie. Webhooks sind schneller und günstiger im API-Kontingent, erfordern jedoch einen zuverlässigen Endpunkt, Retry-Logik und Idempotenz-Schlüssel, damit doppelte Zustellungen keine doppelten Datensätze erzeugen.
ETL/ELT und Batch-Jobs
Extract-Transform-Load (ETL) und seine moderne Variante ELT bleiben die richtige Wahl, wenn Frische-Anforderungen in Stunden statt Sekunden gemessen werden. Tools wie dbt, Apache Airflow und Fivetran übernehmen die Planung, Transformation und Lineage-Verfolgung, die Batch-Pipelines benötigen. Der Kostenvorteil gegenüber Streaming ist real: Sie zahlen nur während des Job-Fensters für Rechenleistung, nicht kontinuierlich.
Event-Streaming (Kafka-Stil)
Event-Streaming-Ansätze funktionieren am besten, wenn Sub-Sekunden-Frische und Reihenfolge geschäftskritisch sind, aber sie bringen höhere Betriebskosten und eine steilere Lernkurve mit sich. Kafka garantiert Reihenfolge innerhalb einer Partition, unterstützt Replay von jedem Offset und skaliert auf Millionen von Ereignissen pro Sekunde. Der Kompromiss ist, dass Sie jetzt ein verteiltes Log betreiben, das eigene Überwachung, Aufbewahrungsrichtlinien und Consumer-Gruppen-Verwaltung erfordert.
Wichtige Erkenntnis: Ein minimaler Ordnungsdienst plus lokales Replay kann Konvergenz ohne komplexe CRDT-Logik garantieren, erfordert jedoch deterministische Transaktionsfunktionen und sorgfältige Replay-Semantik. Adobe’s Daten-Sync-Paket demonstriert dieses Muster in der Produktion: Es weist kanonische Ordnung zu und unterstützt optimistische lokale Transienten mit server-committetem Replay, wodurch konvergenter Multi-Client-Zustand ohne den Overhead einer vollständigen CRDT-Implementierung erreicht wird.
Dateibasierte Übertragung
Für Bulk-Binärdaten, Archiv-Exporte oder Legacy-Systeme ohne API bleibt die dateibasierte Übertragung praktikabel. AWS DataSync handhabt groß angelegte Übertragungen mit Verschlüsselung während der Übertragung und End-to-End-Integritätsvalidierung, was es zu einer starken Wahl für regulierte Datenbewegungen zwischen On-Premises-Speicher und Cloud macht. Für Peer-to-Peer-Dateisynchronisierung ist rsync das Standard-Unix-Werkzeug, obwohl Teams seine Sicherheitsversionen sorgfältig verfolgen sollten.
Methodenvergleich
| Methode | Latenz | Quellauswirkung | Komplexität | Häufiger Fehlermodus |
|---|---|---|---|---|
| CDC (Debezium + Kafka) | Sub-Sekunden bis Sekunden | Niedrig (Log-Lesen) | Hoch | Log-Aufbewahrungslücken, Bulk-Load-Umgehung |
| API-Polling | Minuten | Mittel (Abfragelast) | Niedrig | Rate-Limits, verpasste Löschungen |
| Webhooks | Sekunden | Niedrig | Mittel | Doppelte Zustellung, Endpunkt-Ausfallzeit |
| ETL/ELT-Stapelverarbeitung | Minuten bis Stunden | Mittel bis hoch | Mittel | Schema-Drift, Jobfehler |
| Ereignis-Streaming | Unter einer Sekunde | Niedrig | Hoch | Consumer-Lag, Partitions-Skew |
| Dateiübertragung | Stunden | Niedrig | Niedrig | Integritätsfehler, veraltete Dateien |
Auf welchem Architekturmuster sollten Sie aufbauen?
Die gewählte Methode bestimmt den Datenfluss; das Architekturmuster bestimmt, wem was gehört und wie Fehler sich ausbreiten. Vier Muster decken die meisten Unternehmensbereitstellungen ab.
Punkt-zu-Punkt
Jedes System verbindet sich direkt mit jedem anderen System, mit dem es Daten teilen muss. Zwei Systeme: eine Verbindung. Fünf Systeme: bis zu zehn Verbindungen. Die Mathematik wird schnell unschön, und jede Verbindung ist eine individuelle Integration, die wahrscheinlich ein anderes Team gebaut hat. Punkt-zu-Punkt ist für zwei oder drei eng gekoppelte Systeme akzeptabel, bei denen das Team beide Seiten besitzt. Darüber hinaus wird es zu einer Wartungsbelastung.
Hub-and-Spoke
Ein zentraler Hub vermittelt den gesamten Datenaustausch. Spokes verbinden sich nur mit dem Hub, nicht miteinander. Azure SQL Data Sync ist ein Produktionsbeispiel für dieses Muster: Eine Hub-Datenbank synchronisiert sich mit Mitgliedsdatenbanken nach einem konfigurierten Zeitplan, wobei die Konfliktlösung am Hub erfolgt. Der Hub wird zu einem einzelnen Fehlerpunkt, daher ist die Hochverfügbarkeitskonfiguration für den Hub nicht optional.
Middleware und iPaaS
Eine Integrationsplattform (MuleSoft, Boomi, Workato, IBM App Connect) sitzt zwischen Systemen und übernimmt Transformation, Routing, Fehlerbehandlung und Wiederholungslogik. Dieses Muster eignet sich für SaaS-lastige Umgebungen, in denen Sie die Quell- oder Zielschemas nicht kontrollieren. Der Plattformanbieter verwaltet die Konnektoren; Ihr Team verwaltet die Flows und Governance. Workatos rezeptbasiertes Modell und IBMs unternehmensgerechte Konnektorbibliothek sind zwei etablierte Optionen in diesem Bereich.
Architekturprinzip: Das Eigentum am kanonischen Datensatz muss erklärt werden, bevor das erste Byte sich bewegt. Wenn zwei Teams jeweils glauben, ihr System sei die Quelle der Wahrheit für dasselbe Feld, löst kein Architekturmuster diesen Konflikt automatisch.
Ereignisgesteuert und Streaming
Apache Kafka oder eine verwaltete Entsprechung (Confluent Cloud, Amazon MSK) fungiert als dauerhaftes Protokoll. Produzenten veröffentlichen Ereignisse; Konsumenten abonnieren unabhängig. Dieses Muster entkoppelt Produzenten vollständig von Konsumenten, unterstützt Wiedergabe und skaliert horizontal. Adobes Bestellserver-Modell zeigt, wie eine leichte Variante dieses Musters konvergenten Zustand für Echtzeit-Multi-Benutzer-Synchronisierung ohne vollständige Kafka-Bereitstellung erreicht. Die betrieblichen Kosten sind real: Sie benötigen Schema-Governance, Konsumentengruppen-Überwachung und Aufbewahrungsrichtlinien von Tag eins an.
Für Peer-to-Peer-Szenarien, in denen zentrale Speicherung unerwünscht ist, bietet Syncthing ein dezentrales, verschlüsseltes Modell, obwohl es zentrale Kontrolle gegen Komplexität bei Konfliktlösung und Prüfbarkeit eintauscht.
Profi-Tipp: Wählen Sie Hub-and-Spoke, wenn Sie eine einfache Prüfspur und einen klaren Konflikteigentümer benötigen. Wählen Sie ereignisgesteuert, wenn Sie Latenz unter einer Sekunde über mehr als drei Konsumenten benötigen. Alles dazwischen ist normalerweise eine gute Passung für iPaaS.
Muster-Passungsübersicht
| Muster | Am besten geeignet für | Fehlerisolierung | Eigentumsmodell |
|---|---|---|---|
| Punkt-zu-Punkt | 2–3 eng gekoppelte Systeme | Schwach | Jedes Team besitzt seine Verbindung |
| Hub-and-Spoke | Zentralisierte Governance, SQL-Workloads | Hub ist Single Point of Failure | Hub-Team besitzt Konfliktregeln |
| Middleware / iPaaS | SaaS-lastige, heterogene Systeme | Gut (Plattform übernimmt Wiederholungen) | Plattform-Team + Flow-Eigentümer |
| Event-getrieben / Streaming | Hoher Durchsatz, Sub-Sekunde, viele Konsumenten | Ausgezeichnet (Konsumenten-Unabhängigkeit) | Plattform-Team + Schema-Registry |
Wie lösen Sie Konflikte und verwalten den Golden Record?
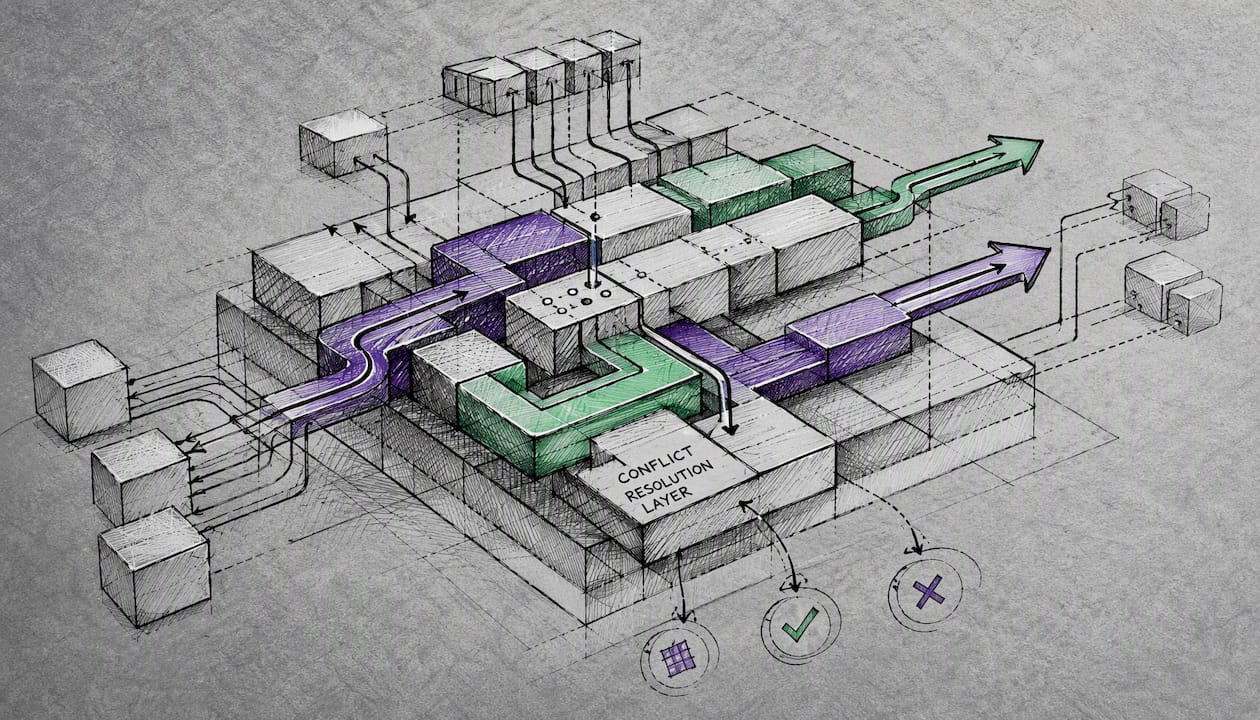
Konfliktlösung ist, wo Sync-Projekte in der Produktion am häufigsten scheitern. Zwei Systeme aktualisieren denselben Datensatz vor dem nächsten Sync-Zyklus, und die Pipeline muss entscheiden, welche Version gewinnt. Die Entscheidung, die Sie hier treffen, hat nachgelagerte Konsequenzen für jedes Team, das auf diese Daten angewiesen ist.
Häufige Konfliktrichtlinien
Last-Writer-Wins (LWW) wendet einen Zeitstempel oder eine Sequenznummer an und behält die neueste Änderung. Einfach zu implementieren, verwirft aber stillschweigend legitime Aktualisierungen, wenn Uhren abweichen oder ein langsames Netzwerk eine ältere Änderung nach einer neueren liefert.
Hub gewinnt / Mitglied gewinnt sind die beiden Richtlinien, die Azure SQL Data Sync bereitstellt. „Hub gewinnt“ bedeutet, dass die Version der Hub-Datenbank bei Konflikten immer Mitgliedsänderungen überschreibt. „Mitglied gewinnt“ macht das Gegenteil. Keines ist universell korrekt; die richtige Wahl hängt davon ab, welchem System Ihr Unternehmen für eine bestimmte Datendomäne am meisten vertraut.
Source-of-Truth pro Domäne weist Eigentum auf Feld- oder Entitätsebene zu. Die Kundenrechnungsadresse gehört dem ERP; Kundenkontaktpräferenzen gehören dem CRM. Konflikte innerhalb einer Domäne gehen an den designierten Eigentümer; domänenübergreifende Konflikte existieren per Definition nicht. Dies ist die dauerhafteste Richtlinie und am schwierigsten zu implementieren ohne vorherige Governance-Arbeit.
Der Golden-Record-Ansatz
Ein Golden Record ist die einzige vereinbarte Version einer Entität, zusammengesetzt aus den vertrauenswürdigsten Feldern aller beitragenden Systeme. Die Operationalisierung erfordert drei Dinge: einen Data Steward, der die Abgleichsentscheidung für jede Domäne besitzt, ein Schema, das explizit markiert, welches System pro Feld autoritativ ist, und einen geplanten Abgleichslauf, der den Golden Record mit allen beitragenden Systemen vergleicht und Abweichungen kennzeichnet.
Entscheidungsmatrix zur Konfliktlösung
| Geschäftspriorität | Empfohlene Richtlinie | Zu managendes Risiko |
|---|---|---|
| Frische über Korrektheit | Last-Writer-Wins | Uhrenabweichung, Außer-Reihen-Lieferung |
| Korrektheit über Frische | Source-of-Truth pro Domäne | Latenz, domänenübergreifende Zuordnung |
| Durchsatz über beidem | Hub gewinnt (einfache Regel) | Überschriebene legitime Mitgliedsaktualisierungen |
| Prüfbarkeit erforderlich | Feld-Level-Versionierung + Audit-Log | Speicherkosten, Abfragekomplexität |
Pro-Tipp: Forschung zu Konfliktmanagement von Harvards Programm für Verhandlungen findet durchgängig, dass kollaborative, interessenbasierte Ansätze haltbarere Vereinbarungen hervorbringen als starre Regeln. Wenden Sie dieselbe Logik auf die Sync-Governance an: Wenn zwei Teams das Eigentum an einem Datenfeld bestreiten, ermöglichen Sie ein Gespräch darüber, was jedes Team tatsächlich von diesem Feld benötigt, anstatt eine technische Regel aufzuerlegen. Die resultierende Richtlinie überlebt länger und erzeugt weniger Eskalationen.
Wenn Teams Konfliktlösung als Verhandlungsproblem behandeln, erzeugen sie haltbarere Governance, als sich nur auf Last-Writer-Wins zu verlassen.
Governance-Checkliste
- Weisen Sie pro Domäne einen benannten Datenverantwortlichen mit dokumentierter Befugnis zur Lösung von Streitigkeiten zu.
- Definieren Sie SLAs für die Sync-Frische (z. B. CRM-zu-ERP-Kontosynchronisierung innerhalb von 5 Minuten nach Änderung).
- Führen Sie ein Audit-Trail jeder Entscheidung zur Konfliktlösung, nicht nur des gewinnenden Werts.
- Planen Sie Abgleichläufe mindestens täglich; vergleichen Sie Datensatzzahlen und Prüfsummen der Schlüsselfelder.
- Dokumentieren Sie einen Eskalationspfad für Konflikte, die die automatisierte Richtlinie nicht lösen kann.
Implementierungs-Checkliste: vom Design bis zum Rollback
Ein Sync-Projekt, das Designschritte überspringt, zahlt dafür in Produktionsvorfällen. Die Checkliste unten deckt die Phasen ab, in denen Teams am häufigsten Ecken abschneiden.
Designphase
- Kartieren Sie jedes Quell- und Zielsystem, einschließlich Eigentümer, Schema-Version und Aktualisierungshäufigkeit.
- Führen Sie Feld-Level-Mapping durch: identifizieren Sie Typabweichungen, Nullable-Unterschiede und Kodierungsinkonsistenzen, bevor Sie eine Zeile Code schreiben.
- Erklären Sie das maßgebliche System für jede synchronisierte Entität und jedes Feld.
- Planen Sie Idempotenz von Anfang an: Jede Sync-Operation sollte dasselbe Ergebnis erzeugen, ob sie einmal oder zehnmal läuft.
- Definieren Sie die Richtlinie zur Konfliktlösung pro Domäne und dokumentieren Sie sie in einem gemeinsamen Entscheidungsdatensatz.
Engineering-Phase
- Implementieren Sie Schema-Evolution-Handling: Verwenden Sie ein Schema-Registry (Confluent Schema Registry, AWS Glue Schema Registry), damit Verbraucher nicht brechen, wenn ein Produzent ein Feld hinzufügt.
- Bauen Sie Wiederholungslogik mit exponentiellem Backoff und einer Dead-Letter-Queue für Nachrichten, die wiederholt fehlschlagen.
- Behandeln Sie transaktionale Semantik explizit: Entscheiden Sie, ob Sie Exactly-Once-, At-Least-Once- oder At-Most-Once-Zustellung benötigen, und wählen Sie Ihren Transport entsprechend.
- Testen Sie Bulk-Load-Pfade separat. Bulk-Operationen können Change-Tracking-Trigger umgehen, sofern nicht anders konfiguriert, was stille Drift erzeugt.
- Implementieren Sie Rate-Limit-Handling für API-basierte Konnektoren: Backen Sie elegant zurück und exponieren Sie Kontingenterschöpfung als benannten Fehler, nicht als stillen Fehlschlag.
Testplan-Übersicht
- Unit-Tests: validieren Sie Transformationslogik, Feld-Mapping und Konfliktlösungsregeln isoliert.
- Integrationstests: führen Sie gegen einen produktionsähnlichen Datensatz aus; verifizieren Sie Datensatzzahlen, Prüfsummen und Latenz gegen SLA-Ziele.
- Chaos- und Fehlertests: töten Sie den Message-Broker mitten im Batch, führen Sie Netzwerkpartitionen ein und verifizieren Sie, dass die Pipeline ohne Datenverlust oder Duplikation wiederherstellt.
- Cutover-Probe: führen Sie die vollständige Cutover-Sequenz in einer Staging-Umgebung mindestens zweimal vor der Produktion aus.
Rollback und Minderung
- Verwenden Sie Feature-Flags oder Sync-Aktivierungs-Schalter, damit Sie eine Pipeline ohne Code-Deploy deaktivieren können.
- Machen Sie einen Schnappschuss der Zielsysteme unmittelbar vor dem Cutover; behalten Sie ihn für mindestens einen vollständigen Abgleichzyklus.
- Planen Sie Wiedergabefähigkeit in die Pipeline ein, damit Sie Ereignisse von einem bekannten guten Offset erneut verarbeiten können.
- Definieren Sie ein Rollback-SLA: Wie lange kann das Geschäft tolerieren, auf veralteten Daten zu laufen, während Sie wiederherstellen?
Profi-Tipp: Die Teams, die sich am schnellsten von Sync-Fehlern erholen, sind die, die das Rollback geübt haben, bevor sie es brauchten. Planen Sie eine Chaos-Übung in Staging vor Ihrem ersten Produktions-Cutover.
Was sollten Sie überwachen, und wie erkennen Sie Probleme frühzeitig?
Zu den betrieblichen Herausforderungen, die bei Sync-Projekten häufig auftreten, gehören Latenzlücken, Schema-Drift, doppelte Datensätze durch Wiederholungsversuche, CDC-Verzögerung, API-Ratenlimits und veraltete Daten, die Geschäusernutzer vor dem Engineering-Team erkennen. Eine Überwachung, die nur die Connector-Gesundheit misst, übersieht die meisten dieser Punkte.
Wesentliche Metriken
- Sync-Verzögerung: Zeit zwischen einer Änderung in der Quelle und ihrer Ankunft am Ziel. Alarmieren Sie, wenn die Verzögerung Ihren SLA-Schwellenwert überschreitet.
- Erfolgs-/Fehlerquote: Prozentsatz der Sync-Vorgänge, die ohne Fehler abgeschlossen werden. Ein plötzlicher Rückgang ist das früheste Signal für ein systemisches Problem.
- Durchsatz: Ereignisse oder Datensätze pro Sekunde. Unerwartete Rückgänge deuten auf Upstream-Verlangsamungen oder Consumer-Verzögerungen hin.
- Duplikatzähler: Datensätze, die mehr als einmal verarbeitet wurden. Eine steigende Duplikatrate signalisiert fehlende Idempotenz oder falsch konfigurierte Wiederholungsversuche.
- Abgleich-Delta: Periodischer Vergleich von Datensatzzahlen und Prüfsummen wichtiger Felder zwischen autoritativen Systemen. Dies ist die Metrik, die Drift erfasst, den die Connector-Level-Metriken übersehen.
- Schema-Änderungsalarme: Auslösung bei jeder DDL-Änderung an einem synchronisierten Tabellen- oder Topic-Schema.
Alarmschwellenwerte und Eskalation
Beginnen Sie mit diesen sinnvollen Standardwerten und passen Sie sie dann basierend auf Ihrer SLA an:
- Verzögerung überschreitet das 2-fache Ihres SLA-Ziels für mehr als 3 aufeinanderfolgende Minuten: Benachrichtigen Sie den Bereitschaftsingenieur.
- Fehlerquote über 1% in einem 5-Minuten-Fenster: automatischer Wiederholungsversuch; eskalieren Sie an eine Person, wenn nach 15 Minuten nicht behoben.
- Abgleich-Delta über 0,1% der Gesamtdatensatzzahl: Eröffnen Sie einen Vorfall und führen Sie einen gezielten Abgleich-Job aus.
- Schema-Änderung an einer synchronisierten Tabelle erkannt: Pausieren Sie die Pipeline, benachrichtigen Sie das besitzende Team und verlangen Sie eine bewusste Wiederaufnahme.
Observability-Instrumente
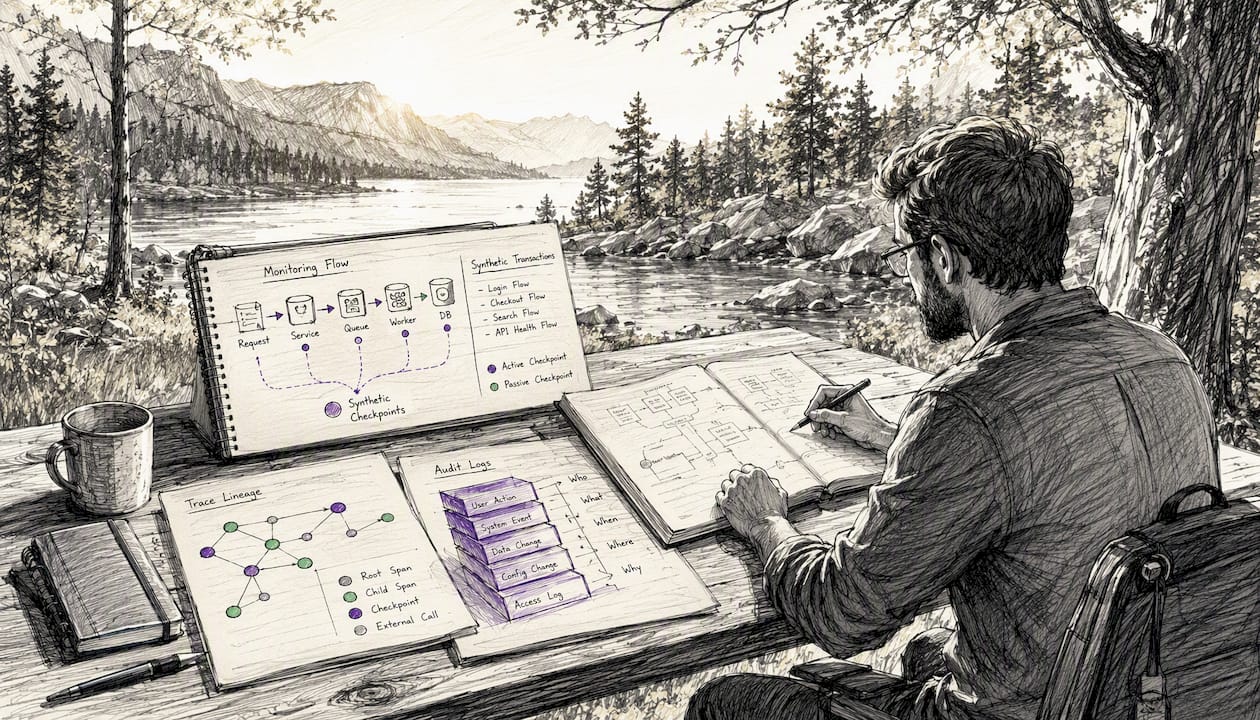
Connector-Level-Gesundheitschecks sind notwendig, aber nicht ausreichend. Fügen Sie synthetische End-to-End-Transaktionen hinzu: Injizieren Sie einen bekannten Testdatensatz in die Quelle nach Zeitplan und verifizieren Sie, dass er innerhalb Ihres SLA-Fensters am Ziel ankommt. Fügen Sie Linienverfolgung hinzu, damit Sie jeden Datensatz durch jede Transformation zurückverfolgen können. Audit-Logs sollten nicht nur erfassen, was geändert wurde, sondern wer oder welches System die Änderung initiiert hat.
Welche Tools und Plattformen verwalten Datensynchronisation?
Die benötigte Tool-Kategorie hängt von Ihren Quell- und Zielsystemen, Ihrer Latenzanforderung und der betrieblichen Kapazität Ihres Teams ab. CDC und Event-Streaming sind die Standardansätze für nahezu Echtzeit-Sync; iPaaS-Plattformen eignen sich für SaaS-zu-SaaS-Integration; Datei-Tools verwalten Bulk- und Binärübertragungen.
Tool-Kategorieübersicht
iPaaS (Integration Platform as a Service): Workato, IBM App Connect, Skyvia und MuleSoft Anypoint Platform fallen alle hierher. Diese Plattformen bieten vorgefertigte Connectors für Hunderte von SaaS-Anwendungen, visuelle Flow-Builder und verwaltete Wiederholungs-/Fehlerbehandlung. Workatos Rezeptmodell eignet sich für Betriebsteams, die Flows ohne tiefes Engineering-Wissen erstellen müssen. IBM App Connect bringt Enterprise-Governance und eine Connector-Bibliothek, die Mainframe- und Legacy-Systeme abdeckt, die die meisten iPaaS-Anbieter ignorieren. Skyvia bietet eine leichtere, cloud-native Option mit starker Unterstützung für Datenbank-zu-Cloud-Sync zu einem niedrigeren Preis.
CDC und Datenbankreplikation: Debezium (Open Source, Kafka-nativ) und Azure SQL Data Sync (verwaltet, Hub-and-Spoke) sind die primären Optionen für Datenbank-zu-Datenbank-Sync. Debezium gibt Ihnen volle Kontrolle und integriert nativ mit Apache Kafka. Azure SQL Data Sync tauscht Flexibilität gegen Einfachheit: Konfigurieren Sie eine Sync-Gruppe, legen Sie einen Zeitplan fest, und der Dienst übernimmt den Rest im Azure-Ökosystem.
Event-Streaming: Apache Kafka (selbstverwaltet oder über Confluent Cloud, Amazon MSK oder Azure Event Hubs) ist der Produktionsstandard für Sub-Sekunden-Hochdurchsatz-Sync. Die betriebliche Komplexität ist hoch; verwaltete Dienste reduzieren sie erheblich.
Datei- und Bulk-Übertragung: AWS DataSync verwaltet groß angelegte, sichere Dateibewegungen zwischen On-Premises und Cloud mit Integritätsvalidierung. Rsync bleibt der Standard für Unix-zu-Unix-Dateisync.
Bewertungsdimensionen
| Tool / Kategorie | Am besten geeignet für | Richtung | Timing | Bereitstellung | Operative Komplexität | Kostenmodell |
|---|---|---|---|---|---|---|
| Workato | SaaS-zu-SaaS-Automatisierung | Einweg, Zweiweg | Nahezu Echtzeit | Cloud | Niedrig (visueller Builder) | Pro-Rezept / Verbrauch |
| IBM App Connect | Unternehmen, Altsysteme | Einweg, Zweiweg, Multi | Nahezu Echtzeit, Stapel | Cloud, On-Premises, Hybrid | Mittel bis hoch | Lizenz + Verbrauch |
| Skyvia | DB-zu-Cloud, SaaS-Synchronisierung | Einweg, Zweiweg | Nahezu Echtzeit, Stapel | Cloud | Niedrig bis mittel | Abonnementstufen |
| Apache Kafka + Debezium | DB-CDC, Hochdurchsatz-Streaming | Einweg, Multi | Unter einer Sekunde bis Sekunden | Cloud, On-Premises, Hybrid | Hoch | Infrastruktur + Betrieb |
| Azure SQL Data Sync | SQL Server / Azure SQL-Synchronisierung | Zweiweg (Hub-Spoke) | Nahezu Echtzeit, Stapel | Cloud, Hybrid | Niedrig bis mittel | Azure-Verbrauch |
| AWS DataSync | Bulk-Datei-/Speichermigration | Einweg | Stapel, geplant | Cloud, hybrid | Niedrig | Pro übertragenem GB |
Profi-Tipp: Für kleine Umgebungen (unter 5 Systemen, SaaS-lastig) beginnen Sie mit einem iPaaS wie Workato oder Skyvia. Für mittlere Umgebungen mit einer Mischung aus Datenbanken und SaaS fügen Sie Debezium und Kafka für die Datenbankschicht hinzu. Für groß angelegte Anforderungen im Sub-Sekunden-Bereich über viele Konsumenten hinweg ist ein vollständig verwalteter Kafka-Dienst mit Schema-Registry die einzige Architektur, die unter Last standhält.
Wenn die Integrationskomplexität das übersteigt, was Ihr Team intern warten kann, zahlt sich die Entscheidung, einen Integrator hinzuzuziehen, schnell aus. Ridiculousengineering’s Systemintegration und kundenspezifische Sync-Entwicklung Arbeit deckt den gesamten Stack von der Architektur bis zum Produktionssupport ab.
Sicherheits-, Datenschutz- und Compliance-Überlegungen
Sicherheit ist der Bereich, in dem Sync-Projekte am häufigsten unbeabsichtigte Expositionen schaffen. Daten, die zwischen Systemen bewegt werden, überschreiten Netzwerkgrenzen, passieren Konnektoren mit gespeicherten Anmeldeinformationen und landen in Zielen, die möglicherweise schwächere Zugriffskontrollen als die Quelle haben.
Grundlegende Kontrollen
- Verschlüsselung während der Übertragung: TLS 1.2 oder höher auf jedem Konnektor, jedem Hop. Keine Ausnahmen für interne Netzwerksegmente.
- Authentifizierung und Autorisierung: Verwenden Sie Dienstkonten mit Zugriff nach dem Prinzip der geringsten Rechte. Ein Sync-Konnektor, der Kundendaten liest, sollte keinen Schreibzugriff auf Finanztabellen haben.
- Schlüssel- und Geheimnisverwaltung: Speichern Sie Konnektor-Anmeldeinformationen in einem Geheimnisverwalter (AWS Secrets Manager, HashiCorp Vault, Azure Key Vault), nicht in Konfigurationsdateien oder Umgebungsvariablen, die in die Quellcodeverwaltung eingecheckt sind.
- Geheimnisrotation: Rotieren Sie Konnektor-Anmeldeinformationen nach einem definierten Zeitplan und nach jeder Personaländerung, die Zugriff darauf hatte.
Datenminimierung und regulierte Daten
Synchronisieren Sie nur die Felder, die Sie benötigen. Das Synchronisieren eines vollständigen Kundendatensatzes, wenn das Zielsystem nur Name und E-Mail benötigt, verdoppelt Ihre Expositionsfläche ohne geschäftlichen Mehrwert. Für regulierte Daten ist die Expositionsfläche auch eine Compliance-Fläche.
US-Gesundheitsdaten unterliegen HIPAA-Verpflichtungen: Jedes Sync-Design, das geschützte Gesundheitsinformationen (PHI) berührt, muss Verschlüsselung, Zugriffskontrollen und Audit-Trails enthalten, um Compliance zu unterstützen. Dies gilt für die Pipeline selbst, nicht nur für die Endpunkte. Ein Kafka-Thema, das PHI trägt, ist ein PHI-Speicher und muss entsprechend behandelt werden.
Für nicht gesundheitsbezogene regulierte Daten gilt PCI DSS für Zahlungskartendaten, und CCPA auferlegt Datensubjektrechte für kalifornische Verbraucherdaten. Beide haben Auswirkungen darauf, wie lange synchronisierte Daten aufbewahrt werden und wer darauf zugreifen kann.
Sicherheits-Checkliste
| Kontrolle | Gilt für | Implementierungshinweis |
|---|---|---|
| TLS während der Übertragung | Alle Konnektoren | Mindestens TLS 1.2 durchsetzen; Legacy-Chiffresuiten deaktivieren |
| Dienstkonten mit geringsten Rechten | Alle Konnektoren | Getrennte Lese- und Schreibkonten pro Pipeline |
| Geheimnisverwalter-Integration | Alle Anmeldeinformationsspeicher | Speichern Sie Anmeldedaten niemals in Code- oder Konfigurationsdateien |
| Feldbezogene Maskierung | Regulierte Daten (PHI, PCI) | Vor dem Schreiben in nicht regulierte Ziele im Connector maskieren |
| Audit-Protokollierung | Alle Pipelines | Quelle, Ziel, Zeitstempel, Datensatz-ID und Vorgangstyp protokollieren |
| Zeitplan für die Rotation von Geheimnissen | Alle Anmeldedaten | Mindestens jährlich; vierteljährlich für Pipelines mit hoher Sensibilität |
| Richtlinie zur Datenaufbewahrung | Alle synchronisierten Speicher | Aufbewahrung an der strengsten geltenden Vorschrift ausrichten |
Migration vs. Synchronisierung vs. Replikation: Welche Strategie passt?
Diese drei Begriffe werden oft synonym verwendet, beschreiben aber grundlegend unterschiedliche Strategien mit unterschiedlichen betrieblichen Verpflichtungen.
Migration ist ein einmaliger, begrenzter Vorgang: Daten von System A zu System B verschieben, validieren und A außer Betrieb nehmen. Das Ziel ist eine saubere Umstellung. Tools wie AWS DataSync und datenbanknative Export-/Import-Dienstprogramme bewältigen dies gut. Migration ist die richtige Wahl, wenn Sie ein System außer Betrieb nehmen, nicht integrieren.
Replikation kopiert Daten kontinuierlich von einem Primärsystem zu einem oder mehreren Replikaten, typischerweise für Leseskalierung oder Notfallwiederherstellung. Das Replikat ist kein unabhängiger Teilnehmer; es ist eine Kopie. PostgreSQL-Streaming-Replikation und MySQL-Binlog-Replikation sind die Standardmechanismen. Replikation ist die richtige Wahl, wenn Ihr Ziel Verfügbarkeit oder Lesedurchsatz ist, nicht systemübergreifender Datenaustausch.
Synchronisierung hält zwei oder mehr unabhängige Systeme im Laufe der Zeit konsistent. Jedes System kann Änderungen verursachen. Synchronisierung ist die richtige Wahl, wenn mehrere Anwendungen dieselbe logische Datendomäne lesen und schreiben müssen und keine von ihnen den anderen untergeordnet werden kann.
Entscheidungsablauf
- Kurzfristige Umstellung mit Systemaußerbetriebnahme: Migration wählen.
- Leseskalierung oder Notfallwiederherstellung innerhalb eines einzelnen Anwendungsstapels: Replikation wählen.
- Langfristige Konsistenz über unabhängige Systeme hinweg: Synchronisierung wählen.
- Notfallwiederherstellung plus systemübergreifende Integration: Replikation für Hochverfügbarkeit mit Synchronisierung für Workload-Integration kombinieren.
- Migration auf eine neue Plattform, während das alte System während des Übergangs live bleibt: zuerst migrieren, dann Synchronisierung parallel ausführen bis zum Umstellungstermin, dann außer Betrieb nehmen.
Die Lücke beim Datenaustausch zwischen Systemen ist fast immer ein Governance-Problem, bevor es ein Technologie-Problem ist. Die richtige Strategie früh zu wählen, verhindert Monate der Nacharbeit.
Wie Ridiculous Engineering komplexe Synchronisierungsprogramme angeht
Teams, die ihre Quellen kartiert, eine Architektur gewählt und eine Konfliktrichtlinie geschrieben haben, stehen immer noch vor einem harten Problem: Der Aufbau und Betrieb einer Produktions-Synchronisierungspipeline ist Ingenieursarbeit, keine Konfigurationsarbeit. Der Unterschied zwischen einer Pipeline, die unter Last standhält, und einer, die stillschweigend abweicht, zeigt sich in den Details: Idempotenz-Design, Handhabung von Schemaentwicklungen, Chaos-Tests und Überwachung, die Abweichungen erkennt, bevor Geschäftsbenutzer es tun.
Ridiculous Engineering’s kundenspezifische Integrations- und Synchronisierungs-Ingenieurdienste decken den gesamten Lieferlebenszyklus ab: Architekturdesign, CDC-Pipeline-Implementierung, Event-Streaming-Infrastruktur, Governance-Programm-Einrichtung, Testplanung und Produktionsüberwachung. Wir arbeiten mit den Tools, die Ihr Team bereits verwendet, oder helfen Ihnen, die richtigen für Ihren Umfang und Ihre Einschränkungen zu wählen.
Praktische Ergebnisse, die Kunden erwarten können, umfassen reduziertes Datenabweichen, SLA-gestützte Frischegarantien, reproduzierbare Rollback-Verfahren und Audit-Trails, die regulatorische Überprüfungen erfüllen. Wir helfen Teams auch, die Governance-Strukturen und teamübergreifenden Vereinbarungen aufzubauen, die Pipelines nach der ersten Lieferung gesund halten.
Wenn Ihr Team ein Synchronisierungsprogramm plant oder eines erbt, das bereits Anzeichen von Abweichen zeigt, kontaktieren Sie uns, um ein Gespräch zu beginnen. Wir helfen Ihnen herauszufinden, was Sie tatsächlich benötigen, bevor wir empfehlen, wie Sie es aufbauen.
Quellen
Die folgenden Quellen sind es wert, für tiefergehende technische und regulatorische Lektüre mit Lesezeichen versehen zu werden:
- sql-data-sync-data-sql-server-sql-database?view=azuresql
- Konfliktmanagement-Stile: Fallstricke und Best Practices - PON - Programm für Verhandlung an der Harvard Law School
- Daten-Synchronisierungstools halten Informationen automatisch über mehrere Systeme, Datenbanken und Cloud-Umgebungen hinweg konsistent
- Adobe/Datensynchronisierung (GitHub)
- AWS DataSync
- Health Insurance Portability and Accountability Act (HIPAA) – CDC
FAQ
Was passiert, wenn ich die Synchronisierung deaktiviere?
Das Deaktivieren einer Synchronisierungspipeline stoppt die Weitergabe von Änderungen zwischen Systemen, sodass jedes System unabhängig weiterhin Updates ansammelt. Wenn Sie die Synchronisierung wieder aktivieren, muss die Pipeline die Abweichungen abgleichen, und je nach Konfliktrichtlinie können einige Updates überschrieben werden.
Warum synchronisieren meine Daten nicht zwischen Systemen?
Die häufigsten Ursachen sind abgelaufene Connector-Anmeldeinformationen, erschöpfte API-Ratenlimits, Schemaänderungen, die die Pipeline unterbrechen, und Bulk-Ladevorgänge, die Änderungsverfolgungs-Trigger umgehen. Prüfen Sie zuerst Connector-Protokolle und Abgleichsdeltas.
Soll die Synchronisierung standardmäßig ein- oder ausgeschaltet sein?
Ein, für jede Integration, bei der Geschäftsabläufe von konsistenten Daten über Systeme hinweg abhängen. Aus ist nur während geplanter Wartung, eines Rollback-Ereignisses oder einer bewussten Pause geeignet, während eine Schema-Migration angewendet wird.
Wie stoppe ich eine Synchronisierungspipeline sicher?
Verwenden Sie ein Feature-Flag oder einen Sync-Aktivierungs-Schalter, um die Pipeline ohne Code-Bereitstellung zu pausieren, erstellen Sie einen Snapshot des aktuellen Zustands des Zielsystems und dokumentieren Sie den Offset oder Prüfpunkt, sodass Sie von einer bekannten Position fortsetzen können, ohne erneut zu verarbeiten oder Ereignisse zu verlieren.
Was ist der Unterschied zwischen CDC und ETL für die Synchronisierung?
CDC liest kontinuierlich das Datenbank-Transaktionsprotokoll und erfasst jede Änderung mit geringer Quellbelastung, was es für nahezu Echtzeit-Synchronisierung geeignet macht. ETL fragt die Quelle nach einem Zeitplan ab, was einfacher zu betreiben ist, aber veraltete Fenster erzeugt und bei jedem Lauf Abfragelast auf das Quellsystem legt.