Moderner Daten-Stack: Ein praxisorientierter Fahrplan für Entscheidungsträger
Moderner Daten-Stack: Ein praxisorientierter Fahrplan für Entscheidungsträger Der moderne Daten-Stack ist eine cloudnative, ELT-/SQL-zentrierte Dateninfrastruktur, die Rohdaten aus Quellsystemen in einen kontrollierten, analysebereiten Zustand überführt und derzeit die praktikabelste Grundlage sowohl für schnelle Analysen als auch für KI-Bereitschaft darstellt. Wenn Ihr Team noch On-Premises-ETL-Pipelines betreibt, tagelang auf Berichte wartet oder sich fragt, warum Ihre ML-Modelle immer wieder unzuverlässige Ergebnisse liefern, ist diese Architektur die direkte Antwort. Die zentralen Bausteine sind ELT (Rohdaten zuerst laden und anschließend mithilfe von SQL im Warehouse transformieren), die Trennung von Speicher und Rechenleistung sowie modulare Werkzeuge. Gemeinsam reduzieren sie den Betriebsaufwand und bewahren gleichzeitig die Datenhistorie, die Ihre künftigen KI-Workloads benötigen werden.
Moderner Daten-Stack: Ein praxisorientierter Fahrplan für Entscheidungsträger
Der moderne Daten-Stack ist eine cloudnative, ELT-/SQL-zentrierte Dateninfrastruktur, die Rohdaten aus Quellsystemen in einen kontrollierten, analysebereiten Zustand überführt und derzeit die praktikabelste Grundlage sowohl für schnelle Analysen als auch für KI-Bereitschaft darstellt. Wenn Ihr Team noch On-Premises-ETL-Pipelines betreibt, tagelang auf Berichte wartet oder sich fragt, warum Ihre ML-Modelle immer wieder unzuverlässige Ergebnisse liefern, ist diese Architektur die direkte Antwort. Die zentralen Bausteine sind ELT (Rohdaten zuerst laden und anschließend mithilfe von SQL im Warehouse transformieren), die Trennung von Speicher und Rechenleistung sowie modulare Werkzeuge. Gemeinsam reduzieren sie den Betriebsaufwand und bewahren gleichzeitig die Datenhistorie, die Ihre künftigen KI-Workloads benötigen werden.
Inhaltsverzeichnis
-
Was ist ein moderner Daten-Stack, und was macht ihn „modern“?
-
Die Kernkomponenten: Was jede Ebene leistet und wer dafür verantwortlich ist
-
Wie unterscheidet sich ein moderner Stack von einer traditionellen Datenplattform?
-
Welche Governance- und Observability-Kontrollen sollten Sie von Anfang an aufbauen?
-
Welche strategischen Entscheidungen sollten Sie in den nächsten 12–36 Monaten treffen?
-
Umwelt- und Nachhaltigkeitsaspekte cloudnativer Daten-Stacks
-
Ridiculous Engineering entwickelt moderne Daten-Stacks, die tatsächlich ausgeliefert werden
Was ist ein moderner Daten-Stack, und was macht ihn „modern“?
Der Begriff wird oft unpräzise verwendet, daher ist eine genaue Definition wichtig. Ein moderner Daten-Stack ersetzt den monolithischen ETL-Altkern durch eine Reihe cloudverwalteter Dienste, von denen jeder für eine Ebene der Datenpipeline zuständig ist und die durch SQL als gemeinsame Schnittstelle verbunden sind. „Modern“ bezieht sich auf vier konkrete Architekturentscheidungen, nicht auf eine Marke oder einen Anbieter.
Grundprinzipien:
-
Cloudnative verwaltete Dienste. Keine Serverbereitstellung, keine im Voraus zu dimensionierenden Warehouse-Cluster. Die Rechenleistung skaliert elastisch, und bezahlt wird nur für die tatsächliche Nutzung.
-
ELT statt ETL. Rohdaten werden zuerst in das Warehouse geladen und anschließend direkt dort mit SQL transformiert. Der Speicherplatz in der Cloud ist kostengünstig; die Rechenleistung ist elastisch und wird pro Abfrage abgerechnet. Das Laden aller Rohdaten bewahrt Flexibilität: Wenn sich die Anforderungen in sechs Monaten ändern (das werden sie), sind die Quelldaten noch vorhanden.
-
SQL als Lingua franca. Analysten, Analytics Engineers und Data Engineers arbeiten alle mit derselben Sprache. Kognitive Übergaben zwischen der Vorverarbeitung in Python und der Berichterstellung in SQL entfallen weitgehend.
-
Trennung von Speicher und Rechenleistung. Berichtslasten konkurrieren nicht mehr mit Ad-hoc-Abfragen um dieselbe CPU. Das ML-Training liest dieselben Tabellen wie BI, ohne sie zu kopieren. Kapazitätsplanung, der Engpass der On-Premises-Ära, verschwindet weitgehend.
-
Modularität mit praxisnaher Konsolidierung. Jede Ebene ist theoretisch austauschbar. In der Praxis geht die Entwicklung 2026 in Richtung weniger Tools, die mehr leisten, nicht mehr Tools, die weniger leisten.
Diese Prinzipien stehen in direktem Zusammenhang mit Geschäftsergebnissen. Die Zeit bis zu neuen Erkenntnissen sinkt, weil Analysten selbstständig auf modellierte Tabellen zugreifen können, statt auf von der IT erstellte Berichte zu warten. Die Kosten werden planbarer, wenn Sie einen kleinen, disziplinierten Werkzeugsatz einsetzen. Und die KI-Bereitschaft ergibt sich ganz natürlich: Saubere, kontrollierte und zugängliche Daten sind die Voraussetzung dafür, dass jedes ML-Modell oder jeder KI-Agent zuverlässig Nutzen liefert.
Kostensignal: Ein Unternehmen, das den Standard-Stack verwendet, gibt typischerweise ein moderates monatliches Budget aus, das mit Teamgröße und Nutzung skaliert; die Rechenleistung des Warehouses ist dabei der wichtigste Kostentreiber. Die Abweichungen entfallen fast vollständig auf die Warehouse-Rechenleistung, die mit dem Abfragevolumen und der Disziplin des Teams bei inkrementellen gegenüber vollständigen Aktualisierungsläufen skaliert. Für typische Teams liegen die monatlichen Ausgaben bei 500–2.000 US-Dollar für ein Unternehmen mit 50 Beschäftigten und bei 5.000–20.000 US-Dollar für mittelständische Teams mit 50–200 Beschäftigten.
Die Kernkomponenten: Was jede Ebene leistet und wer dafür verantwortlich ist
Betrachten Sie den Analytics-Stack als Pipeline mit klar abgegrenzten Verantwortlichkeiten in jeder Phase. Die Vermischung von Ebenen ist die Ursache für die meisten Architekturfehler.
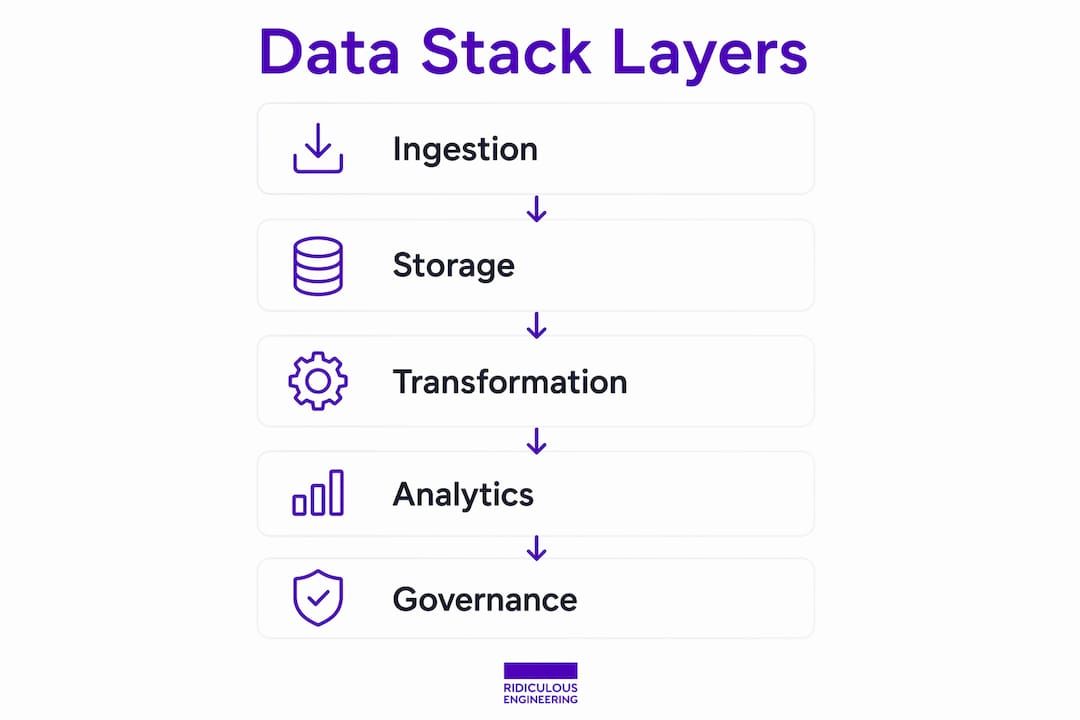
| Ebene | Verantwortung | Wichtige Signale / Einschränkungen | Typischer Verantwortlicher |
|---|---|---|---|
| Datenaufnahme | Rohdaten aus Quellen ins Data Warehouse übertragen; Schemaerkennung, inkrementelle Ladevorgänge und CDC handhaben | Verfügbarkeit von Konnektoren, Umgang mit personenbezogenen Daten, Synchronisierungshäufigkeit | Data Engineer / Plattformteam |
| Speicher / Data Warehouse | Rohdaten und modellierte Daten speichern; SQL-Abfragen bereitstellen; Rechenkapazität unabhängig skalieren | Abfr Kostenmodell, Parallelität, Unterstützung von ML-Workloads | Plattformteam |
| Transformation | Rohdatentabellen mithilfe von SQL in modellierte, getestete und dokumentierte Datenbestände umwandeln | Laufzeit der Modelle, inkrementelle Strategie, Testabdeckung | Analytics Engineer |
| Orchestrierung | DAGs planen, Fehler erneut versuchen, bei Störungen alarmieren, nachgelagerte Prozesse bei Fehlern vorgelagerter Prozesse blockieren | Komplexität der Pipelines, Python-Kenntnisse des Teams, verwaltet vs. selbst gehostet | Data Engineer |
| Datenqualität / Observability | Aktualität, Schemaänderungen, Nullraten und Testraten überwachen; alarmieren, bevor Stakeholder etwas bemerken | Empfindlichkeit gegenüber SLAs, Anforderungen an Datenverträge | Analytics Engineer + Plattformteam |
| Metriken / Semantische Ebene | Geschäftsmetriken einmal definieren; konsistente Zahlen für jedes BI-Tool bereitstellen | Metrik-Governance, BI-Umgebungen mit mehreren Tools | Analytics Lead + Geschäftsverantwortliche |
| BI / Analytics | Dashboards, Ad-hoc-Abfragen und Self-Service-Exploration bereitstellen | Technisches Niveau der Zielgruppe, Anforderungen an Einbettungen | Analytics-Team + Geschäftsverantwortliche |
| Reverse ETL / Aktivierung | Modellierte Daten zurück in operative Tools übertragen (CRM, Marketingplattformen) | Synchronisierungshäufigkeit, Einhaltung der Datenschutzvorgaben, API-Ratenlimits | Data Engineer + Marketing-/Sales-Operations |
| Streaming (bei Bedarf) | Ereignisverarbeitung mit niedriger Latenz handhaben, wenn die Batch-Frequenz nicht ausreicht | Latenz-SLA, Ereignisrate, Engineering-Kapazität | Plattform / Data Engineering |
Einige Hinweise zur Zuständigkeit sollten klar ausgesprochen werden. Geschäftsverantwortliche definieren typischerweise, was Metriken bedeuten, und geben Definitionen der semantischen Ebene frei. Plattformteams sind für Infrastruktur, Zugriffskontrollen und Kostenüberwachung zuständig. Analytics Engineers arbeiten an der Schnittstelle zwischen Data Engineering und Analyse; an dieser Rolle entscheidet sich bei den meisten modernen Stacks Erfolg oder Misserfolg. Teamübergreifende SLAs sind an der Grenze zwischen Datenaufnahme und Data Warehouse erforderlich (wer ist verantwortlich, wenn ein Quellkonnektor ausfällt?) sowie an der Grenze zwischen Transformation und BI (wer ist für eine fehlerhafte Dashboard-Metrik zuständig?).
Wo Teams häufig Fehler machen:
-
Die semantische Ebene überspringen und jeden BI-Bericht seine eigene Metriklogik definieren lassen, wodurch teamsübergreifend widersprüchliche Zahlen entstehen.
-
Orchestrierung als optional zu behandeln, bis Pipelines mehr als zehn Modelle umfassen, und dann hektisch nachzurüsten.
-
Die Beobachtung und Überwachung dem „jenigen zuzuweisen, der es bemerkt“, was bedeutet, dass es niemand tut, bis ein Stakeholder darauf aufmerksam wird.
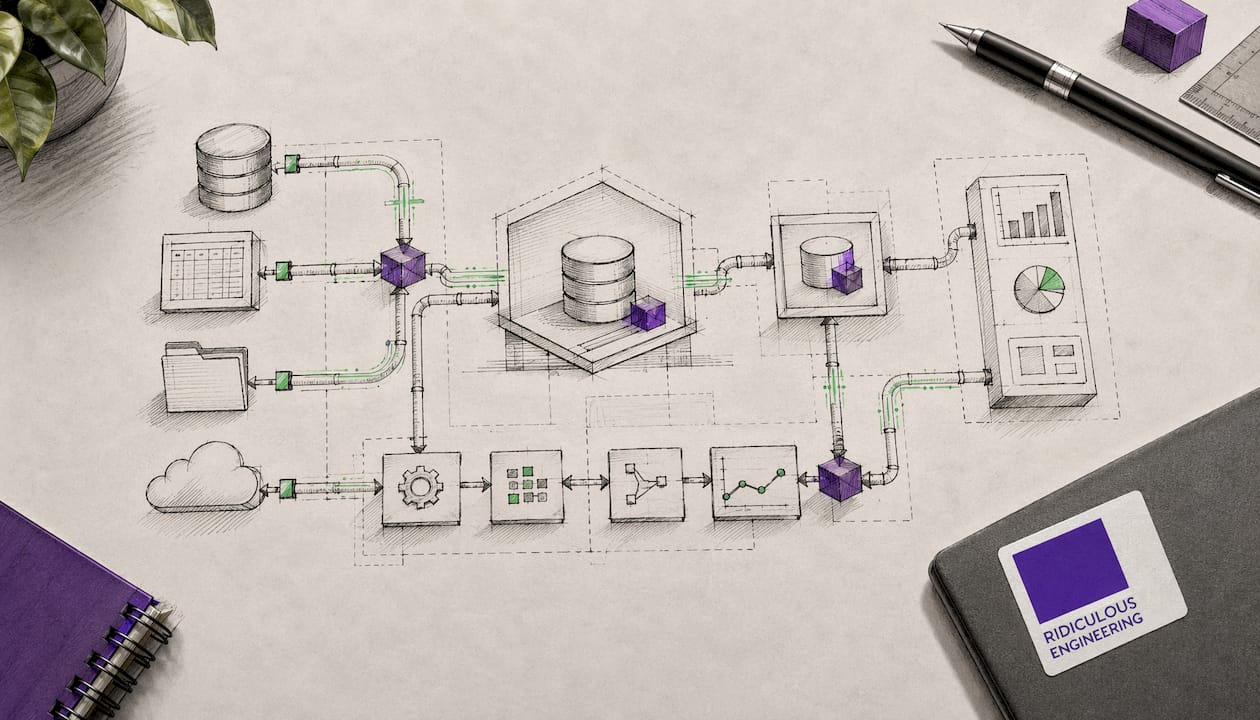
Welches Architekturmuster passt zu Ihrer Situation?
Warehouse-zentriert
Die Standardlösung für die meisten Teams. Ein Cloud-Warehouse (Snowflake, BigQuery oder Databricks SQL) dient als zentrale Drehscheibe. Rohdaten werden über Konnektoren dorthin geladen, dbt transformiert sie, und BI-Tools greifen direkt darauf zu. Einfach zu betreiben, gut dokumentiert und für die Mehrheit der Analytics-Workloads ausreichend.
Lakehouse
Offene Tabellenformate wie Apache Iceberg und Delta Lake liegen auf Objektspeichern (S3, GCS, ADLS) und unterstützen sowohl SQL-Analysen als auch ML-Training mit denselben physischen Daten. Lakehouse-Muster verringern die Abhängigkeit von einem Anbieter bei Speicherformaten und sind die richtige Wahl, wenn ML-Workloads neben BI eine zentrale Rolle spielen. Databricks ist der häufigste Einstiegspunkt; die Iceberg-Unterstützung von Snowflake hat den Abstand erheblich verkleinert.
Hybrid
Ein Warehouse übernimmt verwaltete Analysen; ein Lakehouse oder Data Lake übernimmt ML-Experimente und die Speicherung großer Rohdatenmengen. Mehr betriebliche Komplexität, aber angemessen für Organisationen, in denen ML- und Analytics-Teams tatsächlich unterschiedliche Anforderungen haben und genügend Engineering-Kapazitäten zur Pflege beider Systeme vorhanden sind.
Streaming-Ergänzungen
Der moderne Stack ist batchorientiert. Streaming-Architekturen (Kafka plus Flink oder Spark Streaming) laufen typischerweise neben dem Warehouse, statt es zu ersetzen. Das Versprechen eines „einheitlichen Batch- und Streamings“ wird seit Jahren immer wieder angepriesen; in der Praxis bestehen Echtzeitsysteme neben dem Warehouse und teilen nur selten Code mit ihm. Führen Sie Streaming nur ein, wenn ein Latenz-SLA dies tatsächlich erfordert, nicht weil es beeindruckend klingt. Für einen genaueren Blick darauf, wann sich Echtzeitmuster lohnen, Echtzeit-Datenmustersollten Sie sich ansehen, bevor Sie sich auf die Infrastrukturkosten festlegen.
Profi-Tipp: Beginnen Sie mit dem Warehouse-zentrierten Muster. Fügen Sie erst dann eine Lakehouse-Schicht hinzu, wenn ML-Workloads produktionsreif sind und das Team über einen dedizierten Plattformingenieur zur Pflege des offenen Tabellenformats verfügt. Führen Sie Streaming erst ein, wenn ein Geschäftsprozess ein dokumentiertes Latenz-SLA von unter fünf Minuten hat, das durch Batch-Verarbeitung nicht erfüllt werden kann.
Worin unterscheidet sich ein moderner Stack von einer traditionellen Datenplattform?
Der Unterschied ist deutlicher, als die meisten Migrationsvorschläge erkennen lassen.
Wichtige Unterschiede:
-
Bereitstellungsmodell. Legacy-Plattformen laufen On-Premises oder auf selbst verwalteten VMs. Moderne Stacks nutzen vollständig verwaltete Cloud-Dienste, für die keine Infrastruktur bereitgestellt werden muss.
-
ETL vs. ELT. Legacy-ETL transformiert Daten, bevor sie das Warehouse erreichen, häufig in proprietären Tools mit eingeschränkter Versionskontrolle. ELT lädt zunächst die Rohdaten und transformiert sie innerhalb des Warehouses mithilfe von SQL in Git.
-
Monolith vs. modular. Legacy-Plattformen bündeln Aufnahme, Transformation und Bereitstellung in einem Produkt. Moderne Stacks trennen diese Bereiche, was unabhängige Skalierung und klare Teamverantwortung ermöglicht.
-
Skalierungsmodell. On-Premises-Systeme erfordern Kapazitätsplanung und Hardwarebeschaffung. Cloud-Warehouses skalieren die Rechenkapazität innerhalb von Sekunden.
-
Self-Service vs. IT-gesteuerte Berichterstellung. Legacy-Systeme erfordern typischerweise, dass die IT jeden Bericht erstellt. Moderne Stacks stellen modellierte Tabellen Analysten und Geschäftsanwendern direkt zur Verfügung.
Die architektonischen Veränderungen, die dies ermöglichten, kamen nacheinander: Cloud-Objektspeicher machte die Aufbewahrung von Rohdaten kostengünstig, Cloud-Warehouses trennten Rechenleistung und Speicher, und dbt überführte die Transformationslogik in Git. Diese drei Veränderungen, die ungefähr zwischen 2016 und 2020 eintraten, machten den modernen Stack auch für Teams ohne große Infrastruktur-Budgets praktikabel.
Zu vermeidende Migrations-Anti-Patterns: Lift-and-Shift ohne Refactoring (Sie erhalten Cloud-Kosten bei einer On-Premises-Architektur), unkontrollierte inkrementelle Ladevorgänge, die Datensätze unbemerkt duplizieren, sowie der Verzicht auf die Einrichtung von Governance in der Annahme, dies später nachzuholen. Das werden Sie nicht tun, bis ein Vorfall Sie dazu zwingt.
Legacy-Plattformen bergen erhebliche betriebliche Risiken: Schemaänderungen führen zu Fehlern in nachgelagerten Berichten, ohne dass eine Datenherkunft zur Nachverfolgung der Auswirkungen vorhanden ist, Kapazitätsengpässe erzeugen Warteschlangen bei der Berichterstellung, und gespeicherte Prozeduren häufen technische Schulden an, die niemand anfassen möchte. Die Vorteile des Cloud-Computingsdes modernen Ansatzes sind nicht theoretisch; sie zeigen sich in einer geringeren Belastung durch Bereitschaftsdienste und schnelleren Iterationszyklen.
Welche Tools sollten Sie tatsächlich verwenden?
ELT mit SQL im Warehouse hat die Transformationsebene standardisiert, und dbt ist das Standardtool zur Verwaltung von SQL-Modellen. Der restliche Stack bietet mehr Auswahl, aber die Auswahlheuristik bleibt konsistent: Wählen Sie ein Tool pro Ebene, bevorzugen Sie bei begrenzten Teamkapazitäten verwaltete gegenüber selbst gehosteten Lösungen und planen Sie FinOps-Kontrollen ab dem ersten Tag ein.
| Ebene | Repräsentative Tools | Am besten geeignet für / Hinweise |
|---|---|---|
| Datenaufnahme | Fivetran, Airbyte, AWS Glue, Azure Data Factory | Fivetran: verwaltet, viele Konnektoren, minimaler Betriebsaufwand; Airbyte: Open-Source-Option; Glue/ADF: für AWS-/Azure-native Unternehmen |
| Data Warehouse | Snowflake, Google BigQuery, Databricks | Snowflake: analyseintensive Workloads, starke Governance; BigQuery: kosteneffizient bei großem Maßstab, serverlos; Databricks: ML-intensive Workloads |
| Transformation | dbt (Cloud oder Core), SQLMesh | dbt ist der Standard; SQLMesh ist die aufkommende Alternative für zustandsbewusste Ausführungen |
| Orchestrierung | Apache Airflow, Dagster, Prefect | Airflow führt nach Anzahl der Deployments; Dagster gewinnt bei assetbasierten Workflows an Bedeutung; Prefect für Python-orientierte Teams |
| Datenqualität / Observability | dbt-Tests, Monte Carlo, Soda | dbt-Tests decken anfangs die meisten Anforderungen ab; Monte Carlo und Soda für die Überwachung von Produktions-SLAs |
| Metriken / Semantische Schicht | dbt Semantic Layer, Cube | Metriken einmal definieren und für mehrere BI-Tools bereitstellen |
| BI / Analytics | Looker, Tableau, Power BI, Metabase | Looker für die Governance von Metriken; Metabase für umfassenden Self-Service; Tableau/Power BI für Berichte an die Führungsebene |
| Reverse ETL / Aktivierung | Census, Hightouch | Modellierte Daten an CRM-Systeme, Werbeplattformen und operative Tools übertragen |
| Streaming | Apache Kafka, Apache Flink, RisingWave | Parallel zum Data Warehouse; nur einführen, wenn die Latenz-SLA dies erfordert |
Auswahlkriterien für US-amerikanische Organisationen:
-
Wenn Ihr Team aus weniger als drei Data Engineers besteht, wählen Sie eine verwaltete Datenaufnahme (Fivetran) und dbt Cloud statt selbst gehosteter Alternativen. Die betrieblichen Einsparungen überwiegen die Lizenzkosten.
-
Snowflake und BigQuery sind beide starke Standardoptionen; die Entscheidung hängt üblicherweise von bestehenden Cloud-Beziehungen und davon ab, ob ML-Workloads im Vordergrund stehen.
-
Eine Vielzahl von Tools mit acht oder mehr SaaS-Tools verursacht erhebliche betriebliche und kostenseitige Reibungsverluste. In der Praxis reduzieren viele Teams auf vier Hauptkomponenten: Data Warehouse, dbt, einen Orchestrator und ein BI-Tool.
-
Apache Airflow ist konzeptionell wichtig zu verstehen, aber der Betrieb auf Kubernetes erfordert dediziertes Platform Engineering. Verwaltetes Airflow (Cloud Composer, MWAA, Astronomer) ist für die meisten Teams die praktikable Wahl.
Welche Governance- und Observability-Kontrollen sollten Sie ab dem ersten Tag aufbauen?
Governance, die nach einem Vorfall nachgerüstet wird, ist immer teurer als von Anfang an integrierte Governance. Dasselbe gilt für Observability. Behandeln Sie beides als Produktfunktionen mit eigenen SLAs und nicht als bloße Compliance-Checklisten.
Zentrale Säulen der Governance:
-
Zugriffskontrolle nach dem Prinzip der geringsten Privilegien.Rollenbasierter Zugriff auf Data-Warehouse-Ebene mit separaten Rollen für Rohdaten, modellierte Daten und mit PII gekennzeichnete Spalten. Kein Analyst sollte Schreibzugriff auf Rohdatenschemas haben.
-
Datenherkunft und Katalogisierung.Die integrierte Datenherkunft von dbt deckt die Transformationsebene ab. Erweitern Sie sie upstream (Quellsysteme) und downstream (BI-Berichte) mit einem Katalogtool oder warehouse-nativen Metadatenfunktionen.
-
Erkennung und Maskierung personenbezogener Daten.Kennzeichnen Sie PII-Spalten zum Zeitpunkt der Datenaufnahme. Wenden Sie dynamische Maskierungsrichtlinien im Data Warehouse an, damit nachgelagerte Modelle niemals rohe PII für nicht autorisierte Rollen offenlegen.
-
Audit-Protokollierung. Jede Abfrage, jede Schemaänderung und jede Rollenvergabe sollte protokolliert werden. Die meisten Cloud-Warehouses bieten dies nativ an; aktivieren Sie es, bevor Sie live gehen.
-
Governance für Metriken. Definieren Sie Geschäftsmetriken in der semantischen Ebene, nicht in einzelnen BI-Berichten. Wenn „Umsatz“ überall dasselbe bedeutet, entfällt das Meeting, in dem zwei Teams darüber streiten, wessen Zahl richtig ist.
Für die Observability sind die wichtigsten zu überwachenden Metriken Aktualität (wann wurde diese Tabelle zuletzt aktualisiert?), Schemaabweichungen (ist eine Quellspalte verschwunden?), Nullraten (ist ein kritisches Feld plötzlich leer?) und die Erfolgsraten von dbt-Tests. Lösen Sie dafür Warnungen aus, bevor Stakeholder etwas bemerken. Datenqualität korreliert direkt mit der Zuverlässigkeit von KI-Modellen. Observability ist daher nicht nur eine betriebliche Angelegenheit, sondern eine Investition in die KI-Bereitschaft.
Beispielhafte Richtlinien und Schutzmaßnahmen, die sich früh einzuführen lohnen: Nur Plattformingenieure dürfen in der Produktion dbt-Modelle mit vollständiger Aktualisierung ausführen; Schemaänderungen in Quellsystemen erfordern eine Vorankündigungsfrist von 48 Stunden und eine nachgelagerte Auswirkungsprüfung; PII-Spalten erfordern die Genehmigung eines Datenverantwortlichen, bevor sie von einem neuen Modell referenziert werden.
Profi-Tipp: Integrieren Sie das FinOps-Monitoring von Anfang an in Ihren Observability-Stack. Eine einzige unbeobachtete dbt-Aktualisierung mit vollständiger Aktualisierung oder eine erneute Synchronisierung eines Connectors bei einer Schemaänderung kann Ihre Warehouse-Rechnung innerhalb einer Woche verzehnfachen. Richten Sie Warnungen zu Abfragekosten und Budgets für Warehouse-Credits ein, bevor Sie Ihre erste Produktionspipeline integrieren. Cloud-Governance-Frameworks bieten hierfür eine nützliche Vorlage für Richtlinien.
Bei KI-gestützten Stacks gehen Sicherheitsaspekte über den Datenzugriff hinaus. Sicherheitsrisiken agentischer KI sind ein aufkommendes Governance-Thema, das Dataplattformteams verstehen sollten, bevor sie kontrollierten Daten KI-Agenten zugänglich machen.
Wie plant und erstellt man einen modernen Datenstack?
Phasen-Roadmap
Phase 1: Erkundung (Wochen 1–4). Prüfen Sie vorhandene Datenquellen, ermitteln Sie die drei bis fünf Geschäftsfragen, die der Stack am ersten Tag beantworten muss, und dokumentieren Sie die aktuellen Datenflüsse. Ergebnis: ein Quellenverzeichnis und eine priorisierte Liste von Anwendungsfällen.
Phase 2: MVP-Pilot (Wochen 5–12). Richten Sie ein Warehouse, einen Ingestion-Connector für die wichtigste Quelle, ein dbt-Projekt mit fünf bis zehn Modellen und ein BI-Dashboard ein. Ergebnis: eine funktionierende, getestete Pipeline, die eine Geschäftsfrage durchgängig beantwortet.
Phase 3: Ausbau (Monate 4–9). Fügen Sie Connectoren für die übrigen priorisierten Quellen hinzu, bauen Sie die dbt-Modellebene aus, führen Sie Orchestrierung ein, sobald die Pipelines mehr als zehn Modelle umfassen, und ergänzen Sie das Observability-Monitoring. Ergebnis: ein produktionsreifer Stack, der die zehn wichtigsten Anwendungsfälle abdeckt.
Phase 4: Operationalisierung (Monate 10–18). Formalisieren Sie Governance-Richtlinien, implementieren Sie die semantische Ebene, etablieren Sie FinOps-Kontrollen und dokumentieren Sie SLAs. Ergebnis: ein Stack, den das Team ohne außergewöhnliche Einzelleistungen warten und erweitern kann.
Rollen und Teamgröße
| Rolle | Verantwortung | Kleines Team (1–5 Datenfachleute) | Mittelständisches Unternehmen (5) | Unternehmen (groß) |
|---|---|---|---|---|
| Analytics Engineer | dbt-Modelle, Datenqualität, semantische Ebene | 1 (mit Analystenaufgaben geteilt) | 2–4 | 4–8 |
| Data Engineer | Ingestion, Orchestrierung, Plattformbetrieb | 1 (geteilt) | 2–4 | 4–10 |
| Plattform- / Dateninfrastruktur | Warehouse-Administration, Sicherheit, Finanzen | Gemeinsam mit dem Data Engineer | 1–2 dediziert | 2–5 dediziert |
| Analytics / BI | Dashboard-Entwicklung, Unterstützung der Stakeholder | 1 (geteilt) | 2–4 | 4–10 |
| Data Governance / Sicherheit | Richtlinien, Zugriffskontrolle, Compliance | Gemeinsam mit der Plattform | 1 in Teilzeit | 1–2 dediziert |
Für Empfehlungen zur Personalbesetzung beim Aufbau KI-fähiger Datenteams: Personalstrategie für KI-fähige Organisationen deckt die Kompetenzlücken ab, die die meisten Teams unterschätzen.
Implementierungs-Checkliste
-
Wählen Sie Ihr Warehouse (Snowflake, BigQuery oder Databricks) aus und schließen Sie den Vertrag ab. Richten Sie vor dem Laden von Daten Abrechnungswarnungen ein.
-
Beschaffen Sie eine verwaltete Ingestion-Lösung (Fivetran oder gleichwertig) und dokumentieren Sie die Connector-SLAs mit den Eigentümern der Quellsysteme.
-
Richten Sie ein dbt-Cloud-Konto und ein Git-Repository ein. Etablieren Sie Branch-Schutz und CI-Prüfungen für dbt-Modelle.
-
Definieren Sie die rollenbasierte Zugriffskontrolle im Warehouse, bevor Daten mit Personenbezug geladen werden.
-
Konfigurieren Sie die Überwachung der Abfragekosten und legen Sie eine monatliche Budgetgrenze fest, die bei 80 % Auslastung eine Warnung auslöst.
-
Dokumentieren Sie die Abnahmekriterien für den Go-live: eine minimale Testbestehensquote, ein Aktualitäts-SLA für jede Tabelle und die Freigabe durch Stakeholder für mindestens ein Dashboard von Ende zu Ende.
-
Planen Sie eine Überprüfung 30 Tage nach dem Launch ein, um die Zuverlässigkeit der Pipelines, die tatsächlichen Kosten im Vergleich zu den Schätzungen und die Teamkapazität zu bewerten.
Treiber der Kostenschätzung: Die Rechenleistung des Warehouses ist der dominierende Faktor und steigt mit dem Abfragevolumen und der Häufigkeit von Modellausführungen. Connector-Kosten steigen mit der Anzahl der Quellen und der Synchronisierungshäufigkeit. Datenaufbewahrungsrichtlinien beeinflussen die Speicherkosten moderat. Eine konsequente inkrementelle dbt-Strategie kann im Vergleich zu vollständigen Aktualisierungen die Warehouse-Rechenkosten bei großen Tabellen erheblich senken.
Welche strategischen Weichen sollten Sie in den nächsten 12–36 Monaten stellen?
Konsolidierung hin zu nativen Warehouse-Funktionen
Der Markt bewegt sich hin zu weniger, leistungsfähigeren Plattformen. Snowflake hat Snowpark und Streamlit ergänzt. Databricks hat Delta Live Tables und einen Orchestrator ergänzt. Microsoft Fabric bündelt Ingestion, Transformation und BI unter einer gemeinsamen Abrechnungsbeziehung. Die Beschaffungslogik verändert sich: Integrationsaufwand und acht separate SaaS-Abrechnungsbeziehungen sind jeweils eine eigene Form operativer Belastung. Für die meisten Teams ist der richtige Stack für 2026 kleiner als die kanonische Version: ein Warehouse, dbt, ein Orchestrator und ein BI-Tool.
Das Gegenargument lautet, dass Best-of-Breed-Tools auf den einzelnen Ebenen weiterhin besser abschneiden als native Warehouse-Alternativen. Das ist häufig richtig. Die Frage ist, ob der Leistungsunterschied die Integrationskosten rechtfertigt. Für Teams mit begrenzter Kapazität im Plattform-Engineering ist dies meist nicht der Fall. Für Muster für Datenaustausch und Konsolidierung sind die operativen Vorteile weniger Integrationspunkte gut dokumentiert.
KI-Fähigkeit als zentrales Designziel
KI-Fähigkeit ist keine Funktion, die Sie einem Daten-Stack hinzufügen; sie ist eine Folge davon, den Stack von Anfang an korrekt aufzubauen. Die Voraussetzungen sind Datenqualität (getestet, überwacht, zuverlässig), Datenherkunft (von der Quelle über das Modell bis zur Ausgabe nachvollziehbar) und ein kleiner, gut verwalteter Kerndatensatz, dem KI-Agenten vertrauen können. Vektorspeicher und Feature Stores sind für bestimmte ML-Anwendungsfälle relevant, bauen jedoch auf einem gut verwalteten Warehouse auf und ersetzen es nicht. Betriebliche KI-Bereitschaft für generative KI hängt von derselben Datengrundlage ab.
Profi-Tipp: Bevor Sie in eine Vektordatenbank oder einen Feature Store investieren, prüfen Sie die bestehende Testabdeckung Ihrer dbt-Modelle. Liegt die Testbestehensquote bei kritischen Modellen unter 90 %, sind darauf basierende KI-Ausgaben unzuverlässig, unabhängig davon, wie hochentwickelt das Modell ist. Beheben Sie zuerst die Grundlage.
Wann Sie einstellen und wann Sie einen Berater beauftragen sollten
Stellen Sie einen eigenen Plattformingenieur ein, wenn die Anzahl Ihrer Pipelines 20 übersteigt und Ihr Dateningenieur mehr als 30 % seiner Zeit für Infrastruktur statt für Datenarbeit aufwendet. Beauftragen Sie einen externen Partner wie Ridiculous Engineering, wenn Sie den Zeitraum von der Erkundung bis zum MVP verkürzen müssen, wenn Ihnen interne Architekturkenntnisse für den ersten Entwurf fehlen oder wenn ein Governance- oder KI-Bereitschaftsaudit eine externe Perspektive erfordert. Die Abwägungen bei der SaaS-Konsolidierung zwischen verwalteten Diensten und selbst gehosteten Optionen sollten Sie verstehen, bevor Sie langfristige Anbieterbindungen eingehen.
Umwelt- und Nachhaltigkeitsaspekte cloudnativer Daten-Stacks
Cloudnative Daten-Stacks haben einen realen ökologischen Fußabdruck, den man vor der Festlegung auf eine Warehouse- und Compute-Konfiguration verstehen sollte. Die großen Cloudanbieter (AWS, Google Cloud, Microsoft Azure) haben Verpflichtungen zu CO₂-Neutralität oder Netto-Null veröffentlicht, und ihre Hyperscale-Rechenzentren arbeiten typischerweise energieeffizienter als lokale Alternativen. Dieser Effizienzvorteil ist real, macht Cloud-Computing jedoch nicht CO₂-frei.
Die wichtigsten Stellschrauben zur Verringerung der Umweltbelastung eines Daten-Stacks sind effiziente Datenverarbeitung und eine konsequente Datenaufbewahrung. Schlecht geschriebene dbt-Modelle, die bei großen Tabellen vollständige Aktualisierungen ausführen, verschwenden Rechenleistung; inkrementelle Modelle, die nur neue Datensätze verarbeiten, benötigen nur einen Bruchteil der Ressourcen. Nicht verwendete Dashboards, die geplante Abfragen auslösen, Konnektoren, die im Fünf-Minuten-Takt synchronisieren, obwohl eine tägliche Synchronisierung ausreichen würde, und Warehouses, die ohne automatische Pause weiterlaufen, tragen allesamt zu unnötigem Energieverbrauch bei. FinOps-Kontrollen, die Kosten senken, reduzieren auch den CO₂-Ausstoß, sodass die wirtschaftliche und die nachhaltigkeitsbezogene Argumentation in dieselbe Richtung weisen.
Auch Richtlinien zur Datenaufbewahrung sind wichtig. Alle Rohereignisse dauerhaft in einem Warehouse zu speichern, ist teuer und energieintensiv. Mehrstufige Speicherung (heiße Daten im Warehouse, kalte Daten im Objektspeicher) reduziert sowohl Kosten als auch den Rechenaufwand für historische Daten, die nur selten abgefragt werden. Teams, die Datenaufbewahrung als Governance-Entscheidung statt als Standardeinstellung behandeln, betreiben tendenziell schlankere, günstigere und umweltverträglichere Stacks.
Wichtigste Erkenntnisse
Ein moderner Daten-Stack auf Basis von ELT, SQL-zentrierter Transformation und cloudnativen verwalteten Diensten ist 2026 die praktischste Grundlage für schnelle Analysen und KI-Bereitschaft.
| Punkt | Details |
|---|---|
| Klein anfangen und diszipliniert bleiben | Ein Stack aus vier Tools (Warehouse + dbt + 1 Orchestrator + 1 BI-Tool) übertrifft für die meisten Teams eine Zusammenstellung aus acht Tools. |
| Schwankungen bei den Rechenkosten einplanen | Für die meisten Teams liegen die monatlichen Ausgaben bei Unternehmen mit 50 Beschäftigten zwischen 500 und 2.000 US-Dollar und im Mittelstand (50–200 Beschäftigte) zwischen 5.000 und 20.000 US-Dollar; die Rechenleistung des Warehouses ist der wichtigste Kostentreiber. |
| Governance vom ersten Tag an | Zugriff nach dem Prinzip der geringsten Rechte, Maskierung personenbezogener Daten und FinOps-Warnmeldungen müssen vor dem Eintreffen von Produktionsdaten konfiguriert werden, nicht erst nach einem Vorfall. |
| KI-Bereitschaft erfordert zunächst Datenqualität | Testabdeckung, Datenherkunft und Überwachung der Aktualität von dbt-Modellen sind Voraussetzungen für zuverlässige KI-Ergebnisse. |
| Ridiculous Engineering beschleunigt die Einführung | Ridiculous Engineering bietet Erkundungsaudits, MVP-Design, Plattformengineering und die Einrichtung von Governance, um die Zeit bis zur Produktionsreife zu verkürzen. |
Ridiculous Engineering entwickelt moderne Daten-Stacks, die tatsächlich live gehen
Den meisten Teams, die mit ihrer Dateninfrastruktur zu kämpfen haben, fehlt es nicht an Ehrgeiz. Ihnen fehlt es an Zeit, Architekturerfahrung oder an beidem. Ridiculous Engineering ist eine in Colorado ansässige Softwareentwicklungsberatung, die Daten- und Analysesysteme für Organisationen entwirft, entwickelt und in den Betrieb überführt, die einen produktionsreifen Stack benötigen, ohne dafür sechs Monate Vorlauf einplanen zu müssen. Das Vorgehensmodell ist praxisorientiert: ein fokussiertes Erkundungsaudit zur Erfassung Ihrer Quellen und Anwendungsfälle, ein MVP-Design, das Sie innerhalb weniger Wochen zu einer funktionierenden Pipeline bringt, sowie Unterstützung beim Plattformengineering, um Governance, FinOps-Einrichtung und die Prüfung der KI-Bereitschaft umzusetzen. Wenn Ihr Team über die nötigen Talente verfügt, aber Architekturberatung benötigt, reicht oft schon ein kurzes Beratungsprojekt aus, um die kostspieligsten Fehler zu vermeiden. Kontaktieren Sie Ridiculous Engineering, um ein Erkundungsprojekt zu besprechen.
Nützliche Quellen
-
Der moderne Daten-Stack, ehrlich bewertet – Die direkteste Bewertung der Fünf-Schichten-Architektur aus der Praxis, ihrer Abwägungen und der Konsolidierungsrichtung für 2026. Primärquelle für die in diesem Artikel genannten Kostenbereiche, Standardtools und Einschränkungen beim Streaming.
-
So erstellen Sie 2026 einen modernen Daten-Stack – Praxisleitfaden zur Dominanz von ELT/SQL, zu dbt als Standard für Transformationen und zu Orchestrierungsoptionen. Nützlich für die Reihenfolge der Umsetzung.
-
Moderner Daten-Stack 2026: Vollständiger Leitfaden zu Tools und Architektur – Architekturmuster einschließlich Lakehouse und offenen Tabellenformaten; Überblick über Orchestrierungstools mit Airflow, Dagster und Prefect.
-
Was ist ein moderner Daten-Stack und warum ist er wichtig? – ThoughtSpots Überblick, der Datenqualität und Observability mit KI-Bereitschaft verknüpft. Nützlich für die Abschnitte zu Governance und KI-Bereitschaft.
-
Architektur moderner Datenplattformen: Einen skalierbaren Daten-Stack aufbauen – Technische Vertiefung zur Trennung von Speicherung und Rechenleistung sowie zu SQL als gemeinsamer Schnittstelle.
-
AWS Glue – Primäre Anbieterdokumentation für serverlose Datenintegration auf AWS; Referenz für AWS-native Optionen zur Datenaufnahme und für ELT-Pipelines.
-
Azure Data Factory – Dokumentation des verwalteten Datenintegrationsdienstes von Microsoft; Referenz für die Konfiguration von Azure-nativer Datenaufnahme sowie von ELT-/ETL-Pipelines.
-
Apache Software Foundation — Primärquelle für die Dokumentation zu Apache Airflow, Apache Kafka, Apache Flink, Apache Iceberg und Apache Hudi.
-
Ridiculous Engineering: Cloud Computing für Unternehmenswachstum — Architektur- und Cloud-Strategie-Leitfaden für Technologieführungskräfte, die eine moderne Dateninfrastruktur entwickeln.
-
Ridiculous Engineering: KI und Datenqualität verstehen — Erklärt den Zusammenhang zwischen Datenqualität, Observability und dem Vertrauen in KI-Modelle.
FAQ
Was ist ein moderner Datenstack?
Ein moderner Datenstack ist eine cloudnative, ELT-/SQL-zentrierte Dateninfrastruktur, die Rohdaten aus Quellsystemen aufnimmt, in einem Cloud-Warehouse oder einer Lakehouse-Umgebung speichert, sie mithilfe von SQL (typischerweise mit dbt) transformiert und für BI-Tools sowie KI-Workloads bereitstellt. Zu den prägenden Merkmalen gehören verwaltete Cloud-Dienste, die Trennung von Speicher und Rechenleistung sowie eine versionskontrollierte Transformationslogik.
Ist der moderne Datenstack noch ein nützliches Konzept?
Ja, die grundlegenden Prinzipien sind etabliert und nach wie vor der richtige Ansatz: cloudnative Dienste, ELT, SQL-zentrierte Transformation und die Trennung von Speicher und Rechenleistung. Was sich ändert, ist die Zusammensetzung der Tools. Die Zusammenstellung aus acht spezialisierten Best-of-Breed-Tools wird zunehmend durch eine warehouse-native Konsolidierung ersetzt, sodass der moderne Stack im Jahr 2026 typischerweise aus vier statt acht Tools besteht.
Was ist der Unterschied zwischen einem traditionellen und einem modernen Datenstack?
Traditionelle Plattformen verwenden ETL (Transformation vor dem Laden), laufen auf lokalen oder selbstverwalteten Infrastrukturen und erfordern, dass die IT jeden Bericht erstellt. Moderne Stacks verwenden ELT (Rohdaten laden und im Warehouse mit SQL transformieren), laufen auf verwalteten Cloud-Diensten und stellen modellierte Daten Analysten zur Self-Service-Nutzung direkt bereit. Das Betriebs- und Kostenmodell unterscheidet sich grundlegend.
Welche Datenstack-Tools liegen 2026 im Trend?
Die Standardauswahl umfasst Snowflake oder Google BigQuery als Warehouse, dbt für die Transformation, Apache Airflow (oder Dagster für neue Implementierungen) für die Orchestrierung und Fivetran für die verwaltete Datenaufnahme. Der übergreifende Trend geht zur Konsolidierung: Warehouse-native Funktionen verringern den Bedarf an separaten spezialisierten Best-of-Breed-Tools auf jeder Ebene.
Wie viel kostet ein moderner Datenstack pro Monat?
Ein Unternehmen mit dem Standardstack gibt typischerweise 500–2.000 $ pro Monat für ein Team mit 50 Personen und 5.000–20.000 $ für den Mittelstand (50–200 Beschäftigte) aus. Ausschlaggebend sind vor allem die Rechenkosten des Warehouses, die mit der Teamgröße und Nutzung steigen.
Empfohlen
-
Transformationales Wachstum mit Cloud Computing | Ridiculous Engineering | Ridiculous Engineering
-
Strategie für eine komposable Architektur 2026 | Ridiculous Engineering
-
Das moderne Web entwickeln: Headless-CMS-Technologie | Ridiculous Engineering
-
Sieben Lektionen, die uns COVID-19 über Datenstrategie gelehrt hat | Ridiculous Engineering