LLM-Governance: Ein praktischer Leitfaden für Führungskräfte
LLM-Governance: Ein praktischer Leitfaden für Führungskräfte. LLM-Governance umfasst Richtlinien, Rollen und Laufzeitkontrollen, die steuern, wie große Sprachmodelle in der Produktion eingesetzt, überwacht und zur Verantwortung gezogen werden.
LLM-Governance: Ein praktischer Leitfaden für Führungskräfte
LLM-Governance umfasst Richtlinien, Rollen und Laufzeitkontrollen, die steuern, wie große Sprachmodelle in der Produktion eingesetzt, überwacht und zur Verantwortung gezogen werden. Anders als die traditionelle KI-Governance, die ein Modell meist vor dem Start prüft und es dabei belässt, betrachtet LLM-Governance die Bereitstellung als Beginn des Risikofensters, nicht als dessen Ende.
Wenn Sie in Ihrer Organisation die Verantwortung für Technologie oder Risiken tragen, sollten Sie zunächst diese fünf Schritte umsetzen:
- Jeden Anwendungsfall einer Risikoklasse zuordnen auf Grundlage der geschäftlichen Auswirkungen und des Autonomiegrads, nicht nur der Datensensibilität.
- Eine verantwortliche Person benennen für jedes bereitgestellte Modell oder jeden Agenten, nicht nur eine allgemein für „KI“ zuständige Person.
- Laufzeitüberwachung einrichten damit Sie Prompts, Antworten und Abweichungen sofort erkennen können.
- Datenverkehr kontrollieren auf der API-Ebene, damit fehlerhafte Ausgaben gefiltert werden, bevor sie Kunden erreichen.
- Einen Auditplan erstellen der Governance-, Modell- und Anwendungsebenen abdeckt, statt nur eine Checkliste vor dem Start zu enthalten.
Das ist die gesamte Sache in Kurzform. Im Rest dieses Leitfadens erläutern wir, wie Sie sie aufbauen.
Die wichtigsten Erkenntnisse
Wirksame LLM-Governance erfordert, den Schwerpunkt von einer einmaligen Validierung vor der Bereitstellung auf kontinuierliche Laufzeitüberwachung in Verbindung mit koordinierten Audits auf drei Ebenen zu verlagern.
| Punkt | Details |
|---|---|
| Der Umfang geht über das Modell hinaus | Governance muss Prompts, RAG-Pipelines, agentisches Verhalten, Anbieter und Datenflüsse abdecken, nicht nur Modellgewichte. |
| Laufzeitüberwachung ist die wichtigste Kontrolle | Kontinuierliche Überwachung von Prompts, Ausgaben und KRIs erkennt Abweichungen, die Tests vor dem Start übersehen. |
| Audits auf drei koordinierten Ebenen durchführen | Governance-, Modell- und Anwendungsaudits sollten Nachweise füreinander liefern, statt isoliert voneinander abzulaufen. |
| Namentliche Verantwortlichkeiten festlegen | Jeder Anwendungsfall mit hohem Risiko braucht eine bestimmte verantwortliche Person, kein gemeinsames Team-Postfach. |
| Frühzeitig technische Unterstützung einholen | Ridiculousengineering entwickelt die Infrastruktur für Datenverkehrskontrolle, Protokollierung und Überwachung, auf die Governance-Richtlinien angewiesen sind. |
Inhaltsverzeichnis
- Was deckt LLM-Governance tatsächlich ab?
- Welche Prinzipien sollten Ihrer LLM-Governance-Richtlinie zugrunde liegen?
- Aus welchen Komponenten besteht ein LLM-Governance-Framework?
- Wie sollten Sie ein LLM-System auditieren?
- Welche Laufzeitkontrollen verhindern LLM-Vorfälle tatsächlich?
- Wie operationalisieren Sie LLM-Governance im Tagesgeschäft?
- Welche Fehler sollten Sie bei der LLM-Governance vermeiden?
- Wie sollten die ersten 90 Tage Ihrer LLM-Governance aussehen?
- Die Governance-Infrastruktur selbst entwickeln
- Quellen
- FAQ
Was deckt LLM-Governance tatsächlich ab?
LLM-Governance geht weit über die Modelldatei selbst hinaus. Sie umfasst das Modell, die Prompt-Oberfläche, Retrieval-Pipelines, agentische Workflows, Drittanbieterintegrationen, Anbieter-Verträge und die Daten, die durch all diese Komponenten fließen. Wenn Sie nur die Modellgewichte verwalten, kontrollieren Sie vielleicht ein Drittel Ihrer tatsächlichen Risikooberfläche.
Hier liegt der Unterschied, der die meisten Teams vor Probleme stellt: Traditionelle ML-Governance geht davon aus, dass ein Modell für eine bestimmte Eingabe konsistente, deterministische Ausgaben erzeugt, und validiert es einmal anhand eines Testsatzes. LLMs funktionieren nicht so. Derselbe Prompt kann bei verschiedenen Durchläufen unterschiedliche Ausgaben erzeugen. Kleine Änderungen am Prompt können völlig anderes Verhalten hervorrufen. Und sobald Sie Retrieval-Augmented Generation (RAG) oder die Nutzung von Tools durch Agenten hinzufügen, entstehen emergente Verhaltensweisen, die keine statische Testsuite erfasst. Untersuchungen zu Multi-Agenten-LLM-Systemen haben gezeigt, dass einzeln „sichere“ Agenten durch Kaskadenausfälle und Konformitätsverzerrungen zwischen den Agenten dennoch unsichere Systeme erzeugen können, sobald sie miteinander interagieren.
Dieses Risiko betrifft mehr Bereiche des Unternehmens, als die meisten Führungskräfte annehmen. Typischerweise fallen darunter:
- Kundenservice-Bots und Support-Automatisierung
- Interne Wissensmanagement- und Suchwerkzeuge
- Analyse-Copiloten, die sensible Daten zusammenfassen
- Workflow-Automatisierung mit Schreibzugriff auf Produktionssysteme
- Jeder Agent, der Aktionen ausführen kann (eine E-Mail senden, eine Rückerstattung ausstellen, einen Datensatz ändern)
Profi-Tipp: Behandeln Sie einen Anwendungsfall ab dem Moment als „wesentlich risikorelevant“, in dem er eine autonome Aktion ausführen, regulierte Daten berühren oder ohne menschlichen Prüfschritt einen externen Kunden erreichen kann. Die Wesentlichkeit, nicht die Modellgröße, sollte bestimmen, wie intensiv ein Anwendungsfall geprüft wird.
Welche Prinzipien sollten Ihrer LLM-Governance-Richtlinie zugrunde liegen?
Jede LLM-Governance-Richtlinie braucht eine kleine Anzahl von Prinzipien, die in tatsächliche Kontrollen übersetzt werden, statt in unverbindliche Formulierungen für eine Präsentation. Sechs leisten dabei den größten Beitrag:
- Transparenz: Nutzer und interne Beteiligte sollten wissen, wann sie mit einem LLM interagieren und ungefähr nachvollziehen können, wie es zu einer Ausgabe gelangt ist.
- Verantwortlichkeit: Eine benannte Person oder ein benanntes Team trägt Ende zu Ende die Verantwortung für das Verhalten jedes bereitgestellten Modells.
- Sicherheit und Zuverlässigkeit: Das System verschlechtert sich kontrolliert und verfügt über eine Ausweichlösung, wenn die Konfidenz niedrig ist.
- Datenschutz: Eingaben und Ausgaben berücksichtigen Vorgaben zu Datenstandort, Aufbewahrung und Datenschutz.
- Fairness: Ausgaben werden auf unterschiedliche Auswirkungen auf verschiedene Nutzergruppen geprüft, nicht nur auf die aggregierte Genauigkeit.
- Prüfbarkeit: Jede wesentliche Entscheidung hinterlässt eine Spur, die ein Dritter später prüfen könnte.
Jedes Prinzip betrifft einen anderen Beteiligten. Genau deshalb scheitert Governance, wenn sie als Aufgabe eines einzigen Teams behandelt wird. Die Rechtsabteilung legt den größten Wert auf Transparenz und Datenschutz. Die Sicherheitsabteilung verantwortet Zuverlässigkeit und Zugriffskontrolle. Das Produktteam verantwortet Fairness und Nutzererfahrung. Der Vorstand will vor allem Verantwortlichkeit, also eine klare Antwort auf die Fragen: „Wer hat das freigegeben, und wen rufen wir an, wenn es ausfällt?“
Operativ sind diese Prinzipien nicht nur Werte, sondern konkrete Artefakte. Transparenz wird zu einem Hinweis zur Offenlegung und einer Modellkarte. Verantwortlichkeit wird zu einem Freigabeprotokoll. Prüfbarkeit wird zu einer aufbewahrten Spur von Prompts, abgerufenem Kontext und Ausgaben. Wenn ein Prinzip nicht irgendwo in Ihrer Pipeline ein Dokument, ein Dashboard oder eine Sperre hervorbringt, ist es noch keine Governance, sondern nur ein Leitbild.
Aus welchen Komponenten besteht ein LLM-Governance-Framework?
Ein LLM-Governance-Framework ist nur so gut wie die dahinterstehenden Artefakte. Prinzipien verhindern keine fehlerhafte Bereitstellung; eine fehlende Modellkarte oder eine nicht zugewiesene risikoverantwortliche Person schon gar nicht. Folgendes muss tatsächlich vorhanden sein:
Erforderliche Artefakte:
- Eine Bewertungsmatrix zur Risikoklassifizierung, die Anwendungsfälle nach Autonomie, Datensensibilität und Schadensradius bewertet
- Ein Modellverzeichnis mit jedem LLM, jedem Fine-Tuning und jedem Anbieter API in der Produktion
- Modellkarten mit Dokumentation zu Herkunft der Trainingsdaten, bekannten Einschränkungen und vorgesehener Nutzung
- Zugriffs- und Token-Kontrollen, die festlegen, welche Systeme und Nutzer welche Modelle aufrufen dürfen
- Datenherkunftsverfolgung, die erfasst, welche Daten in Prompts gelangen und wo Ausgaben gespeichert werden
- Freigabesperren, die eine Genehmigung verlangen, bevor ein Modell oder eine Prompt-Änderung ausgerollt wird
- Runbooks für die Reaktion auf Vorfälle, wenn sich ein Modell in der Produktion fehlerhaft verhält
- Überwachungsdashboards, die wichtige Risikoindikatoren (KRIs) nahezu in Echtzeit sichtbar machen
Richtlinien- und Prozesselemente:
- Freigaben im gesamten Lebenszyklus in jeder Phase: Entwicklung, Staging, Produktion und Stilllegung
- Prüfung von Drittanbietermodellen vor der Beschaffung, einschließlich einer Sicherheits- und Bias-Prüfung
- Vertragsklauseln zu Datenverarbeitung, Benachrichtigungen über Modellaktualisierungen und Haftung
- Service-Level-Agreements mit Definitionen für akzeptable Latenz, Verfügbarkeit und Eskalationszeiträume
Nichts davon muss gleichzeitig eingeführt werden. Weisen Sie jedem Artefakt eine verantwortliche Person und eine Frist zu: Die Sicherheitsabteilung übernimmt Zugriffskontrollen und Token-Einschränkungen, die Entwicklung Modellkarten und Überwachungsdashboards, die Rechtsabteilung Anbieter-Verträge und die Dokumentation der Datenherkunft, und das Produktteam die Risikoklassifizierung mit Beiträgen aller anderen Funktionen. Das MindForge AI Risk Management Handbook beschreibt ein ähnliches Betriebsmodell für Finanzinstitute, und seine Logik zur Risikoklassifizierung lässt sich problemlos auf nahezu jede regulierte oder kundenorientierte Bereitstellung übertragen.
Wie sollten Sie ein LLM-System auditieren?
Das Audit eines LLM-Systems erfordert drei getrennte Ebenen. Wenn eine davon als allein ausreichend betrachtet wird, scheitern Governance-Programme unbemerkt. Die Forschung zum Audit großer Sprachmodelle beschreibt diese als Governance-, Modell- und Anwendungsaudits, die so koordiniert werden, dass Nachweise jeder Ebene die anderen informieren.
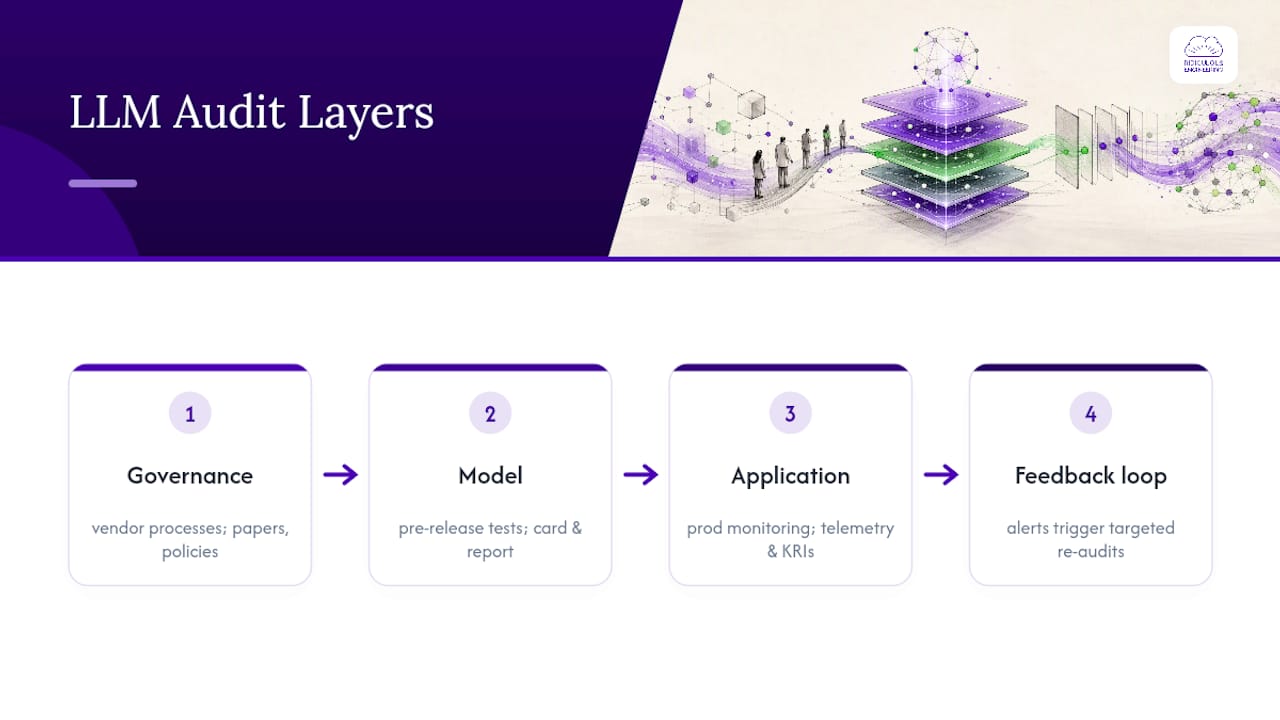
Governance-Audits untersuchen die Anbieter und internen Prozesse, durch die das Modell entsteht: die Beschaffung der Trainingsdaten, Qualitätsmanagementpraktiken und dokumentierte Entwicklungsstandards. Die Nachweise bestehen hier hauptsächlich aus Dokumentationsspuren, Anbieterbestätigungen und Richtliniendokumenten. Sie zeigen, ob der Prozess zur Erstellung des Modells solide war, sagen aber nichts darüber aus, wie sich das Modell im laufenden Betrieb verhält.
Modellaudits finden nach dem Vortraining und vor der Veröffentlichung statt. Hier kommen Red-Teaming und adversariales Testen zum Einsatz: Sie suchen nach Jailbreaks, Bias, Halluzinationsraten und Fehlern in Sonderfällen, bevor das Modell mit Kunden interagiert. Das Ergebnis sollte eine Modellkarte und ein Bericht zur Testmethodik mit Bestehens- und Durchfallgrenzwerten sein. Die Einschränkung wird sofort deutlich: Ein Modellaudit ist eine Momentaufnahme, und das Verhalten von LLMs verändert sich, wenn sich Prompts, Retrieval-Quellen und Nutzergruppen ändern.
Anwendungsaudits sind die Ebene, die die meisten Organisationen überspringen, obwohl sie in der Praxis am wichtigsten ist. Dabei handelt es sich um kontinuierliche, produktionsnahe Prüfungen, die echte Prompts und echte Ausgaben beobachten, KRIs wie Halluzinations- und Ablehnungsraten verfolgen und Abweichungen erkennen, sobald sie auftreten. Eine Untersuchung zum Risikomanagement generativer KI-Modelle legt den Fall klar dar: Eine statische Validierung vor der Bereitstellung allein reicht für GenAI-Systeme nicht aus. Kontinuierliche Überwachung in Verbindung mit einer durch KI unterstützten Compliance-Prüfung übernimmt den größeren Teil der Arbeit.
Die drei Ebenen sollten sich gegenseitig speisen. Eine deutliche Veränderung der Risikoindikatoren aus der Anwendungsüberwachung sollte ein gezieltes Modellaudit auslösen. Eine geänderte Offenlegung der Trainingsdaten durch einen Anbieter sollte eine Aktualisierung des Governance-Audits auslösen.
Profi-Tipp: Bauen Sie eine zentrale Nachweispipeline auf, die Auditberichte archiviert, Laufzeittelemetrie streamt und Korrekturmaßnahmen an einem Ort protokolliert. Wenn eine Aufsichtsbehörde oder ein Vorstandsmitglied fragt: „Beweisen Sie es“, sollten Sie ein einziges System abfragen können, statt drei Teams hinterherzulaufen.
Welche Laufzeitkontrollen verhindern LLM-Vorfälle tatsächlich?
Laufzeitkontrollen, nicht Checklisten vor dem Start, erkennen die meisten LLM-Vorfälle, bevor sie einen Kunden erreichen. Hier hört Governance auf, ein Richtliniendokument zu sein, und wird zu Code.
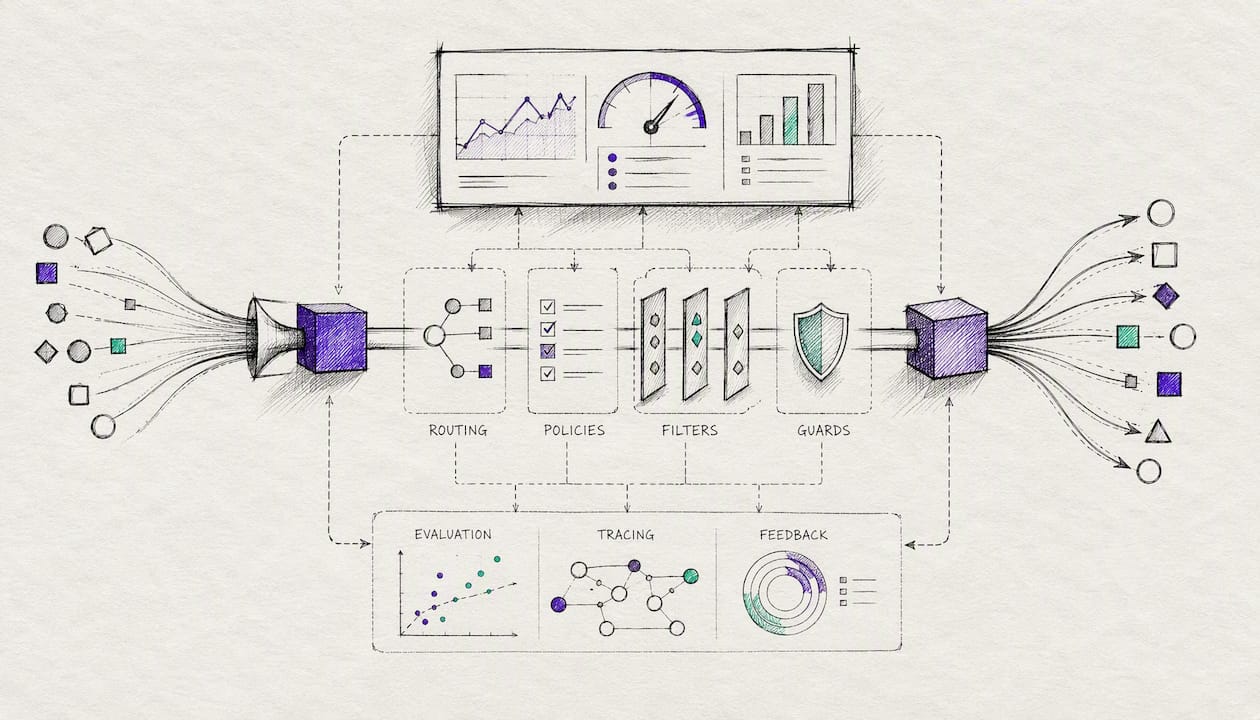
Datenverkehrs-Governance sitzt am API-Gateway. Filter auf Gateway-Ebene können Prompts blockieren, die bekannten Injection-Mustern entsprechen, Token so einschränken, dass eine bestimmte Integration nur freigegebene Modellendpunkte aufrufen kann, und Aufrufe pro Anwendungsfall begrenzen, um den Schadensradius bei Problemen einzudämmen. Wenn Sie Anwendungsfälle mit hohem Risiko an einen kleineren, strenger geprüften Modellpool statt an ein universelles Frontier-Modell weiterleiten, verringert sich die Gefährdung zusätzlich. Partnerplattformen für Governance auf API-Ebene wie Jundago’s approach to testing and governing APIszeigen, wie sich dieses Muster über den LLM-Datenverkehr hinaus auch auf REST- und GraphQL-Ebenen übertragen lässt.
RAG- und Retrieval-Kontrollen sind ebenso wichtig. Verfolgen Sie die Herkunft jedes abgerufenen Abschnitts, damit Sie wissen, welche Quelle eine Antwort beeinflusst hat. Entfernen Sie sensible Felder, bevor sie in einen Prompt gelangen. Setzen Sie Grenzen für den Retrieval-Recall, damit das System nicht unbemerkt veraltete oder nicht autorisierte Indizes abfragt. Sichern Sie den Zugriff auf den Embedding-Speicher mit derselben Sorgfalt wie eine Produktionsdatenbank, denn praktisch handelt es sich genau darum.
Überwachung ist das verbindende Element. Protokollieren Sie Prompts und Antworten (mit angemessener Schwärzung), erfassen Sie Debug-Traces für fehlgeschlagene Aufrufe und stellen Sie Dashboards für Kosten, Latenz und KRIs nebeneinander. Die SANS guidance on risk-based AI controls empfiehlt, insbesondere Halluzinationsraten, Jailbreak-Versuche und Prompt-Abweichungen als laufende Kennzahlen zu überwachen, nicht als einmalige Tests.
Ein Muster, das Sie direkt übernehmen sollten: Leiten Sie Ausgaben durch ein Panel kleiner, spezialisierter Bewertungsmodelle, die Datenschutz, Sicherheit und regulatorische Konformität bewerten, und fassen Sie die Ergebnisse zu einem einzigen Compliance-Score zusammen. Dieser in der aktuellen Forschung zur Compliance-Überwachung zur Laufzeit beschriebene Ansatz „Profil als Jury“ vermeidet das Monokulturrisiko, sich bei der Bewertung einer Ausgabe auf die Selbsteinschätzung eines einzigen Modells zu verlassen.
Technische Checkliste:
- Definieren Sie ein Protokollierungsschema für Prompts, Antworten, abgerufenen Kontext und Modellversion
- Legen Sie Aufbewahrungsrichtlinien fest, die Ihren Datenschutzverpflichtungen entsprechen
- Bauen Sie Eskalations-Hooks ein, die einen Menschen benachrichtigen, wenn KRIs einen Schwellenwert überschreiten
- Integrieren Sie die Bewertung durch ein Prüferpanel oder ein Compliance-Gate direkt in die Bereitstellungspipeline
Wie operationalisieren Sie LLM-Governance im Tagesgeschäft?
Die Operationalisierung von LLM-Governance beginnt mit einer schlanken Struktur, nicht mit einer neuen Abteilung. Die meisten Organisationen benötigen drei Dinge: ein zentrales Governance-Gremium, das Richtlinien und Risikoschwellen festlegt, in jeder Geschäftseinheit verankerte Risikoverantwortliche mit genauer Kenntnis ihrer Anwendungsfälle sowie technische Leitplanken, die direkt in die Bereitstellungspipeline integriert sind.
Das Modell der drei Verteidigungslinien lässt sich gut auf LLMs übertragen:
- Erste Linie: Das Team, das das Modell entwickelt oder bereitstellt, verantwortet das tägliche Risikomanagement einschließlich Modellkarten und erster Tests.
- Zweite Linie: Risiko-, Rechts- und Sicherheitsabteilung prüfen Bereitstellungen anhand der Richtlinie, führen unabhängiges Red-Teaming durch und pflegen die Compliance-Gates.
- Dritte Linie: Die interne Revision prüft regelmäßig, ob die ersten beiden Linien tatsächlich tun, was sie behaupten, und verwendet die Nachweise der Audits auf drei Ebenen als Grundlage.
Ein praktikabler Ablauf sieht so aus:
- Aufnahme: Ein neuer Anwendungsfall wird vor Beginn jeder Entwicklung einer Risikoklasse zugeordnet
- Freigabe: Die risikoverantwortliche Person und die prüfende Person der zweiten Linie genehmigen die Klasse und die erforderlichen Kontrollen
- Bereitstellungs-Checkliste: Die Entwicklung bestätigt, dass Protokollierung, Kontrolle und Ausweichlösung vor dem Start aktiv sind
- Überprüfungen der Überwachung: Wöchentliche oder zweiwöchentliche Prüfung der KRI-Dashboards für Anwendungsfälle der höchsten Risikoklasse
- Vierteljährliches Audit: Koordiniertes Governance-, Modell- und Anwendungsaudit für wesentliche Systeme
Verfolgen Sie kontinuierlich eine kleine Auswahl von KPIs und KRIs: Halluzinationsrate, Bestehensrate des Compliance-Gates, Raten falsch positiver und falsch negativer Ergebnisse bei Inhaltsfiltern sowie die mittlere Zeit bis zur Behebung, sobald ein Problem erkannt wurde. Diese Zahlen sind für einen Vorstand wichtiger als eine narrative Beschreibung Ihres Prozesses, weil sie Trends sichtbar machen.
Checkliste für die erste Einführung:
- Erfassen Sie jedes LLM und jeden Agenten, der sich derzeit in Produktion oder im Pilotbetrieb befindet
- Wählen Sie Überwachungswerkzeuge, bevor Sie Richtlinienwerkzeuge auswählen; was Sie nicht sehen können, können Sie nicht steuern
- Nutzen Sie, wo möglich, Richtlinien als Code, damit Kontrollen automatisch durchgesetzt werden, statt sich auf manuelle Prüfungen zu verlassen
- Legen Sie die Aufbewahrungsdauer für Auditprotokolle vor Ihrem ersten vierteljährlichen Audit fest, nicht danach
Welche Fehler sollten Sie bei der LLM-Governance vermeiden?
Die kostspieligsten Fehler bei der LLM-Governance sind struktureller, nicht technischer Natur. Einige treten immer wieder auf.
Wenn Governance ausschließlich als IT-Problem behandelt wird, bleiben Rechtsabteilung, Produktteam und Vorstand bei Entscheidungen außen vor, die sie treffen sollten. Beheben Sie das, indem Sie im Unternehmen namentlich benannte Risikoverantwortliche festlegen, statt nur eine Ticket-Warteschlange in der Entwicklung zu führen.
Eine übermäßige Abhängigkeit von der Validierung vor der Bereitstellung erzeugt falsches Vertrauen. Ein Modell, das im Januar das Red-Teaming bestanden hat, kann sich bis Juni anders verhalten, wenn sich Prompts, Nutzer und Retrieval-Quellen ändern. Laufzeitüberwachung erkennt das, nicht ein einmaliger Bericht.
Das Monokulturrisiko entsteht, wenn ein einzelnes Modell (oder die Selbsteinschätzung einer einzelnen Modellfamilie) die eigene Konformität bewertet. Prüferpanels mit mehreren Modellen verringern diesen blinden Fleck.
Wer Prompt- und Nutzungsabweichungen ignoriert, bemerkt nicht, wenn die Produktions-Prompts stillschweigend von den getesteten Prompts abweichen. Versionieren und protokollieren Sie Prompts so, wie Sie es mit Code tun würden.
Schwache Verträge mit Drittanbietern setzen Sie einem Risiko aus, wenn ein Anbieter ein Modell ohne vorherige Ankündigung ändert. Verlangen Sie in jeder Anbietervereinbarung Benachrichtigungen über Aktualisierungen und Audit-Rechte.
Wenn Sie Ihrem Führungsteam nur eine Warnung mitgeben, dann diese: Ein bestandenes Audit vor dem Start sagt fast nichts über das Risiko im nächsten Quartal aus.
Wie sollten die ersten 90 Tage Ihrer LLM-Governance aussehen?
Der Aufbau einer LLM-Governance in 90 Tagen ist realistisch, wenn Sie die Schritte richtig staffeln. Alles im ersten Monat erledigen zu wollen, führt dazu, dass Programme ins Stocken geraten.
Tage 1 bis 30:
- Erstellen Sie ein vollständiges Verzeichnis von Modellen und Anwendungsfällen
- Ordnen Sie jeden Anwendungsfall mithilfe einer einfachen Einstufung in hoch/mittel/niedrig einer Risikoklasse zu
- Benennen Sie für jeden Anwendungsfall der höchsten Risikoklasse eine verantwortliche Person
- Richten Sie eine grundlegende Protokollierung für Prompts, Antworten und Modellversion ein
- Definieren Sie für Abläufe mit hohem Risiko eine Notfalllösung (Übergabe an einen Menschen oder Deaktivierung der Funktion)
Tage 31 bis 60:
- Führen Sie API-Gateway-Datenverkehrskontrollen für die Abläufe mit dem höchsten Risiko ein
- Veröffentlichen Sie Modellkarten für jedes Produktionsmodell
- Automatisieren Sie mindestens drei KRIs (Halluzinationsrate, Ablehnungsrate, Latenz)
- Definieren Sie Ihren Audit-Rhythmus und legen Sie fest, wer in den drei Verteidigungslinien sitzt
Tage 61 bis 90:
- Führen Sie eine Red-Team-Übung für Ihren wesentlichsten Anwendungsfall mit dem höchsten Risiko durch
- Schließen Sie ein erstes koordiniertes Audit über Governance-, Modell- und Anwendungsebene ab
- Erstellen Sie einen Vorstandsbericht mit einer Zusammenfassung der Risikoklassen, KRIs und offenen Maßnahmen zur Risikobehebung
Sinnvolle Zielvorgaben sind beispielsweise, dass alle Abläufe mit hohem Risiko innerhalb von zwei Monaten über ein dokumentiertes Runbook verfügen, dass Überschreitungen von Risikoindikatoren umgehend eskaliert werden und dass die Bestehensraten von Compliance-Gates häufig statt nur gelegentlich verfolgt werden.
Die Governance-Infrastruktur selbst entwickeln
Vieles von dem, was dieser Leitfaden beschreibt – das Protokollierungsschema, das Datenverkehrs-Gateway, die Compliance-Gates und die Pipeline für Modellkarten –, ist keine Richtlinienarbeit. Es ist Softwareentwicklung. Und genau dort kommen Governance-Programme meist ins Stocken: Rechts- und Risikoteams können die Richtlinie verfassen, aber jemand muss trotzdem das Gateway bauen, das die Token-Einschränkung durchsetzt, das Dashboard, das KRIs in Echtzeit sichtbar macht, und die Auditspur, die den Fragen einer Aufsichtsbehörde standhält.
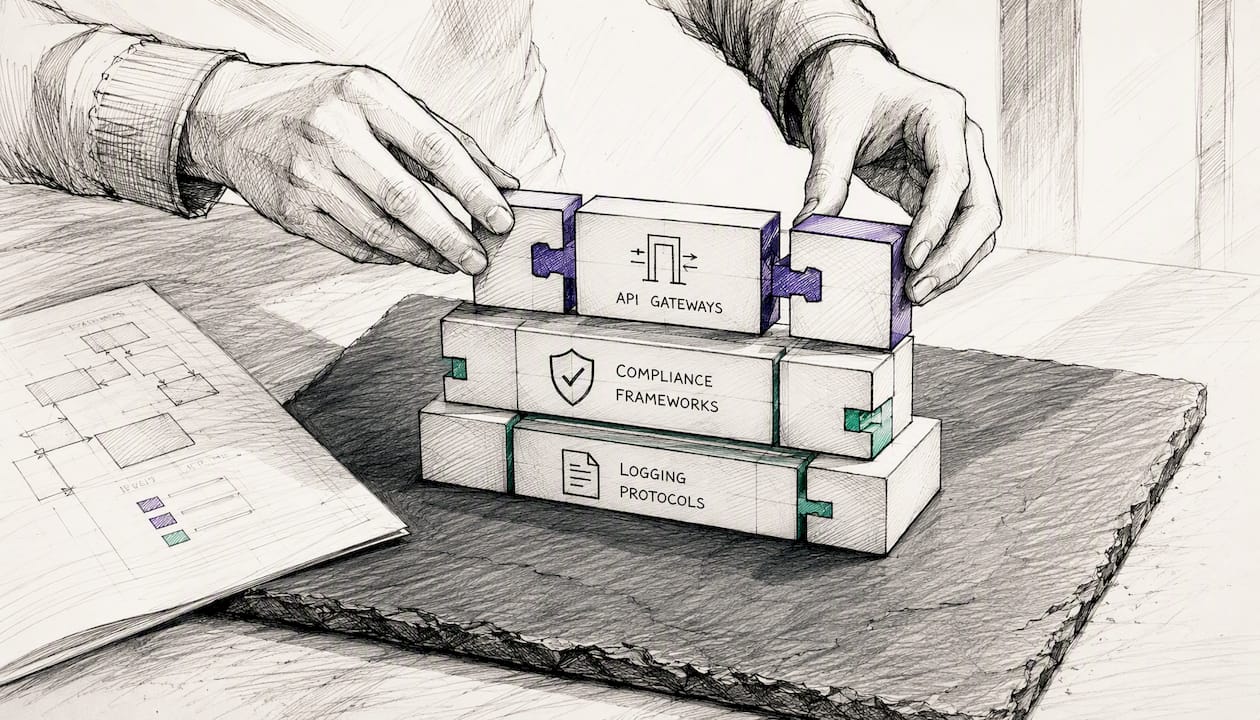
Diese Lücke schließt Ridiculousengineering. Wir entwickeln die Laufzeitinfrastruktur, API-Gateways, Überwachungspipelines, RAG-Härtung und Überwachungsdashboards, die eine LLM-Governance-Richtlinie von einem Dokument in etwas verwandeln, das tatsächlich in der Produktion läuft. Wenn Sie Legacy-Systeme modernisieren, um sicher KI-Funktionen hinzuzufügen, oder kundenspezifische Softwareentwicklung benötigen, um die von Ihrem Governance-Plan geforderte Datenverkehrskontrolle und Protokollierung einzurichten, ist das genau die Art von Projekt, die wir übernehmen. Kontaktieren Sie uns, und wir skizzieren, wie Ihre ersten 90 Tage der technischen Umsetzung tatsächlich aussehen.
Quellen
Einige Quellen sollten Sie als Lesezeichen speichern, wenn Sie dieses Programm weiter ausbauen. Das NIST AI Risk Management Framework ist weiterhin der am flexibelsten einsetzbare Standard, um KI-Risiken in jeder Branche zu erfassen, zu messen und zu steuern. Die Arbeit zur Prüfung auf drei Ebenen bietet die klarste verfügbare Aufschlüsselung von Governance-, Modell- und Anwendungsaudits. Für Compliance zur Laufzeit beschreibt das Governance-from-Metrics-Framework die Bewertung durch Prüferpanels und Compliance-Gates in der Praxis. Das MindForge-Handbuch bietet ein Betriebsmodell für regulierte Branchen, das sich gut über den Finanzbereich hinaus übertragen lässt. Das models-to-metrics framework hilft dabei, Prinzipien in messbare Artefakte zu übersetzen. Und die Untersuchung zum Risikomanagement generativer KI-Modelle liefert die überzeugendsten Argumente für kontinuierliche Überwachung statt statischer Validierung.
- Auditing large language models: a three-layered approach
- Effective generative AI model risk management (finance/insurance review)
- MindForge AI Risk Management Executive Handbook (MAS consortium)
FAQ
Wofür steht LLM?
LLM steht für „Large Language Model“ (großes Sprachmodell), eine Art KI-System, das anhand großer Textdatensätze trainiert wird, um natürliche Sprache zu erzeugen und zu verstehen, darunter Werkzeuge wie ChatGPT und Claude.
Welche vier Governance-Modelle gibt es?
Governance-Frameworks unterscheiden sich je nach Fachgebiet. In der Unternehmens- und IT-Governance werden jedoch häufig vier übergeordnete Modelle genannt: aktionärsorientierte, stakeholderorientierte, hierarchisch/regulatorische sowie Netzwerk- oder Kooperationsmodelle. LLM-Governance übernimmt typischerweise am stärksten Elemente stakeholderorientierter und regulatorischer Ansätze, da rechtliche, sicherheitsbezogene und produktbezogene Interessen zusammenkommen.
Ist ChatGPT ein LLM oder generative KI?
ChatGPT ist beides: Es basiert auf einem großen Sprachmodell (einem LLM) und gehört zur umfassenderen Kategorie der generativen KI, zu der jedes System gehört, das neue Inhalte wie Texte, Bilder oder Code erzeugt.
Wie hoch ist das Gehalt mit einem LLM-Abschluss?
Diese Frage bezieht sich normalerweise auf einen Master of Laws (LL.M.), also einen juristischen Spezialisierungsabschluss, nicht auf ein großes Sprachmodell. Die Gehälter von LL.M.-Absolventen unterscheiden sich je nach Spezialisierung, Land und Kanzlei erheblich. Dieser Artikel behandelt keine Ergebnisse juristischer Ausbildungen.
Wie beginnt man mit LLM-Governance, wenn es bisher kein Programm gibt?
Beginnen Sie mit einem vollständigen Verzeichnis von Modellen und Anwendungsfällen, ordnen Sie jeden Anwendungsfall einer Risikoklasse zu, benennen Sie Verantwortliche und richten Sie eine grundlegende Protokollierung ein, bevor Sie formelle Richtliniendokumente hinzufügen. Die Infrastruktur- und Überwachungsarbeit erfordert häufig einen eigenen technischen Aufwand – hier kann ein Partner wie Ridiculousengineering den Zeitplan beschleunigen.