Klein anfangen: PR-gesteuerte Schema-Prüfungen für CI/CD-Datenpipelines
Klein anfangen: PR-gesteuerte Schema-Prüfungen für CI/CD-Datenpipelines Bei CI/CD für Datenpipelines werden alle Änderungen an Schema und Code durch automatisierte Tests abgesichert, Datenqualitätsprüfungen vor der Bereitstellung ausgeführt und unveränderliche, versionierte Pakete bereitgestellt, die Sie mit einem einzigen Befehl zurückrollen können.
Klein anfangen: PR-gesteuerte Schema-Prüfungen für CI/CD-Datenpipelines
Bei CI/CD für Datenpipelines werden alle Änderungen an Schema und Code durch automatisierte Tests abgesichert, Datenqualitätsprüfungen vor der Bereitstellung ausgeführt und unveränderliche, versionierte Pakete bereitgestellt, die Sie mit einem einzigen Befehl zurückrollen können. Der erste Schritt ist klein: Fügen Sie Pull-Request-gesteuerte Prüfungen der Schemakompatibilität und eine Datenqualitätsschranke hinzu. Diese eine Änderung erkennt die stillen Regressionen, die Dashboards drei Wochen später lahmlegen, und gibt Ihrem Team die Sicherheit, schneller bereitzustellen, statt jede Veröffentlichung zu fürchten.
Kurzfassung:
- Die Implementierung versionierter, unveränderlicher Bereitstellungspakete sowie die Ausführung von Schema- und Datenqualitätsschranken bei Pull Requests reduzieren das Risiko stiller Regressionen erheblich und ermöglichen schnellere, sicherere Veröffentlichungen.
- Tests mit einer stichprobenartigen, anonymisierten Teilmenge von Produktionsdaten sowie Drift-Erkennung und strengen Qualitätsschranken verhindern, dass Probleme wie Nullraten oder Duplikate die Produktion erreichen.
- Stellen Sie Schemaänderungen mithilfe von Shadow-Schemas und Blue-Green-Techniken bereit und führen Sie die Bereitstellung anschließend mit atomaren Umschaltungen durch, um stille Fehler zu vermeiden und einfache Rollbacks über versionierte Pakete zu ermöglichen.
- Ob Sie einen durch CI ausgelösten Pipeline-Orchestrator oder eine native, mit Git synchronisierte Plattform verwenden, hängt von Ihren Anforderungen an die Kontrolle ab; beide Muster unterstützen Test- und Bereitstellungsautomatisierung effektiv.
- Die Validierung nach der Bereitstellung mit Auswirkungsanalyse und Alarmierung gewährleistet die schnelle Erkennung und Behebung von Datenproblemen, die durch neuen Pipeline-Code verursacht werden.
Inhaltsverzeichnis
- Was ist CI/CD für Datenpipelines, und worin unterscheidet es sich?
- Die zentralen Säulen: von der Versionskontrolle bis zur Validierung
- Welche Tools passen tatsächlich zu einem CI/CD-Workflow für Daten?
- Wie testen Sie eine Datenpipeline, bevor sie veröffentlicht wird?
- Wie lässt sich eine Pipelineänderung am sichersten bereitstellen?
- Wie verwalten Sie Testdaten, ohne Ihr Budget zu sprengen?
- Was geschieht nach der Bereitstellung einer Pipeline?
- Wie Ridiculous Engineering einen CI/CD-Rollout angeht
- Praktische Unterstützung beim Aufbau erhalten
- Quellen
- FAQ
Was ist CI/CD für Datenpipelines, und worin unterscheidet es sich?
Software-CI/CD testet zustandslosen Code: Sie führen die Unit-Tests aus, erstellen das Artefakt und stellen es bereit. Datenpipelines sind zustandsbehaftet. Derselbe Code kann jeden Test bestehen und dennoch eine Tabelle beschädigen, wenn sich das vorgelagerte Schema ändert oder ein Quellsystem plötzlich Nullwerte sendet, wo zuvor keine vorkamen. Deshalb beschreiben Leitfäden für Praktiker einen Lebenszyklus in sieben Phasen den Software-CI/CD schlicht nicht benötigt:
- Linting und statische Analyse (PR)
- Prüfungen der Schemakompatibilität (PR)
- Unit-Tests für die Transformationslogik (PR)
- Integrationstests mit Stichprobendaten (Merge)
- Datenqualitätsschranken (Merge)
- Bereitstellung in der Staging-Umgebung und Probelauf (Merge)
- Bereitstellung in der Produktion mit Validierung nach der Bereitstellung (nach dem Merge)
Führen Sie die schnellen, kostengünstigen Prüfungen bei jedem Pull Request aus. Heben Sie die aufwendigen Integrations- und Staging-Schritte für den Merge in den Haupt-Branch auf, damit nicht jeder Commit durch eine zehnminütige Testsuite blockiert wird.
Die zentralen Säulen: von der Versionskontrolle bis zur Validierung
Vier Säulen tragen einen funktionierenden CI/CD-Workflow für Daten: Versionskontrolle, automatisierte Tests, Bereitstellungsautomatisierung und Validierung nach der Bereitstellung. Jede davon entspricht bestimmten CI-Jobs. Entscheidend ist, die Aufteilung zwischen PR und Merge richtig vorzunehmen, damit die Ingenieurinnen und Ingenieure die Pipeline nicht vollständig ignorieren.
- Bei jedem PR: SQL/Python linten, Unit-Tests für die Transformationslogik ausführen und schnelle Schema-Diff-Prüfungen gegen das Ziel-Warehouse durchführen.
- Beim Merge in main: Integrationstests mit einem Stichprobendatensatz ausführen, Data-Quality-Gates anwenden und ein versioniertes Deployment-Bundle erstellen.
- Pfadfilter verwenden damit ein PR, der ausschließlich die Dokumentation betrifft, keine 20-minütige Integrations-Suite auslöst. GitHub Actions und GitLab CI unterstützen dies nativ, und es ist einer der kostengünstigsten Verbesserungshebel im gesamten Setup.
- Unveränderliche Bundles erstellen, statt einzelne Dateien bereitzustellen. Ein an einen Git-Commit-Hash gebundenes Bundle liefert Ihnen ein reproduzierbares Artefakt, das Sie in die Staging-Umgebung und anschließend in die Produktion überführen und bei Problemen auf das Sie zurücksetzen können.
Die Bedeutung versionierter Bundles wird den meisten Teams erst beim ersten fehlerhaften Deployment bewusst. Ohne ein solches Bundle bedeutet „Rollback“, dass jemand um 2 Uhr morgens fünf Dateien manuell zurücksetzt und darauf hofft, die richtige Reihenfolge eingehalten zu haben.
Welche Tools eignen sich tatsächlich für einen Data-CI/CD-Workflow?
In der Praxis dominieren zwei Muster; welches das richtige ist, hängt davon ab, wie viel Kontrolle Sie benötigen und wie viel Glue-Code Sie zu warten bereit sind.
- Muster A: Der CI-Orchestrator löst den Pipeline-Orchestrator aus. GitHub Actions oder GitLab CI führt Ihre Testsuite aus und ruft anschließend Airflow oder Prefect per API auf, um DAGs bereitzustellen. Sie erhalten vollständige Kontrolle über die CI-Logik, müssen aber den Integrationscode zwischen den beiden Systemen selbst verwalten.
- Muster B: Orchestrator mit nativer Git-Synchronisierung. Tools wie Kestra synchronisieren direkt mit Ihrem Git-Repository, wodurch das Deployment zu einem GitOps-Push statt zu einem benutzerdefinierten API-Aufruf wird. Weniger Glue-Code, weniger Flexibilität.
- Wo Tests ausgeführt werden: CI-Runner für Unit-Tests und Linting; ein temporäres, verkleinertes Test-Warehouse für Integrationstests, das pro Lauf erstellt und wieder entfernt wird.
- Secrets und Konfiguration: Variablenersetzung und einen Secrets Manager verwenden, niemals fest codierte Zugangsdaten in einer Pipeline-Definition. Die meisten Cloud-Orchestrierungsplattformen haben dies inzwischen als native Funktion integriert, einschließlich versionierter Bundles und Validierungstools.
Beide Muster funktionieren. Wählen Sie Muster A, wenn Sie Airflow bereits in großem Maßstab betreiben und die CI einfach halten möchten. Wählen Sie Muster B, wenn Sie neu beginnen und weniger bewegliche Teile wünschen.
Wie testen Sie eine Datenpipeline, bevor sie bereitgestellt wird?
Unit-Tests allein reichen nicht aus. Datenpipelines versagen auf eine Weise, die Unit-Tests nicht erkennen können: Ein Quellsystem ändert unbemerkt das Datumsformat, ein Join erzeugt plötzlich Duplikate oder die Nullrate einer Spalte steigt innerhalb eines Monats von 2 % auf 40 %. Um dies zu erkennen, müssen Sie Tests mit Daten durchführen, die wie Produktionsdaten aussehen, nicht mit synthetischen Fixtures.
- Nehmen Sie 1 bis 5 % der Produktionsdaten als Stichprobe und anonymisieren Sie sie, bevor sie eine CI-Umgebung berühren. Praxisleitfäden sehen diesen Bereich übereinstimmend als optimalen Kompromiss zwischen Realitätsnähe und Kosten an.
- Führen Sie bei jedem PR Prüfungen der Abwärtskompatibilität des Schemas durch, damit eine umbenannte oder entfernte Spalte sofort fehlschlägt, bevor sie ein nachgelagertes Dashboard beeinträchtigt.
- Ergänzen Sie Verteilungs- und Qualitätsprüfungen mit einem Tool wie Great Expectations oder Soda: Schwellenwerte für Nullraten, Grenzen für die Kardinalität und Drift-Erkennung gegenüber einer bekannten guten Baseline.
- Behandeln Sie diese Prüfungen als Gates, nicht als Warnungen. Eine fehlgeschlagene Qualitätsprüfung sollte den Merge genauso blockieren wie ein fehlgeschlagener Unit-Test.
Die Belege für diesen Ansatz sind nicht rein theoretischer Natur. Eine in einem PVLDB-Beitrag beschriebene produktive, konfigurationsgesteuerte Testmethodik für YouTubes Data Warehouse erzielte eine Erkennungsrate von 94,5 % für Probleme vor der Produktion, indem umgeschriebene Produktionskonfigurationen statt synthetischer Setups getestet wurden.
Profi-Tipp: Aktualisieren Sie Ihren Stichprobentestdatensatz nach einem festen Zeitplan; wöchentlich funktioniert für die meisten Teams gut, damit Ihre Integrationstests nicht sechs Monate später unbemerkt den Bezug dazu verlieren, wie Produktionsdaten tatsächlich aussehen.
Wie lässt sich eine Pipeline-Änderung am sichersten bereitstellen?
Beim Deployment entsteht der größte Teil des tatsächlichen Schadens, denn eine fehlerhafte Schemaänderung schlägt nicht nur deutlich sichtbar fehl, sondern bleibt in nachgelagerten Systemen häufig unbemerkt. Die Lösung besteht darin, ungetestete Änderungen niemals direkt Produktionsdaten berühren zu lassen.
- Stellen Sie Schemaänderungen zunächst in einer Shadow-Tabelle oder einem Shadow-Schema bereit und führen Sie Ihre vollständige Validierungssuite dagegen aus, ohne dass ein Produktionskonsument darauf zugreift.
- Sobald die Validierung erfolgreich ist, führen Sie einen atomaren Austausch durch, indem Sie das Shadow-Schema in die Produktion umbenennen, oder führen Sie die Änderung über ein Blue/Green-Setup ein, sodass die Umschaltung sofort und für Konsumenten unsichtbar erfolgt.
- Paketieren Sie jedes Release als unveränderliches, versioniertes Bundle. AWS dokumentiert dieses Muster mit nach Phasen isolierten Projekten, die es Ihnen ermöglichen, als separate, wiederholbare Schritte zu bündeln, bereitzustellen, zu testen und zu promoten.
- Halten Sie das vorherige Bundle jederzeit adressierbar. Ein Rollback sollte mit einem einzigen Befehl möglich sein: Promoten Sie das zuletzt als fehlerfrei bekannte Bundle, statt es hektisch rekonstruieren zu müssen.
Das ist dieselbe Logik, die Softwareteams für Blue-Green-Webbereitstellungen verwenden – angewendet auf Schemas und Datasets statt auf Anwendungsserver.
Wie verwalten Sie Testdaten, ohne Ihr Budget zu sprengen?
Realistische Tests kosten Geld und bergen Risiken, wenn Sie bei der Auswahl Ihrer Stichproben nicht sorgfältig vorgehen. Gehen Sie beides bewusst an, statt darauf zu hoffen, dass die Compliance niemals nachfragt.
- Anonymisieren Sie personenbezogene Felder bei der Stichprobenziehung und legen Sie eine Aufbewahrungsfrist für das Stichproben-Dataset fest. Lassen Sie keine sechs Monate alte Kopie von Produktionsdaten vergessen in einem Test-Bucket liegen.
- Aktualisieren Sie die Stichprobe wöchentlich oder in dem Rhythmus, der tatsächlich zur Änderungsrate Ihrer Quelldaten passt.
- Starten Sie für Integrationsläufe kurzlebige, verkleinerte Test-Warehouses statt einer dauerhaft parallel betriebenen Umgebung. Das ist günstiger und zwingt Sie dazu, Ihre Testinfrastruktur per Code reproduzierbar zu halten.
- Verwalten Sie Zugangsdaten über Variablenersetzung und einen Secrets Manager – niemals fest eingebettet in eine Pipeline-Konfigurationsdatei, die anschließend in die Versionsverwaltung gelangt.
Techniken zur Umschreibung von Konfigurationen, bei denen eine Produktionskonfiguration für isolierte Tests angepasst wird, statt die vollständige Infrastruktur zu replizieren, entsprechen genau dem Ansatz der PVLDB-Forscher, mit dem sie eine hohe Testtreue ohne die Kosten eines vollständigen Produktionsklons sicherstellten.
Was passiert nach der Bereitstellung einer Pipeline?
Die Bereitstellung ist nicht das Ziel. Bei der Validierung nach der Bereitstellung erkennen Sie Fehler, die erst auftreten, wenn echte Produktionsdaten durch den neuen Code fließen.
- Führen Sie innerhalb von 30 Minuten nach jeder Bereitstellung Prüfungen auf Aktualität, Volumen und Nullraten durch, bevor jemand nachgelagert einen Bericht auf Basis fehlerhafter Daten erstellt.
- Nutzen Sie eine herkunftsbezogene Impact-Analyse, um einen Fehler zu jeder nachgelagerten Tabelle, jedem Dashboard und jedem Modell zurückzuverfolgen, das davon abhängt, statt ihn erst durch eine verärgerte Slack-Nachricht zu bemerken.
- Legen Sie Alarmgrenzwerte fest, bei denen bei kritischen Fehlern jemand alarmiert wird und für grenzwertige Fälle eine Warnung protokolliert wird, damit Ihre Bereitschaftsingenieurin oder Ihr Bereitschaftsingenieur nicht in einer Flut von Meldungen untergeht.
Dieser herkunftsbezogene Ansatz ist kein nachträglich an das Monitoring angesetztes Nice-to-have. Er ist dieselbe Konfigurations- und Impact-Analysetechnik aus der PVLDB-Produktionsforschung, die nach statt vor der Bereitstellung angewendet wird – und so verkürzen Teams die Reaktionszeit auf Vorfälle von stundenlangem manuellen Nachverfolgen auf wenige Minuten.
Wie Ridiculous Engineering einen CI/CD-Rollout angeht
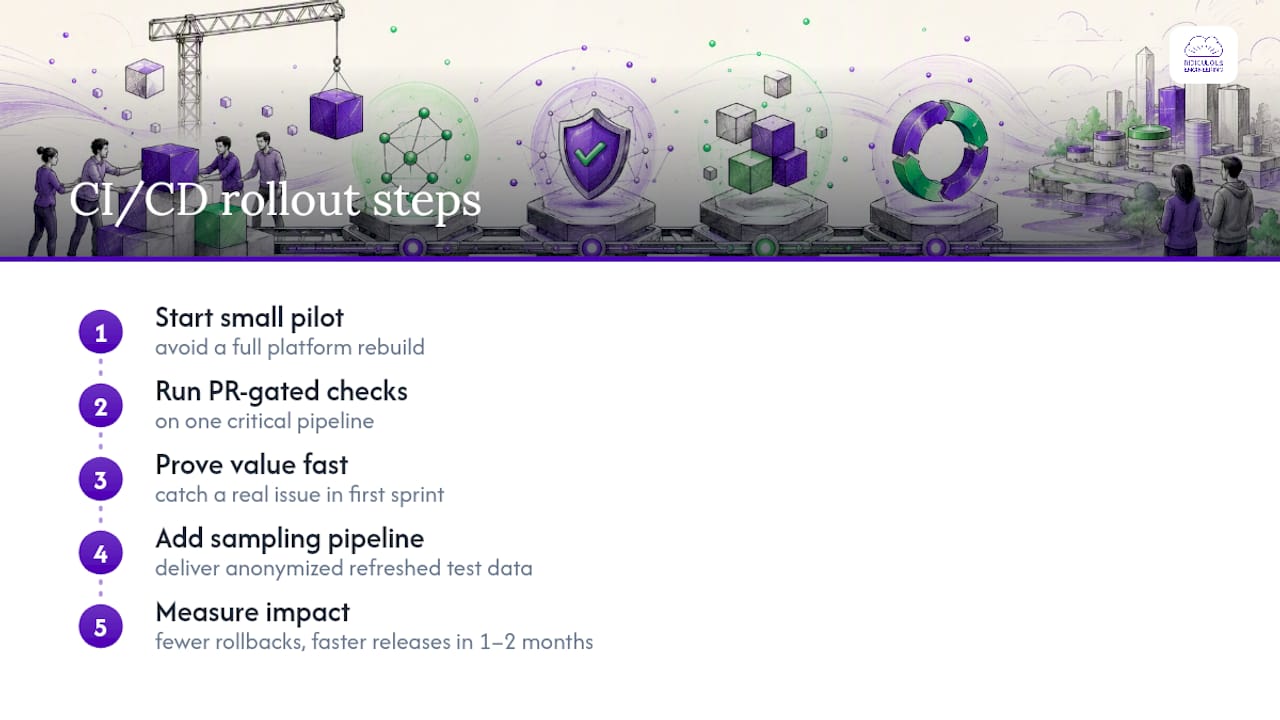
Wir beginnen bei Kundinnen und Kunden nicht mit einem vollständigen Plattformumbau. Wir starten mit einem Schema-Check-Pilotprojekt: Richten Sie PR-gesteuerte Kompatibilitätsprüfungen für eine kritische Pipeline ein, weisen Sie innerhalb des ersten Sprints nach, dass sie tatsächlich etwas erkennt, und erweitern Sie den Ansatz anschließend. In der Regel folgt ein Ergebnis zur Stichprobenpipeline, das Ihrem Team anonymisierte, aktualisierte Testdaten ohne Compliance-Kopfschmerzen liefert.
Viele Unternehmen verzeichnen innerhalb des ersten oder zweiten Monats weniger Rollbacks und einen schnelleren Release-Rhythmus – klar gemessen: Zählen Sie die Vorfälle vorher und nachher. Wir haben in unserem Beitrag zu diesem Thema ausführlicher beschrieben, wie Teams die dafür erforderlichen Analytics-Kompetenzen aufbauen Unternehmen bauen Analytics-Kompetenzen ausund wie automatisierte Gates mit Governance zusammenwirken, in Governance für agentische KI.
Praktische Unterstützung beim Aufbau
Wenn Sie bis hierhin gelesen haben und denken: „Wir brauchen das, aber uns fehlen die Kapazitäten“, kann eine spezialisierte Beratung diese Lücke schließen. Während Ihnen eine traditionelle Agentur möglicherweise eine Präsentation und eine Roadmap übergibt, kann ein praxisorientierter Partner die Schema-Checks, die Stichprobenpipeline und die Bereitstellungs-Gates direkt in Ihren Stack integrieren und Ihnen anschließend ein System übergeben, das Ihre eigenen Ingenieurinnen und Ingenieure warten können. Unsere Datenanalyse und Business Intelligence deckt genau die in diesem Artikel beschriebenen Muster für Pipelin tests und -validierung ab, und unser Team für Softwareberatung und Unterstützung bei der Bereitstellung kann einen klar abgegrenzten Piloten durchführen, ohne von Ihnen eine einjährige Zusammenarbeit zu verlangen. Für Teams, die abwägen, ob sie dies intern entwickeln oder Unterstützung für die Automatisierungsschicht rund um ihre Pipelines hinzuziehen sollten, ist ein Partner wie Stratton Media Solutions auch für die operative Seite einen Blick wert.
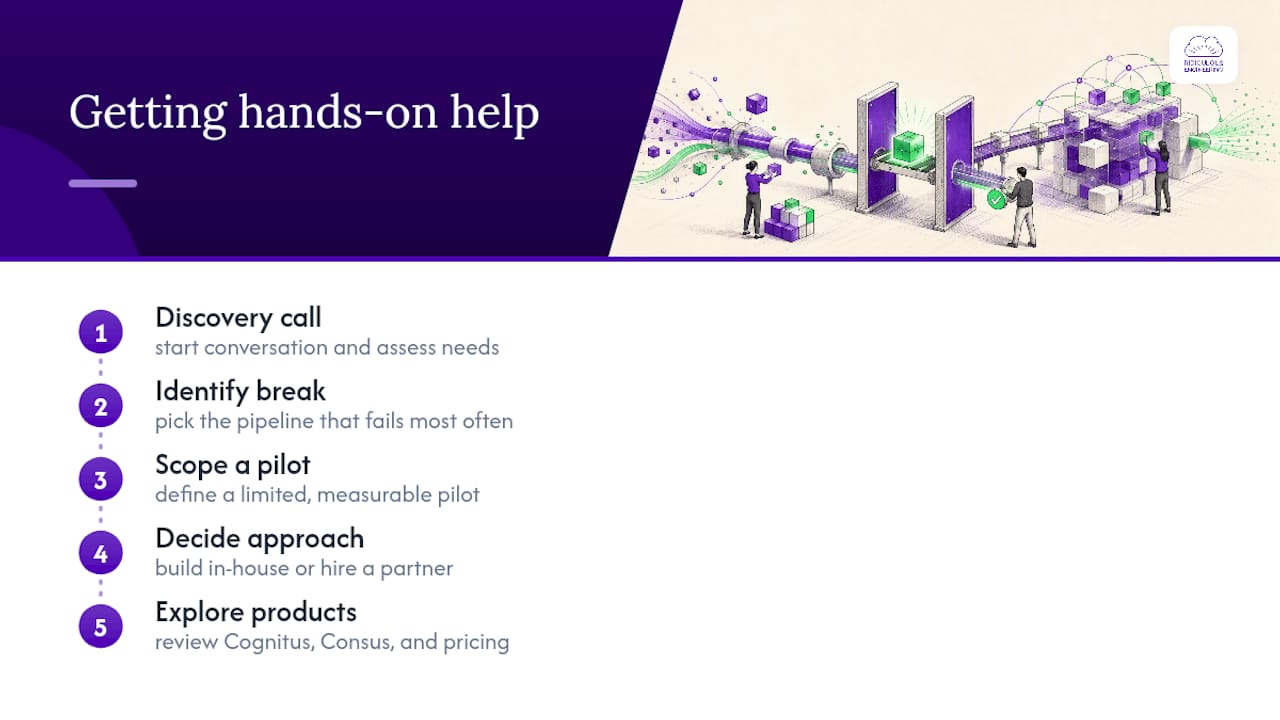
Beginnen Sie mit einem Erstgespräch. Ermitteln Sie, welche Pipeline am häufigsten ausfällt, und grenzen Sie darum einen Piloten ab. Wenn Sie zunächst Produktoptionen prüfen möchten, sind unsere Cognitus und Consus Angebote sowie die Consus-Preisseite ein guter Ausgangspunkt, um zu sehen, was bereits entwickelt wurde.
Quellen
- CI/CD für Datenpipelines: Der Leitfaden für den Produktionseinsatz | AI-DE
- Übersicht über Cloud-Orchestrierungs-Pipelines (Google Cloud)
- Automatisieren Sie die Bereitstellung von Daten- und KI-Anwendungen mit der Amazon SageMaker Unified Studio CI/CD-CLI | AWS Big Data Blog
FAQ
Welches CI/CD-Pipeline-Tool ist für Datenteams am besten geeignet?
Es gibt nicht das eine beste Tool. Es hängt davon ab, ob Sie einen CI-Orchestrator verwenden möchten, der einen separaten Pipeline-Orchestrator wie Airflow oder Prefect auslöst, oder eine Plattform wie Kestra mit integrierter nativer Git-Synchronisierung. Teams, die Airflow bereits im großen Maßstab einsetzen, bleiben meist bei GitHub Actions oder GitLab CI als Auslöseschicht; Teams, die neu beginnen, bevorzugen oft weniger bewegliche Teile.
Was genau sind CI/CD-Pipelines?
Eine CI/CD-Pipeline ist eine automatisierte Abfolge, die Codeänderungen testet, validiert und bereitstellt, ohne dass bei jedem Schritt ein manueller Eingriff erforderlich ist. Für Daten umfasst diese Abfolge zusätzlich Prüfungen der Schemakompatibilität, Datenqualitäts-Gates und eine Validierung nach der Bereitstellung, die eine standardmäßige Softwarepipeline nicht benötigt.
Ist Jira ein CI/CD-Pipeline-Tool?
Nein. Jira ist ein Tool zur Nachverfolgung von Vorgängen und für das Projektmanagement, kein CI/CD-Pipeline-Tool. Es kann mit Tickets verknüpft werden, die über Integrationen Bereitstellungen auslösen. Die eigentliche Automatisierung von Tests, Builds und Bereitstellungen läuft jedoch über Tools wie GitHub Actions, GitLab CI oder eine Orchestrierungs-Engine – nicht über Jira selbst.
Ist die Implementierung von CI/CD für Datenpipelines schwierig?
Sie ist aufwendiger als Software-CI/CD, da Daten zustandsbehaftet sind und statt statischer Test-Fixtures Stichprobendaten in anonymisierter Form erfordern. Die meisten Teams stellen fest, dass der Schwierigkeitsgrad deutlich sinkt, sobald sie klein anfangen – mit Schemaprüfungen und einem Qualitäts-Gate –, anstatt bereits am ersten Tag den vollständigen Lebenszyklus in sieben Stufen aufzubauen. Ridiculousengineering plant ein erstes Pilotprojekt typischerweise rund um eine einzelne Pipeline, um den Ansatz zu validieren, bevor er erweitert wird.