Migrazione del data warehouse: una guida pratica per i responsabili IT
Migrazione del data warehouse: una guida pratica per i responsabili IT Usa una migrazione basata su fasi con una strategia ibrida: ripiattaforma le tabelle critiche per la produzione, riprogetta quelle in cui il debito tecnico ostacola la scalabilità ed esegui il lift-and-shift solo per le risorse consultate raramente o prossime al ritiro.
Migrazione del data warehouse: una guida pratica per i responsabili IT
Usa una migrazione basata su fasi con una strategia ibrida: ripiattaforma le tabelle critiche per la produzione, riprogetta quelle in cui il debito tecnico ostacola la scalabilità ed esegui il lift-and-shift solo per le risorse consultate raramente o prossime al ritiro. La cosa più importante che puoi fare questa settimana è assegnare un responsabile e condurre un audit mirato di analisi, catalogando le principali tabelle di produzione e i principali utilizzatori a valle. Se salti questo passaggio, emergeranno subito due rischi: dipendenze non documentate che interrompono i report a valle il giorno del cutover e anni di debito tecnico accumulato che pagherai per ospitare nel cloud a un costo per query superiore a quello sostenuto on-premises.
Se preferisci affidare questo audit a un team esperto, Ridiculous Engineering offre incarichi di valutazione strutturati, progettati per trasformare i dati dell'analisi in una roadmap della migrazione prioritaria.
Sommario
-
Come si presenta una migrazione del data warehouse fase per fase?
-
Come si esegue l'audit del data warehouse prima dell'inizio della migrazione?
-
Quali scelte di progettazione e modellazione sono più importanti sulla piattaforma di destinazione?
-
Come si spostano i dati e si convertono le pipeline durante l'esecuzione?
-
Come si convalidano i dati e si pianifica un cutover sicuro?
-
Quali categorie di strumenti dovresti valutare per la tua migrazione?
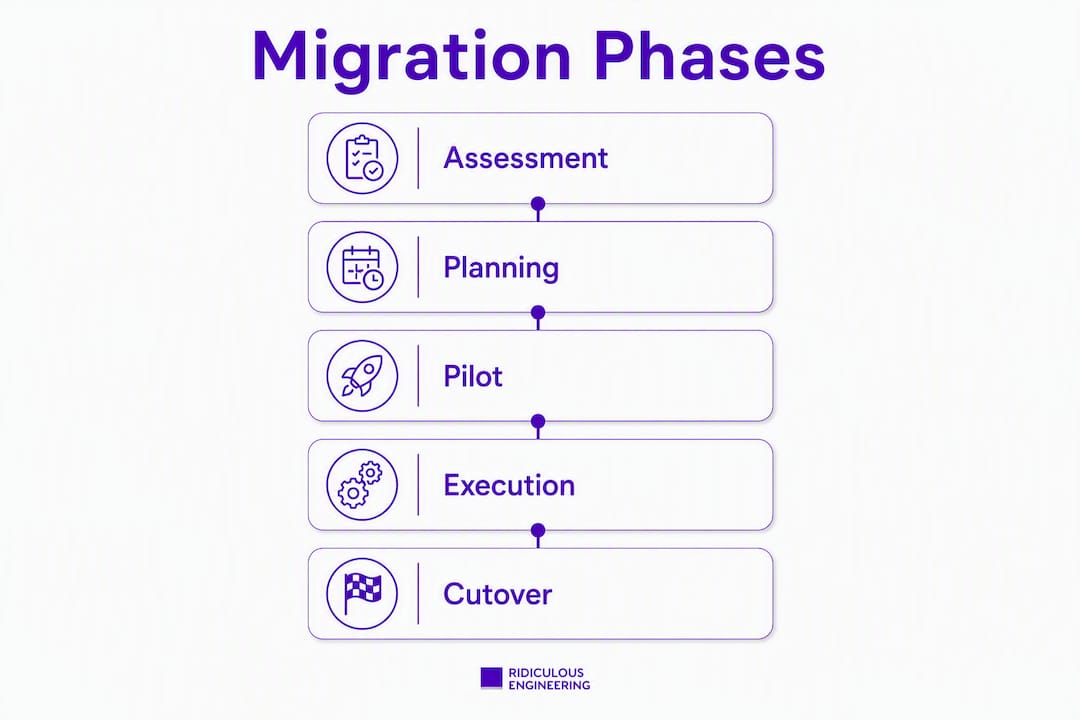
Come si presenta una migrazione del data warehouse fase per fase?
Le migrazioni di maggior successo adottano un approccio ibrido anziché un'unica strategia, e questo approccio ibrido funziona solo quando ogni fase ha una condizione di ingresso chiara e un deliverable definito. Le sei fasi seguenti costituiscono il framework di riferimento.
-
Valutazione — Deliverable: inventario dei sistemi, mappa dei flussi di dati, matrice delle dipendenze e registro dei rischi. Il successo significa sapere cosa viene eseguito in produzione e cosa no.
-
Pianificazione — Deliverable: roadmap della migrazione con flussi di lavoro prioritari, assegnazioni al team e scorecard go/no-go per ogni risorsa. Il successo significa che ogni stakeholder ha approvato l'ambito.
-
Progettazione — Deliverable: progettazione degli schemi di destinazione, convenzioni di denominazione, modello di sicurezza e strategia di materializzazione. Il successo significa che la piattaforma di destinazione è progettata in base alle proprie caratteristiche, non copiata dal sistema legacy.
-
Esecuzione — Deliverable: dati migrati, pipeline ETL/ELT convertite e ambiente parallelo operativo. Il successo significa che origine e destinazione sono riconciliate e sincronizzate.
-
Test e cutover — Deliverable: report di validazione, confronti KPI approvati e piano di cutover firmato con trigger di rollback. Il successo significa che gli utenti aziendali hanno approvato la parità dei dati.
-
Ottimizzazione post-migrazione — Deliverable: registro dell'ottimizzazione delle query, baseline per la governance dei costi, dashboard di osservabilità e runbook operativi. Il successo significa che la nuova piattaforma offre prestazioni migliori rispetto al sistema legacy, non soltanto prestazioni diverse.
Punti decisionali tra le fasi:passa dalla valutazione alla pianificazione solo quando l'inventario è completo e il registro dei rischi è stato esaminato. Passa dalla pianificazione alla progettazione solo quando l'ambito è definito e la strategia di migrazione (lift-and-shift, replatform o redesign) è assegnata per ogni asset. Passa dall'esecuzione ai test solo quando gli ambienti paralleli sono operativi e la riconciliazione iniziale ha esito positivo. Passa dai test al cutover solo quando i criteri di accettazione sono soddisfatti e un piano di rollback è documentato.
Un progetto pilota mirato, limitato a un singolo dominio, a una pipeline ETL rappresentativa e a un carico di lavoro di reporting, è il modo giusto per convalidare strumenti e approccio prima di impegnarsi in un'implementazione completa.
Come si esegue l'audit del data warehouse prima dell'inizio della migrazione?
La valutazione è la fase in cui la maggior parte dei team investe troppo poco, ed è quella che determina il successo del resto del progetto. Una discovery incompleta porta direttamente alla migrazione di asset inutilizzati e a costi cloud gonfiati. Considera questa fase un'opportunità per eliminare l'eccesso, non per replicarlo.
Checklist dell'inventario
Per ogni tabella o dataset, raccogli:
-
Nome dello schema, nome della tabella e proprietario
-
Numero di righe e dimensione approssimativa dello storage
-
Strategia di partizionamento e indicizzazione
-
Cadenza di aggiornamento e SLA di freschezza dei dati
-
Frequenza delle query (ricavala dai log delle query, non da supposizioni)
-
Query con il maggior consumo in base al costo computazionale
-
Durata di esecuzione e tasso di errore dell'ETL
-
Report, dashboard e API downstream che dipendono da questa tabella
-
Valutazione della criticità aziendale assegnata dal team responsabile
Tecniche di discovery
-
Catalogazione automatizzata: strumenti come Apache Atlas o i servizi di catalogazione nativi del cloud possono analizzare gli schemi e rendere automaticamente visibile la lineage. Inizia da qui prima di qualsiasi attività manuale.
-
Analisi dei log delle query: esporta la cronologia delle query relativa a diverse settimane per identificare quali tabelle vengono effettivamente lette in produzione rispetto a quelle che esistono solo nella documentazione.
-
Tracciamento delle dipendenze: mappa le relazioni tra chiavi esterne, le definizioni delle viste e i riferimenti alle stored procedure per creare un grafo delle dipendenze.
-
Interviste agli stakeholder: i responsabili BI, gli analisti dei dati e i proprietari delle applicazioni conoscono comportamenti di produzione non documentati che nessuno strumento di catalogazione riuscirà a rilevare.
Metriche da raccogliere per ogni asset
Raccogli il numero di righe, la frequenza delle query, le query con il maggior consumo, la durata di esecuzione dell'ETL, il costo per query e le finestre di freschezza dei dati. Queste metriche confluiscono direttamente nella griglia di valutazione descritta più avanti in questa guida.
Suggerimento: Automatizza l'estrazione iniziale dell'inventario utilizzando le viste dello schema informativo del tuo data warehouse (ad esempio, INFORMATION_SCHEMA.TABLES, INFORMATION_SCHEMA.COLUMNS) e le tabelle della cronologia delle query. Esporta i dati in un foglio di calcolo o in uno strumento di catalogazione, quindi aggiungi le valutazioni manuali della criticità aziendale ricavate dalle interviste agli stakeholder. Questo approccio ibrido riduce significativamente i tempi dell'inventario rispetto a una catalogazione completamente manuale.
I deliverable di questa fase sono: un inventario dei sistemi, una mappa dei flussi di dati, una matrice delle dipendenze, un registro dei rischi e una scorecard di fattibilità. È la scorecard a guidare le decisioni tra lift-and-shift, replatform e redesign.
Quali scelte di progettazione e modellazione contano maggiormente sulla piattaforma di destinazione?
L'errore di progettazione più comune in una migrazione di data warehouse consiste nel copiare lo schema legacy sulla piattaforma di destinazione senza considerare il modo in cui quella piattaforma addebita i costi di calcolo e storage. La progettazione specifica per la piattaforma implica il partizionamento e il clustering per motori serverless come le piattaforme in stile BigQuery, oltre alla scelta accurata delle chiavi di distribuzione per i cloud in stile MPP. Le chiavi di distribuzione legacy raramente si traducono bene.
Pattern di modellazione
-
Architettura medallion (bronzo/argento/oro): ingestione dei dati grezzi nel bronzo, dati ripuliti e conformati nell'argento, aggregati pronti per il business nell'oro. Questo pattern funziona bene per i lakehouse cloud e rende trasparente la lineage.
-
Livelli dimensionali rispetto ai livelli raw: mantieni un livello raw per la verificabilità e costruisci dimensioni conformate al di sopra. Evita di accorpare questi livelli in un unico livello durante la migrazione.
-
Scelte di denormalizzazione: i data warehouse cloud con archiviazione colonnare spesso traggono vantaggio da tabelle più ampie e denormalizzate. Valuta la frequenza dei join e i modelli di interrogazione prima di decidere.
-
Tipi di colonne e campi annidati: usa i tipi nativi array e struct quando la piattaforma li supporta per ridurre l'overhead dei join, ma solo quando i sistemi downstream sono in grado di gestire la struttura.
Strategia di materializzazione
-
Usa viste per trasformazioni leggere eseguite raramente o quando l'aggiornamento dei dati è fondamentale.
-
Usa viste materializzate per aggregazioni interrogate ripetutamente su grandi dataset.
-
Usa tabelle aggregate (precalcolate) per dashboard con SLA di latenza rigorosi.
-
Il calcolo in lettura è più economico per le query a bassa frequenza; precarica i risultati per quelle ad alta frequenza.
Checklist di sicurezza e governance
-
Definisci il controllo degli accessi basato sui ruoli a livello di schema e tabella prima della migrazione, non dopo.
-
Classifica i dati in base alla sensibilità (PII, PHI, riservati, pubblici) e applica il mascheramento a livello di colonna dove richiesto.
-
Crittografa i dati a riposo e in transito; verifica le impostazioni di crittografia predefinite della piattaforma di destinazione.
-
Stabilisci il tracciamento della derivazione dei dati dall'acquisizione, passando per la trasformazione, fino alla reportistica.
-
Documenta la strategia di evoluzione dello schema: solo le modifiche additive (nuove colonne, nuove tabelle) sono compatibili con le versioni precedenti; la ridenominazione delle colonne e le modifiche dei tipi non lo sono.
Le convenzioni di denominazione contano più di quanto i team si aspettino. Concorda su uno standard (snake_case, prefisso per livello, suffisso per tipo di materializzazione) prima dell'inizio dell'esecuzione e applicalo nella revisione del codice.
Come si spostano i dati e si convertono le pipeline durante l'esecuzione?
È durante l'esecuzione che i piani incontrano la realtà. L'obiettivo è spostare i dati in modo affidabile, convertire accuratamente la logica ETL/ELT e mantenere sincronizzati origine e destinazione abbastanza a lungo da convalidare la parità prima del passaggio.
Modelli di spostamento dei dati
-
Caricamento completo dello storico: estrai l'intero dataset una sola volta. Usalo per tabelle statiche o aggiornate raramente. È semplice, ma crea un'istantanea temporale che diverge immediatamente se la sorgente è attiva.
-
Sincronizzazione incrementale: estrai solo i record modificati dall'ultima esecuzione utilizzando una colonna watermark (ad es.
updated_at). È più veloce dei caricamenti completi, ma richiede un indicatore affidabile delle modifiche nella sorgente. -
Change data capture (CDC): Il CDC abilita la replica quasi in tempo reale leggendo il log delle transazioni del sistema sorgente. Riduce al minimo le finestre di passaggio rispetto ai metodi basati esclusivamente sul caricamento in blocco ed è la scelta giusta per le sorgenti transazionali attive.
Migrazione del codice
I traduttori SQL automatizzati gestiscono le differenze tra dialetti (ad es. da Teradata SQL a BigQuery SQL, da Oracle a Snowflake) più velocemente e in modo più coerente delle riscritture manuali per il DML standard. Tuttavia, le stored procedure con flussi di controllo complessi, funzioni specifiche del fornitore e SQL dinamico richiedono generalmente un refactoring manuale. Prevedi esplicitamente tempo per queste attività: è qui che i progetti subiscono ritardi.
L'automazione gestisce la deriva dello schema e le attività di traduzione ripetitive in modo più affidabile degli script scritti manualmente, migliorando l'affidabilità del passaggio. Usa connettori e traduttori maturi per il lavoro ripetibile e riserva tempo ingegneristico alla logica che richiede realmente il giudizio umano.
Orchestrazione ed esecuzioni parallele
-
Crea pipeline idempotenti: ogni esecuzione deve produrre lo stesso risultato indipendentemente dal numero di volte in cui viene eseguita. Questo rende sicuri i tentativi di riesecuzione.
-
Implementa la logica dei tentativi con backoff esponenziale per gli errori transitori.
-
Esegui le pipeline di origine e destinazione in parallelo durante l'esecuzione, in modo che la riconciliazione possa avvenire continuamente, non solo al momento del passaggio.
-
Monitora la telemetria della pipeline (conteggio delle righe, latenza, tassi di errore) fin dal primo giorno di esecuzione, non solo durante la finestra di convalida.
Collegare fonti legacy a destinazioni moderne richiede un'attenta pianificazione della compatibilità dei connettori, soprattutto quando i sistemi di origine sono on-premises e le destinazioni sono cloud-native.
Come si convalidano i dati e si pianifica un passaggio sicuro?
È durante la convalida che i team scoprono che la corrispondenza del conteggio delle righe è necessaria, ma ben lontana dall'essere sufficiente. I conteggi delle righe rilevano solo i problemi più evidenti; le esecuzioni parallele e la convalida da parte degli utenti aziendali fanno emergere gli errori di logica e semantici.
Passaggi di convalida
-
Controlli strutturali: verifica che tutte le tabelle, le colonne, i tipi di dati e i vincoli esistano nella destinazione.
-
Riconciliazione del conteggio delle righe: confronta il conteggio delle righe per tabella tra origine e destinazione.
-
Confronti di checksum e hash: calcola i checksum sulle colonne chiave per rilevare il danneggiamento silenzioso dei dati.
-
Confronti degli aggregati: confronta SUM, COUNT, AVG, MIN e MAX per le metriche critiche su finestre temporali corrispondenti.
-
Riconciliazione dei KPI: esegui gli stessi report aziendali su entrambi i sistemi e confronta i risultati.
-
Verifica di record campione: controlla a campione i singoli record in più tabelle, soprattutto per quelle con trasformazioni complesse.
-
Benchmark delle prestazioni delle query: esegui le 20 query di produzione principali sulla destinazione e confronta i tempi di esecuzione con la baseline dell'origine.
Criteri di accettazione
Definiscili prima dell'inizio dell'esecuzione, non durante la finestra di convalida:
-
Soglia di parità dei dati (ad es., valori aggregati entro lo 0,01% rispetto all'origine)
-
SLA delle prestazioni delle query (ad es., tempo di query P95 entro il 20% rispetto alla baseline dell'origine)
-
Nessuna discrepanza critica nei KPI
-
Approvazione da parte degli utenti aziendali di almeno un responsabile per dominio
Opzioni di passaggio
| Strategia | Descrizione | Complessità del rollback | Caso d'uso tipico |
|---|---|---|---|
| Esecuzione parallela | Entrambi i sistemi sono attivi; il traffico viene spostato gradualmente | Bassa — reindirizza il traffico all'origine | La maggior parte delle migrazioni; impostazione predefinita consigliata |
| Blue/green | Passaggio completo a un orario programmato; l'origine resta attiva | Media — ripristina DNS/le connessioni | Ambienti ben testati e a rischio ridotto |
| Per dominio, in fasi | Esegui il cutover di un dominio aziendale alla volta | Basso per dominio | Grande EDW aziendale con domini indipendenti |
| Big bang | Un unico evento di cutover; la sorgente viene dismessa immediatamente | Elevato — nessun fallback | Dataset di piccole dimensioni; raramente consigliato |
Riserva una finestra di più giorni per la riconciliazione finale dell'esecuzione parallela e i controlli di integrità prima di dismettere il sistema legacy. I team sottovalutano sistematicamente questa finestra e il costo di estenderla è molto inferiore al costo di dover eseguire il rollback dopo una dismissione prematura.
Piano di comunicazione del cutover: assegna un responsabile nominativo per ogni passaggio, documenta i criteri di rollback (ad esempio, discrepanza del KPI oltre la soglia, tasso di errore della pipeline superiore a X%) e distribuisci il piano a tutti gli stakeholder almeno 48 ore prima dell'apertura della finestra di cutover.
Cosa succede dopo il cutover e perché è importante?
L'ottimizzazione post-migrazione è una fase pianificata, non un ripensamento. Un data warehouse migrato che non è stato ottimizzato per il nuovo ambiente è spesso più lento e costoso del sistema legacy che ha sostituito: una situazione difficile da spiegare alla leadership.
Attività di ottimizzazione e manutenzione
-
Esegui il profiling delle query sulle query di produzione ad alto impatto e individua scansioni complete delle tabelle, chiavi di clustering mancanti e pattern di join inefficienti.
-
Ottimizza il partizionamento e il clustering in base ai pattern di query effettivamente osservati dopo la migrazione, non alle ipotesi precedenti alla migrazione.
-
Esegui processi di vacuum e compattazione sulle tabelle con elevati tassi di aggiornamento o eliminazione.
-
Pulisci gli oggetti migrati che erano stati contrassegnati come a bassa priorità durante la valutazione, ma che sono stati comunque trasferiti.
Governance dei costi
Senza una riprogettazione, i pattern di query legacy e i join non necessari fanno aumentare i costi di elaborazione nei data warehouse cloud in cui l'elaborazione viene addebitata per query. Controlli chiave:
-
Imposta policy del ciclo di vita dello storage per spostare automaticamente i dati freddi verso livelli più economici.
-
Implementa la memorizzazione nella cache dei risultati delle query, laddove supportata dalla piattaforma.
-
Monitora i costi di egress se i consumatori delle tue analisi si trovano in una regione cloud o presso un provider diverso.
-
Imposta avvisi di budget all'80% e al 100% del budget mensile di elaborazione.
Osservabilità
-
Strumenta le pipeline con metriche sul numero di righe, sulla latenza e sul tasso di errore fin dal primo giorno.
-
Definisci SLI e SLO per l'aggiornamento dei dati (ad esempio, “il livello silver viene aggiornato entro 30 minuti dal commit della sorgente”) e per la latenza delle query.
-
Configura il rilevamento delle anomalie sulle metriche chiave, in modo che i guasti silenziosi emergano prima che gli utenti aziendali se ne accorgano.
Per i team che si stanno espandendo verso architetture cloud-native, l'ottimizzazione post-migrazione è anche il momento giusto per valutare se l'attuale modello di dati supporta i carichi di lavoro di AI/ML che l'azienda intende eseguire in seguito.
Quali categorie di strumenti dovresti valutare per la tua migrazione?
Scegliere gli strumenti prima di comprendere i requisiti specifici della migrazione è uno degli errori più costosi che un team possa commettere. Valuta in base alle capacità e all'adeguatezza, non al riconoscimento del marchio.
Categorie di strumenti da valutare
-
Connettori e piattaforme CDC: verifica il supporto nativo per il sistema sorgente, la gestione della deriva dello schema e l'acquisizione idempotente. Conferma che il connettore supporti la modalità di replica richiesta (completa, incrementale, CDC).
-
Framework ETL/ELT e di trasformazione: valuta la copertura della traduzione SQL automatizzata per il dialetto sorgente, il supporto per trasformazioni modulari in stile dbt e la capacità di gestire la migrazione delle stored procedure.
-
Piattaforme di orchestrazione:valutare la semantica dei nuovi tentativi, la gestione delle dipendenze, gli avvisi e l’integrazione con gli strumenti CI/CD esistenti.
-
Strumenti di catalogazione e lineage:verifica che possano analizzare automaticamente gli schemi di origine e destinazione e mostrare il lineage a livello di colonna.
-
Strumenti di test e convalida:cerca funzionalità integrate per il confronto degli aggregati, la riconciliazione del numero di righe e la possibilità di definire criteri di accettazione personalizzati.
Elenco di controllo delle funzionalità per qualsiasi strumento in fase di valutazione
-
Rilevamento e gestione automatica della deriva dello schema
-
Traduzione SQL automatizzata con report sulla copertura
-
Acquisizione idempotente (nuovi tentativi sicuri)
-
Supporto per il rollback o il riavvolgimento
-
Monitoraggio e avvisi integrati
-
Integrazione cloud-native con la piattaforma di destinazione
Indicazioni per il progetto pilota
Limita il progetto pilota a un dominio aziendale, una pipeline ETL rappresentativa e un carico di lavoro di reporting. Definisci i criteri di uscita prima dell’avvio del progetto pilota: throughput minimo, tasso di errore massimo e riconciliazione corretta dei KPI. Un progetto pilota privo di criteri di uscita è solo una prova di concetto che non finisce mai.
Una gestione oculata dei costi durante la fase pilota, incluso il monitoraggio fin dal primo giorno del consumo di spazio di archiviazione e risorse di calcolo, evita che sorprese sui costi si accumulino fino a compromettere la migrazione completa.
Quali sono gli errori più comuni commessi dai team?
La maggior parte dei fallimenti delle migrazioni è prevedibile. Gli stessi schemi si ripetono in progetti di qualsiasi dimensione.
Elenco di controllo preventivo
-
Congela l’ambito dopo la fase di pianificazione. Le modifiche all’ambito della migrazione durante l’esecuzione sono la principale fonte di sforamenti delle tempistiche.
-
Verifica tutte le dipendenze downstream prima dell’inizio dell’esecuzione, non durante la finestra di convalida.
-
Pianifica esecuzioni parallele per ogni dominio di produzione, non solo per quelli di cui sei più sicuro.
-
Pianifica una finestra di convalida di almeno 48 ore dopo il cutover prima di dismettere il sistema legacy.
-
Assegna un responsabile nominativo a ogni tabella dell’inventario. Gli asset senza responsabile diventano blocchi.
-
Documenta i trigger di rollback e testa la procedura di rollback prima dell’apertura della finestra di cutover.
Problemi comuni e misure di mitigazione
-
Migrazione del debito tecnico:i team replicano gli schemi legacy senza valutare se i modelli sottostanti soddisfino ancora le esigenze aziendali. Mitigazione: usa la griglia di valutazione dell’assessment per segnalare gli asset con debito elevato e riprogettarli invece di eseguire un semplice lift-and-shift.
-
Sottovalutazione del tempo per la convalida del cutover:il minimo di 48 ore è una soglia minima, non un obiettivo. Gli ambienti complessi con molti consumer downstream richiedono più tempo. Mitigazione: aggiungi un margine di convalida al piano di progetto durante la pianificazione, non durante l’esecuzione.
-
Dipendenze downstream mancanti:una tabella che sembra inutilizzata nei log delle query potrebbe essere letta da un processo batch mensile eseguito l’ultima volta sei settimane fa. Mitigazione: estendi l’analisi dei log delle query ad almeno 90 giorni e conduci interviste con gli stakeholder.
-
Ignorare la governance dei costi:i team si concentrano sulla parità dei dati e ignorano i costi di calcolo finché non arriva la prima fattura cloud. Mitigazione: imposta avvisi sul budget e rivedi settimanalmente i dashboard dei costi fin dal primo giorno di esecuzione.
-
Saltare la gestione del cambiamento:gli utenti finali che non vengono informati sulle tempistiche del cutover e sui piani di formazione aggireranno il nuovo sistema o segnaleranno problemi di qualità dei dati che in realtà dipendono dalla scarsa familiarità. Mitigazione: includi un piano di comunicazione per gli stakeholder nel piano di progetto fin dal primo giorno.
Quanto dura una migrazione e quanto costa?
Tempistiche e budget variano più di quanto ammettano la maggior parte delle guide. La risposta onesta dipende dal volume dei dati, dalla complessità delle trasformazioni, dalle dipendenze a valle e da quanto debito tecnico si sceglie di affrontare invece di trasferirlo.
Tempistiche esemplificative
-
Piccola migrazione (singolo dominio, pipeline limitate): Le piccole migrazioni possono essere completate in 4–6 settimane. È il caso tipico di una singola unità aziendale che trasferisce un dataset ben documentato con pochi consumer a valle.
-
Media migrazione (più domini, complessità moderata): I progetti di media complessità durano in genere 12–24 settimane. È il caso tipico di un’organizzazione di medie dimensioni che consolida diversi sistemi sorgente in un data warehouse cloud.
-
Modernizzazione di un EDW enterprise: Le modernizzazioni enterprise possono durare da 8 a 50 settimane, a seconda del volume dei dati, della complessità delle integrazioni e delle dipendenze a valle. Prevedi un margine di riserva negli ambienti complessi.
Ruoli da coprire nel team
-
Responsabile del progetto: responsabile dell’ambito, delle tempistiche e della comunicazione con gli stakeholder
-
Responsabile data engineering: responsabile della conversione delle pipeline, dell’implementazione del CDC e dell’esecuzione
-
Responsabile piattaforma/infrastruttura: responsabile della configurazione della piattaforma target, della sicurezza e della governance dei costi
-
Responsabile QA/validazione: responsabile dei criteri di accettazione, degli script di validazione e dell’approvazione del cutover
-
Responsabile BI/prodotto: rappresenta i consumer a valle e approva la riconciliazione dei KPI
-
Responsabile del cambiamento: responsabile della formazione, della documentazione e della comunicazione agli utenti finali
Fattori di costo
-
Volume e profondità storica dei dati (più dati = maggiore capacità di calcolo per il caricamento iniziale e la validazione)
-
Complessità delle trasformazioni (le stored procedure e le funzioni specifiche dei fornitori richiedono lavoro manuale)
-
Tolleranza ai tempi di inattività richiesta (minore tolleranza = maggiori costi dell’infrastruttura per l’esecuzione parallela)
-
Licenze degli strumenti (connettori, piattaforme di orchestrazione, strumenti di catalogazione)
-
Impegno ingegneristico (ore del team interno più eventuale consulenza esterna)
-
Supporto post-migrazione (ottimizzazione, manutenzione dei runbook e governance continua dei costi)
Prevedi un margine di riserva del 30–50% per le migrazioni complesse. Il margine non è pessimismo: è il costo degli aspetti imprevisti che la fase di valutazione non ha ancora portato alla luce. I team che saltano il margine di riserva sono quelli che richiedono modifiche urgenti all’ambito all’ottava settimana.
Allineare le priorità della migrazione agli obiettivi aziendali invece di basarsi esclusivamente su criteri tecnici è ciò che distingue le migrazioni che producono un ROI misurabile da quelle che si limitano a spostare il problema in un ambiente più costoso.
Il modello di valutazione di Ridiculous Engineering
Questo modello trasforma i dati raccolti nella fase di discovery in un elenco decisionale prioritizzato. Assegna un punteggio a ogni asset su cinque dimensioni, somma i punteggi e applica le regole di azione riportate di seguito.
Dimensioni di valutazione (scala da 1 a 5 per ciascuna)
| Dimensione | 1 (Bassa) | 3 (Media) | 5 (Alta) |
|---|---|---|---|
| Criticità aziendale | Usato raramente, nessun SLA | Usato settimanalmente, SLA informale | Uso quotidiano, SLA formale, collegato ai ricavi |
| Frequenza delle query | < 1 query/giorno | 1–50 query/giorno | > 50 query/giorno |
| Debito tecnico | Pulito, documentato | Parte della logica non documentata | Molte stored procedure, nessuna documentazione |
| Qualità dei dati | Problemi noti, scarsa fiducia | Anomalie occasionali | Elevata fiducia, convalidata regolarmente |
| Dipendenze downstream | 0–1 consumer | 2–5 consumer | 6+ consumer |
Esempio di inventario con punteggi di priorità
| Asset | Criticità | Freq. query | Debito tecnico | Qualità dei dati | Dipendenze | Totale |
|---|---|---|---|---|---|---|
orders_fact |
5 | 5 | 3 | 4 | 5 | — |
legacy_staging_v2 |
1 | 1 | 5 | 2 | 1 | — |
customer_dim |
4 | 4 | 2 | 5 | 4 | — |
archive_raw |
1 | 1 | 1 | 3 | 1 | 7 |
marketing_agg |
3 | 3 | 4 | 3 | 3 | — |
Regole di azione
-
Punteggio 18–25: Ripiattaformare con riprogettazione. Questi asset sono fondamentali per l'attività e presentano un debito tecnico o una complessità a valle sufficienti a far sì che una migrazione lift-and-shift crei problemi continui.
-
Punteggio 12–17: Ripiattaformare con ottimizzazione mirata. Trasferire alla piattaforma di destinazione e intervenire sugli elementi con il debito più elevato, ma non è necessaria una riprogettazione completa.
-
Punteggio 7–11: Eseguire una migrazione lift-and-shift o archiviare. La bassa criticità e la bassa frequenza delle query rendono questi asset candidati a un trasferimento diretto o alla dismissione.
-
Punteggio inferiore a 7: Archiviare o dismettere. Convalidare con il team responsabile, quindi rimuovere dall'ambito.
Checklist associata ai risultati della griglia di valutazione
-
[ ] Assegnare un punteggio a ogni asset nell'inventario prima di iniziare la pianificazione
-
[ ] Segnalare tutti gli asset con punteggio pari o superiore a 18 per una revisione della riprogettazione con il responsabile dell'ingegneria dei dati
-
[ ] Confermare i candidati alla dismissione con i responsabili aziendali prima di rimuoverli dall'ambito
-
[ ] Documentare la motivazione del punteggio per ogni asset nel registro dei rischi
-
[ ] Rivedere i punteggi dopo le interviste con gli stakeholder, poiché la criticità aziendale cambia spesso
Suggerimento: Compilare automaticamente i punteggi iniziali per la frequenza delle query e il debito tecnico interrogando lo schema informativo del data warehouse e le tabelle della cronologia delle query. Utilizzare un semplice script SQL per contare le query per tabella negli ultimi 90 giorni e segnalare le tabelle con dipendenze da procedure memorizzate. La valutazione manuale della criticità aziendale e della qualità dei dati richiede un'ora per intervista con ciascuno stakeholder; automatizzare tutto il resto.
Punti chiave
Una migrazione di data warehouse basata su fasi e con una strategia ibrida (replatform per gli asset critici, redesign quando il debito tecnico impedisce la scalabilità, lift-and-shift per gli asset a bassa priorità) supera costantemente gli approcci a strategia singola in termini di costi, affidabilità e tempo necessario per ottenere valore.
| Punto | Dettagli |
|---|---|
| La valutazione guida ogni decisione | Una fase di discovery incompleta porta a migrare asset inutilizzati e a costi cloud gonfiati; catalogare le tabelle di produzione prima di iniziare la pianificazione. |
| La strategia ibrida supera quella a modalità singola | Assegnare lift-and-shift, replatform o redesign a ogni asset utilizzando una griglia di valutazione a punteggio, non una regola generale. |
| La convalida richiede più tempo del previsto | Prevedere una finestra sufficiente di esecuzione parallela dopo il cutover, prima di dismettere il sistema legacy. |
| Il post-migrazione è una fase pianificata | Prevedere fin dall’inizio un budget per l’ottimizzazione delle query, la governance dei costi e l’osservabilità; non sono attività di pulizia facoltative. |
| Ridiculous Engineering come partner | Ridiculous Engineering offre incarichi di valutazione, progetti di replatforming e ottimizzazione post-migrazione per i team che necessitano di un supporto esterno esperto. |
Come Ridiculous Engineering supporta la tua migrazione
Le migrazioni dei data warehouse sono tra le decisioni infrastrutturali più rilevanti che un'organizzazione possa prendere, e la differenza tra una migrazione ben eseguita e una definita male si riflette direttamente sui costi del cloud, sulla produttività degli analisti e sull'affidabilità di ogni report a valle. Ridiculous Engineeringsviluppo software personalizzato e data engineering sono progettati esattamente per questo tipo di progetto complesso e ad alto rischio.
Il team di Ridiculous Engineering conduce incarichi di valutazione strutturati che producono l’inventario, la matrice delle dipendenze e la griglia di valutazione descritti in questa guida, così da iniziare l’esecuzione con una roadmap chiara e prioritaria anziché con un elenco di supposizioni. Da lì, il team gestisce progetti di replatforming e refactoring, l’implementazione di CDC e orchestrazione, nonché l’ottimizzazione e la governance dei costi post-migrazione. Per le organizzazioni che necessitano di supporto continuativo dopo il cutover, Ridiculous Engineering offre servizi di engineering continuativi e leadership tecnica frazionata.
Se ti trovi all’inizio di una migrazione e hai bisogno di un quadro chiaro di ambito, rischi e tempistiche prima di impegnarti in un piano di progetto completo, il passo successivo giusto è un incarico di discovery mirato. Contatta Ridiculous Engineering per discutere una valutazione definita in base al tuo ambiente.
Fonti utili e ulteriori letture
Le seguenti fonti hanno contribuito alla redazione di questa guida e vale la pena consultarle direttamente per approfondire gli aspetti tecnici:
-
Guida alla migrazione dei data warehouse e best practice (ER/Studio) — Copre le strategie di migrazione ibride, i compromessi di progettazione specifici della piattaforma e gli approcci alla convalida. Utile per le fasi di valutazione e progettazione.
-
Come utilizzare la modellazione dei dati durante la migrazione al cloud (ER/Studio) — Spiega perché la valutazione porta alla luce comportamenti di produzione non documentati e come utilizzare la modellazione dei dati come strumento di migrazione, anziché come semplice attività di documentazione.
-
Strumenti di migrazione dei database e indicazioni sull’automazione (Fivetran) — Indicazioni pratiche sulle funzionalità di automazione, sulla gestione della deriva dello schema e sui casi in cui il lavoro manuale è inevitabile.
-
Best practice e tempistiche per la migrazione dei dati (Fivetran) — Copre le finestre di convalida del cutover, la definizione dell’ambito dei progetti pilota e la pianificazione delle tempistiche. Le indicazioni sulla finestra minima di convalida di 48 ore provengono da questa fonte.
-
Migrazione del data warehouse: strategia completa e piano di progetto (Exasol) — Indicazioni dettagliate per il piano di progetto, con intervalli temporali per migrazioni di piccole dimensioni fino a quelle enterprise.
-
La tua guida alla migrazione dei data warehouse (Atlan) — Offre una trattazione approfondita dei pattern CDC e del modo in cui riducono le finestre di cutover per le origini transazionali attive.
Domande frequenti
Che cos’è la migrazione di un data warehouse?
La migrazione di un data warehouse è il processo di spostamento di dati, schemi, pipeline e carichi di lavoro di reporting da un warehouse legacy o on-premises a una nuova piattaforma, in genere un data warehouse cloud. Include valutazione, progettazione, trasferimento dei dati, conversione dell’ETL, convalida e ottimizzazione post-migrazione.
Quali sono i quattro tipi di migrazione dei dati?
I quattro tipi comuni sono la migrazione dello storage (spostamento dei dati tra sistemi di archiviazione), la migrazione del database (spostamento tra motori di database), la migrazione dell’applicazione (spostamento dei dati nell’ambito di una modifica dell’applicazione) e la migrazione dei processi aziendali (ristrutturazione dei dati per supportare nuovi flussi di lavoro). Una migrazione di warehouse combina in genere la migrazione del database e quella dell’applicazione.
ETL è la stessa cosa della migrazione dei dati?
ETL (estrazione, trasformazione, caricamento) è una tecnica utilizzata nell'ambito di una migrazione dei dati, non un suo sinonimo. La migrazione è il progetto più ampio; ETL o ELT è il meccanismo per spostare e trasformare i dati come parte di tale progetto.
Quali categorie di strumenti sono più adatte alla migrazione dei dati?
Nessun singolo strumento è in grado di gestire ogni requisito. La maggior parte dei team utilizza una combinazione di una piattaforma CDC o di connettori per lo spostamento dei dati, un framework di trasformazione (come dbt) per la conversione SQL, una piattaforma di orchestrazione per la gestione delle pipeline e uno strumento di catalogazione per la derivazione dei dati. Valuta ogni categoria in base ai tuoi specifici sistemi di origine e destinazione prima di effettuare la selezione.
Quanto dura in genere una migrazione di data warehouse?
Le migrazioni di piccole dimensioni possono essere completate in 4–6 settimane; i progetti di media complessità durano generalmente 12–24 settimane; le modernizzazioni di data warehouse aziendali possono richiedere da 8 a 50 settimane, a seconda del volume dei dati, della complessità delle integrazioni e delle dipendenze downstream.