Ottimizzazione dei costi di Kubernetes: una guida DevOps per il 2026
Ottimizzazione dei costi di Kubernetes: una guida DevOps per il 2026 L'ottimizzazione dei costi di Kubernetes è la pratica di ridurre gli sprechi dell'infrastruttura cloud mantenendo l'affidabilità, dimensionando correttamente le risorse, automatizzando il scaling e utilizzando opzioni di calcolo scontate.
Ottimizzazione dei costi di Kubernetes: una guida DevOps per il 2026
L'ottimizzazione dei costi di Kubernetes è la pratica di ridurre gli sprechi dell'infrastruttura cloud mantenendo l'affidabilità, dimensionando correttamente le risorse, automatizzando il scaling e utilizzando opzioni di calcolo scontate. Il problema di fondo è strutturale: Le fatture di Kubernetes si basano sulle richieste di risorse dei pod, non sull'utilizzo effettivo, quindi i cluster rimangono costosi anche durante i periodi di traffico basso. L'utilizzo medio della CPU nei cluster di produzione è di soli 8–12% della capacità provisionata, il che significa che la maggior parte dei team paga per capacità inattiva ogni ora di ogni giorno. La buona notizia è che i team che applicano strategie di ridimensionamento, autoscaling e istanze Spot ottengono costantemente riduzioni del 30–60% nelle spese Kubernetes, con molti che vedono risparmi significativi già nel primo mese.
Come il ridimensionamento delle richieste di risorse dei pod guida il risparmio sui costi di Kubernetes?
Il ridimensionamento è la leva più potente in qualsiasi sforzo di riduzione dei costi. Kubernetes pianifica i pod in base alle loro risorse dichiarate richieste, non a ciò che consumano effettivamente. Un pod che richiede 2 core CPU riserva quella capacità su un nodo, indipendentemente dal fatto che utilizzi 0,2 core durante l'esecuzione. Questo divario tra richieste e utilizzo effettivo è dove si nasconde la maggior parte degli sprechi di budget.
La soluzione pratica è impostare le richieste al 99° percentile dell'utilizzo storico più il 20% di margine. Una o due settimane di monitoraggio forniscono segnali sufficienti per identificare il delta tra ciò che i pod richiedono e ciò che consumano effettivamente. Quel delta è spesso una sovrastima da 3x a 8x, il che significa che il tuo cluster potrebbe funzionare con una frazione del numero attuale di nodi.
Pratiche chiave per un ridimensionamento sicuro:
-
Effettua prima un'audit. Estrai le metriche di utilizzo effettivo da Prometheus o dal monitoraggio nativo del tuo provider cloud’ prima di modificare qualsiasi richiesta.
-
Utilizza il Vertical Pod Autoscaler (VPA) in modalità raccomandazione. Il VPA analizza l'utilizzo storico e suggerisce valori dimensionati correttamente senza applicarli automaticamente, dando controllo prima di confermare.
-
Imposta i limiti di memoria con cura. Gli eventi OOMKill della memoria bloccano i pod, quindi mantieni i limiti di memoria leggermente superiori alle richieste piuttosto che uguali.
-
Evita di impostare le richieste CPU uguali ai limiti CPU. Il throttling della CPU sotto i limiti causa picchi di latenza senza bloccare il pod, rendendo più difficile la rilevazione.
-
Itera prima in staging. Applica i nuovi valori di richiesta ai carichi di lavoro non di produzione, misura la stabilità per una settimana, poi distribuisci in produzione.
I risultati del mondo reale validano questo approccio. I casi studio mostrano bollette mensili che scendono da 52.000 $ a 23.000 $ e da 85.000 $ a 34.000 $ entro pochi mesi di ridimensionamento combinato con autoscaling. I risparmi non sono teorici.
Suggerimento: Non impostare mai le richieste CPU uguali ai limiti CPU in produzione. Il throttling è silenzioso e degrada le prestazioni senza attivare avvisi, rendendolo una delle cause nascoste più comuni di latenza nei carichi di lavoro Kubernetes.
Quali strategie di autoscaling ottimizzano l'elasticità del carico di lavoro?
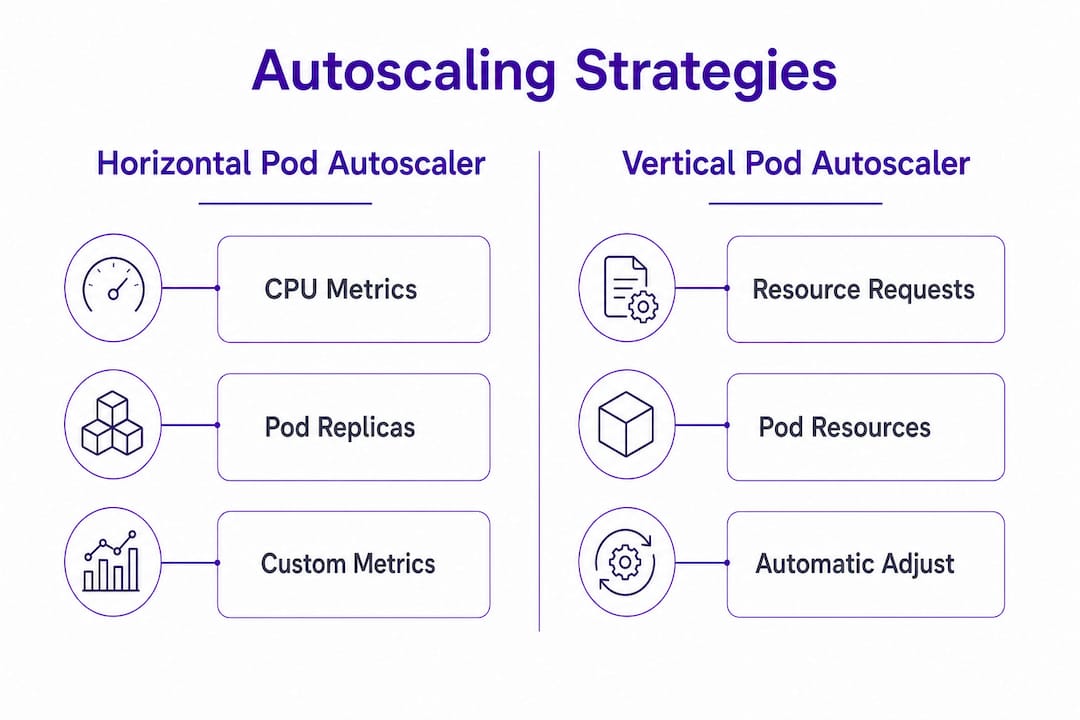
L'allocazione statica delle risorse è il nemico dell'efficienza dei costi. L'autoscaling sostituisce la capacità fissa con una capacità dinamica che segue la domanda effettiva. Tre strumenti coprono l'intera gamma di esigenze di scaling: Horizontal Pod Autoscaler (HPA), Vertical Pod Autoscaler (VPA) e KEDA (Kubernetes Event-Driven Autoscaler).
HPA scala orizzontalmente i replicanti dei pod in base alla CPU o a metriche personalizzate. VPA regola verticalmente le richieste di risorse dei singoli pod nel tempo. KEDA estende HPA per supportare lo scaling guidato dagli eventi da fonti come Kafka, SQS o code di richieste HTTP e, in modo critico, supporta lo scale-to-zero per carichi di lavoro che possono tollerare cold start. Separare le preoccupazioni tra questi tre strumenti dà ai team un controllo preciso: VPA gestisce il dimensionamento della memoria, HPA gestisce il numero di replicanti guidati dalla CPU e KEDA gestisce i pattern di burst e inattività guidati dagli eventi.
Il provisioning dei nodi è dove appaiono i maggiori risparmi infrastrutturali. Karpenter riduce gli sprechi di calcolo del 15–30% rispetto al vecchio Cluster Autoscaler selezionando dinamicamente i tipi di istanza più efficienti in termini di costi tra migliaia di opzioni. Karpenter supporta anche la consolidazione automatizzata dei nodi, che impacchetta i carichi di lavoro su meno nodi e termina quelli sottoutilizzati. Questo è il meccanismo dietro le maggiori riduzioni di costi documentate. Per i team che gestiscono eventi di scaling ad alto traffico, combinare Karpenter con HPA crea un sistema che scala rapidamente verso l'esterno e si riduce aggressivamente.
Best practice di autoscaling da implementare immediatamente:
-
Configura le finestre di stabilizzazione dello scale-down di HPA a 5–10 minuti invece del predefinito di 5 minuti per evitare flapping, ma imposta lo scale-up per rispondere entro 60 secondi.
-
Utilizza le politiche di consolidamento di Karpenter per sostituire automaticamente i nodi sovradimensionati con altri più piccoli ed economici durante i periodi di bassa domanda.
-
Imposta i trigger di KEDA per scalare i job batch a zero tra le esecuzioni, eliminando completamente i costi dei pod inattivi.
Suggerimento: Configura HPA con un comportamento di scale-down aggressivo impostando scaleDown.stabilizationWindowSeconds a 300 e percentPod politiche per rimuovere il 50% dei pod in eccesso al minuto. Questo da solo può tagliare i costi di calcolo fuori picco del 20–40% per i carichi di lavoro variabili.
Come le istanze Spot e i cambiamenti architetturali possono amplificare i risparmi?
Le scelte a livello infrastrutturale moltiplicano i risparmi derivanti dal ridimensionamento e dall'autoscaling. Le istanze Spot offrono risparmi del 60–90% rispetto ai prezzi On-Demand, rendendole la leva di prezzo più impattante disponibile. Il rovescio della medaglia è il rischio di interruzione. Le istanze Spot possono essere recuperate dal provider cloud con due minuti’ di preavviso, quindi la selezione del carico di lavoro è importante.
I carichi di lavoro stateless, i job batch e i runner CI/CD sono candidati ideali per Spot. I carichi di lavoro stateful, i database e qualsiasi cosa richieda connessioni persistenti dovrebbero rimanere sui nodi On-Demand. Implementa Spot in sicurezza combinando i budget di interruzione dei pod con le tolleranze dei nodi che mirano ai pool di nodi Spot. Karpenter gestisce il fallback Spot automaticamente, passando a On-Demand quando la capacità Spot non è disponibile.
| Ottimizzazione | Risparmi stimati | Complessità di implementazione |
|---|---|---|
| Istanze Spot (carichi di lavoro stateless) | 60–90% sul calcolo idoneo | Media |
| Processori ARM Graviton | ~20% di riduzione dei costi | Bassa a Media |
| Migrazione volumi EBS gp3 | ~20% di riduzione dei costi di storage | Bassa |
| Controller ingress consolidati | Variabile, riduce il numero di load balancer | Bassa |
| Endpoint VPC gateway NAT | Riduce le tariffe di trasferimento dati | Bassa |
La migrazione verso istanze Graviton basate su ARM produce costi inferiori di circa il 20% con prestazioni paragonabili o migliori per la maggior parte dei carichi di lavoro. Karpenter può mirare a Graviton automaticamente quando specifichi ARM come architettura preferita nella configurazione del tuo NodePool. La migrazione da gp2 a volumi EBS gp3 riduce i costi di storage di circa il 20% con zero downtime, poiché la migrazione avviene online. Questi sono cambiamenti a basso sforzo con rendimenti garantiti.
I costi di rete sono spesso trascurati. Le tariffe di trasferimento dati del gateway NAT si accumulano rapidamente nei cluster con un elevato egress. L'aggiunta di endpoint VPC per servizi come S3 e ECR instrada il traffico in modo privato, bypassando completamente NAT. Consolidare più controller ingress in un singolo controller condiviso riduce anche il numero di load balancer cloud provisionati, abbassando direttamente i costi fissi mensili.
Quali pratiche di governance sostengono l'ottimizzazione dei costi di Kubernetes?
Le ottimizzazioni tecniche decadono senza governance. I team tornano al sovraprovisioning quando non c'è visibilità su chi possiede quale spesa. L'allocazione dei costi attraverso showback e chargeback dà ai team di ingegneria una visione diretta del costo dei loro carichi di lavoro, cambiando il comportamento in modo più affidabile di qualsiasi documento di policy.
La base è un'etichettatura coerente. Ogni namespace, deployment e volume persistente dovrebbe avere etichette per team, ambiente e centro di costo. L'applicazione dell'etichettatura con controller di ammissione come OPA Gatekeeper o Kyverno impedisce la creazione di risorse non etichettate fin dall'inizio. Senza applicazione, la copertura delle etichette degrada nel tempo mentre i team si muovono velocemente e saltano il tagging.
Pratiche di governance che sostengono i risparmi:
-
Esegui revisioni dei costi settimanali utilizzando OpenCost o Kubecost per evidenziare le tendenze di spesa a livello di namespace.
-
Imposta avvisi di budget a livello di namespace in modo che i team ricevano notifiche prima di spendere troppo, non dopo.
-
Pianifica la pulizia mensile di PersistentVolumeClaims orfani, namespace inattivi e ConfigMaps obsolete.
-
Assegna un campione FinOps per team per possedere le metriche di costo insieme alle metriche di affidabilità.
Il cambiamento culturale è importante quanto l'ottimizzazione tecnica. Incorporare la responsabilità dei costi nelle revisioni degli sprint e negli OKR di ingegneria sostiene i risparmi a lungo termine. I team che trattano la spesa cloud come una metrica di ingegneria condivisa, non come un problema finanziario, superano costantemente quelli che trattano l'ottimizzazione come un progetto una tantum. La dimensione della cultura ingegneristica di DevOps è dove risiede la disciplina dei costi durevole.
Suggerimento: Inizia con lo showback prima del chargeback. Mostrare ai team i loro costi senza fatturarli prima crea consapevolezza e consenso. Il chargeback senza contesto crea attrito e resistenza invece di proprietà.
Punti chiave
Un'efficace ottimizzazione dei costi di Kubernetes richiede prima il ridimensionamento delle richieste di risorse, poi l'aggiunta di autoscaling e calcolo scontato e infine l'incorporazione della governance per impedire che gli sprechi tornino.
| Punto | Dettagli |
|---|---|
| Ridimensiona prima le richieste dei pod | Imposta le richieste all'utilizzo P99 più il 20% di margine; usa VPA in modalità raccomandazione prima di applicare le modifiche. |
| Autoscala a ogni livello | Combina HPA, VPA, KEDA e Karpenter per adattare la capacità alla domanda dinamicamente. |
| Usa istanze Spot e Graviton | Spot risparmia il 60–90% sui carichi di lavoro idonei; Graviton riduce i costi di calcolo di circa il 20%. |
| Applica etichettatura e allocazione | Usa OPA Gatekeeper o Kyverno per imporre le etichette; esegui report showback per costruire la responsabilità del team. |
| Misura prima di tagliare | Stabilisci la visibilità dei costi con OpenCost o Kubecost prima di apportare qualsiasi modifica all'infrastruttura. |
Cosa ho’ imparato dal lavoro reale sui costi di Kubernetes
L'errore più comune che vedo fare ai team è saltare direttamente alle istanze Spot o al consolidamento dei load balancer prima di correggere le loro richieste di risorse. Quei risparmi sono reali, ma sono moltiplicatori su una linea di base rotta. Se i tuoi pod richiedono 4 volte ciò che usano, i prezzi Spot su quei pod lasciano ancora la maggior parte degli sprechi intatti.
La sequenza conta: prima la visibilità, poi il ridimensionamento, poi l'ottimizzazione dei prezzi. I team che seguono questo ordine ottengono costantemente riduzioni più grandi e durevoli rispetto ai team che inseguono vittorie rapide fuori ordine. Ho visto organizzazioni tagliare a metà le loro bollette entro 90 giorni seguendo questa sequenza e ho visto altre spendere mesi in negoziazioni di Istanze Riservate mentre i loro cluster funzionavano al 10% di utilizzo.
Il problema più difficile è organizzativo. Gli ingegneri non sovradimensionano per negligenza. Lo fanno perché sono misurati sull'affidabilità, non sul costo. Finché il costo non appare nella stessa dashboard di uptime e latenza, rimane invisibile. I team che sostengono i risparmi sono quelli che rendono il costo una metrica ingegneristica di primo livello, rivista nella stessa riunione in cui rivedono gli SLO. Quel cambiamento è più difficile di qualsiasi configurazione di Karpenter e conta di più.
— Paul CEO
Ridiculousengineering può aiutarti a tagliare i costi di Kubernetes
La riduzione dei costi di Kubernetes è una sfida tecnica e organizzativa. Farlo correttamente richiede un'analisi accurata del carico di lavoro, automazione ben progettata e sistemi di governance che reggano sotto la pressione reale dei team di ingegneria.
Ridiculousengineering lavora con manager IT e team DevOps per progettare e costruire l'infrastruttura cloud, l'automazione e gli strumenti di governance che rendono l'efficienza dei costi duratura. Dall'analisi del ridimensionamento ai servizi di architettura cloud e DevOps personalizzati, il team porta sia la profondità tecnica che l'esperienza organizzativa per spostare le tue spese Kubernetes nella direzione giusta. Se le bollette del tuo cluster non riflettono il tuo carico di lavoro effettivo, quel divario vale la pena chiuderlo.
FAQ
Qual è il modo più veloce per ridurre i costi di Kubernetes?
Il ridimensionamento delle richieste di risorse dei pod offre i risparmi più rapidi. I team vedono comunemente riduzioni del 20–30% nel primo mese allineando le richieste all'utilizzo effettivo e rimuovendo i carichi di lavoro inattivi.
Come differisce Karpenter da Cluster Autoscaler?
Karpenter provisiona nodi dinamicamente attraverso migliaia di tipi di istanza e supporta il consolidamento automatizzato, riducendo gli sprechi di calcolo del 15–30% rispetto all'approccio a gruppi di nodi statici di Cluster Autoscaler’.
Le istanze Spot sono sicure per i carichi di lavoro Kubernetes di produzione?
Le istanze Spot sono sicure per carichi di lavoro stateless, job batch e runner CI/CD. I carichi di lavoro stateful e i database dovrebbero rimanere sui nodi On-Demand per evitare interruzioni dagli eventi di recupero Spot.
Quali strumenti forniscono visibilità sui costi di Kubernetes?
OpenCost e Kubecost sono le opzioni open-source e commerciali leader per l'allocazione dei costi a livello di namespace. Entrambi si integrano con Prometheus e supportano report showback e chargeback.
Come etichette e controller di ammissione riducono gli sprechi di Kubernetes?
Etichette coerenti abilitano un'attribuzione accurata dei costi per team e ambiente. I controller di ammissione come OPA Gatekeeper o Kyverno applicano l'etichettatura alla creazione della risorsa, impedendo l'accumulo di risorse non etichettate e non tracciate.