Human in the Loop: una guida pratica per team di prodotto e ingegneria
Human in the Loop: una guida pratica per team di prodotto e ingegneria. Human-in-the-loop (HITL) è un modello operativo in cui gli esseri umani prendono o verificano decisioni che un sistema automatizzato non può gestire in modo sicuro o affidabile da solo.
Human in the Loop: una guida pratica per team di prodotto e ingegneria
Human-in-the-loop (HITL) è un modello operativo in cui gli esseri umani prendono o verificano decisioni che un sistema automatizzato non può gestire in modo sicuro o affidabile da solo. Stanford HAI definisce la versione più forte di questo concetto non come “gli esseri umani sono presenti” ma come “gli esseri umani hanno il controllo” — mantenendo l’autorità sulle decisioni ad alto rischio invece di approvare automaticamente l’output del modello. Le linee guida NIST per la gestione del rischio dell’IA rafforzano che la supervisione umana documentata è un controllo fondamentale nelle implementazioni di IA ad alto rischio. Ridiculous Engineering costruisce questi sistemi per team di prodotto che ne hanno bisogno per funzionare davvero in produzione, non solo per apparire bene in un diagramma di architettura.
Usa HITL quando uno di questi segnali è vero:
-
Il costo di una decisione automatizzata errata è alto (finanziario, legale, clinico, reputazionale).
-
Gli input sono ambigui o fuori distribuzione abbastanza spesso che la fiducia del modello è inaffidabile.
-
Requisiti normativi o di audit richiedono un punto di decisione umano documentato.
Il compromesso principale è diretto: HITL aggiunge sicurezza, auditabilità e un flusso continuo di dati etichettati per il miglioramento del modello, ma aggiunge anche latenza, costi di personale e complessità operativa che le pipeline completamente automatizzate evitano.
Punti chiave
I sistemi human-in-the-loop funzionano quando il giudizio umano è trattato come una modalità operativa pianificata con routing definito, interfacce chiare e cicli di feedback che alimentano il miglioramento del modello.
| Punto | Dettagli |
|---|---|
| Inizia con l’escalation selettiva | Instrada solo decisioni a bassa fiducia o ad alto rischio agli esseri umani; automatizza il resto per controllare costi e latenza. |
| Definisci il confine dell’automazione per iscritto | Una regola di routing è più affidabile di una linea guida vaga; documentala prima del go-live e rivedila trimestralmente. |
| Traccia cinque KPI principali | Tasso di errore, accuratezza del revisore, latenza media di revisione, tasso di escalation e tasso di riutilizzo del feedback coprono la salute della coda e il segnale di miglioramento del modello. |
| Esegui controlli di accordo tra revisori | Un accordo inferiore all’80% su un set di calibrazione condiviso segnala che le linee guida decisionali necessitano di maggiore specificità prima che i dati di addestramento siano affidabili. |
| Ridiculous Engineering costruisce sistemi HITL di produzione | Per i team che necessitano di un flusso di lavoro human-in-the-loop progettato, conforme e misurabile, Ridiculous Engineering fornisce l’ingegneria e l’architettura per realizzarlo. |
Sommario
-
Cosa significa realmente “human in the loop” e in cosa si differenzia da termini correlati?
-
Quando dovresti adottare un modello operativo human-in-the-loop?
-
Quali sono i pattern di progettazione HITL principali e con quale dovresti iniziare?
-
Quali ruoli, flussi di lavoro ed elementi UI richiede un sistema HITL di produzione?
-
Quali KPI e controlli di qualità dovresti tracciare in un sistema HITL?
-
Come implementi HITL in produzione? Una checklist passo-passo
-
Quali sono gli anti-pattern HITL più comuni e come li risolvi?
-
Ridiculous Engineering costruisce sistemi HITL che funzionano in produzione
Cosa significa realmente “human in the loop” e in cosa si differenzia da termini correlati?
Secondo Stanford HAI, HITL si riferisce a sistemi di IA in cui il feedback o l'intervento umano fa parte del funzionamento normale: gli esseri umani guidano, correggono errori o prendono decisioni finali per migliorare accuratezza e affidabilità. Questa definizione copre molto terreno, quindi il campo utilizza tre varianti distinte per essere più preciso.
Human-in-the-loop (HITL): Il sistema si mette in pausa e attende una decisione umana prima di procedere. Un radiologo che esamina una scansione segnalata prima che venga registrata una diagnosi è un esempio chiaro. L'azione dell'essere umano fa parte della transazione.
Human-on-the-loop (HOTL): Il sistema agisce in modo autonomo, ma un essere umano monitora il flusso di output e può intervenire. Un sistema di rilevamento frodi che blocca automaticamente le transazioni mentre un analista del rischio osserva la coda di avvisi opera in questo modo. L'essere umano può sovrascrivere, ma il sistema non attende.
Human-out-of-the-loop (HOOTL): Nessun essere umano è coinvolto nelle decisioni individuali. Un processo batch notturno che rivaluta un segmento di clienti e aggiorna un modello di raccomandazione funziona senza alcun punto di contatto umano per record.
Un modello mentale compatto per documentazione e diagrammi: HITL = pausa e approva; HOTL = monitora e intervieni; HOOTL = controllo fantasma. Questa abbreviazione tende a funzionare bene nelle revisioni di design e nella pianificazione sprint quando i team discutono su dove tracciare il confine dell'automazione.
Vedrai anche HITL chiamato automazione assistita dall'uomo o un flusso di lavoro ibrido uomo-IA in contesti di prodotto e operazioni. Il significato è lo stesso; la cornice cambia a seconda che chi parla enfatizzi il lato IA o il lato umano della collaborazione.
Quando dovresti adottare un modello operativo human-in-the-loop?
La decisione non è binaria. La maggior parte dei sistemi di produzione si trova da qualche parte su uno spettro, e la risposta giusta dipende da una manciata di segnali concreti. Esaminali in ordine:
-
Una decisione sbagliata richiede una correzione sincrona? Se un errore scoperto dopo il fatto è troppo costoso da rimediare, hai bisogno di un essere umano nel percorso decisionale prima che l'azione venga attivata.
-
È richiesta la verificabilità? I settori regolamentati — assicurazioni, sanità, servizi finanziari, governo — spesso richiedono un punto decisionale umano documentato. La ricerca di revisione sistematica conferma che i requisiti di governance e conformità sono un motore primario dell'adozione di HITL in domini ad alto rischio.
-
La fiducia del modello è calibrata in modo affidabile? Se le stime di incertezza del tuo modello non seguono i tassi di errore effettivi, non puoi fidarti delle soglie di confidenza per instradare in modo sicuro senza backup umano.
-
Quanto sono frequenti i casi limite? Un modello che gestisce bene il 95% degli input ma fallisce gravemente sul restante 5% può comunque giustificare HITL se quel 5% comporta un rischio sproporzionato.
-
Ci sono vincoli legali o normativi sulle decisioni automatizzate? Certe decisioni — rifiuti di credito, idoneità ai benefici, raccomandazioni cliniche — comportano requisiti legali di responsabilità umana negli Stati Uniti.
Tre brevi esempi di prodotto che mappano questi segnali:
-
Triage dei sinistri assicurativi: Alte poste finanziarie, traccia di audit normativa richiesta e input di casi limite (eventi di perdita insoliti) sono comuni. HITL sui sinistri segnalati è sia una decisione di prodotto che di conformità.
-
Supporto al triage medico: La ricerca clinica mostra che HITL riduce il rischio in domini ad alta posta in gioco abbinando suggerimenti del modello a giudizio umano, mentre i casi esaminati generano dati etichettati che alimentano il miglioramento del modello nel tempo.
-
Escalation dell'IA conversazionale: Un chatbot di supporto che rileva risposte a bassa confidenza e le instrada a un agente umano è un pattern HITL leggero. Le poste in gioco per interazione sono più basse, ma il volume è alto e l'esperienza del cliente è in gioco.
Il compromesso onesto: ogni punto di contatto umano aggiunge latenza e costo. Una coda di revisione che impiega quattro ore a svuotarsi è un ritardo di quattro ore nel tuo pipeline. Assumere un team di revisione è una spesa operativa ricorrente. La risposta a “ne vale la pena?” è quasi sempre “sì, per il giusto sottoinsieme di decisioni” — ecco perché esistono soglie di confidenza ed escalation selettiva. Instrada solo le decisioni che il modello non può davvero possedere e automatizza il resto. Questa è l'anteprima dei pattern di design di seguito.
Quali sono i pattern HITL fondamentali e da quale si dovrebbe iniziare?
DistilledPatterns nomina i pattern canonici e fa un punto che vale la pena ripetere: trattare il lavoro umano come una modalità operativa pianificata, non come una soluzione temporanea. I pattern seguenti riflettono questa impostazione.
Escalation Selettiva è il pattern di partenza consigliato per la maggior parte dei team. Il modello gestisce automaticamente le decisioni ad alta confidenza e instrada i casi a bassa confidenza o ad alto rischio a un revisore umano. È il punto di ingresso a costo più basso perché minimizza il volume di revisione proteggendo le decisioni più importanti.
Autonomia Consapevole del Rischio estende l'escalation selettiva valutando le decisioni su una dimensione di rischio (non solo confidenza) e applicando regole di instradamento diverse per ogni livello di rischio. Un modello di frode nei pagamenti potrebbe approvare automaticamente le transazioni a basso rischio, mettere in coda quelle a rischio medio per una revisione in giornata e bloccare quelle ad alto rischio immediatamente in attesa di autorizzazione umana.
Flywheel dei Dati tratta ogni revisione umana come un segnale di addestramento. I casi revisionati rifluiscono nella pipeline di addestramento del modello, così il modello migliora nel tempo e il volume delle decisioni escalate si riduce. Questo pattern richiede più infrastruttura ma aumenta di valore in modo composto.Databricks nota che le soglie di confidenza e il punteggio di rischio rendono questo tipo di escalation selettiva scalabile nella pratica.
Consegna a Fasi applica HITL in checkpoint definiti di un flusso di lavoro piuttosto che su singole decisioni. Una pipeline di elaborazione documenti potrebbe eseguire l'estrazione automatica, poi fermarsi su un passaggio di revisione umana prima di impegnare i risultati in un sistema a valle. È adatto a flussi di lavoro batch dove la latenza per record è meno critica dell'accuratezza al checkpoint.
Centrato sul Compito organizza il ruolo umano attorno a un tipo specifico di compito (annotazione, verifica, gestione eccezioni) piuttosto che attorno alla confidenza del modello. Comune nelle pipeline di etichettatura e moderazione dei contenuti.
| Pattern | Quando sceglierlo | Profilo di latenza | Modello di staffing | Valore del feedback |
|---|---|---|---|---|
| Escalation Selettiva | Punto di partenza predefinito; la confidenza del modello è misurabile | Bassa per la maggior parte delle decisioni; più alta per il sottoinsieme escalato | Piccolo team di revisione on-call | Moderato |
| Autonomia Consapevole del Rischio | I livelli di rischio sono ben definiti; la conformità richiede risposte a livelli | Variabile per livello | Revisori a livelli per competenza | Da moderato ad alto |
| Flywheel dei Dati | Il miglioramento del modello è un obiettivo primario; l'infrastruttura esiste | Aggiunge latenza alla pipeline | Team di annotazione dedicato | Alto |
| Consegna a Fasi | Flussi di lavoro batch; l'accuratezza ai checkpoint conta più della velocità | Più alta per batch | Revisori ai checkpoint | Moderato |
| Incentrato sul compito | Etichettatura o moderazione dei contenuti su larga scala | Dipende dal compito | Pool di annotatori ad alto volume | Elevato per l'etichettatura |
Suggerimento professionale: Inizia con l'escalation selettiva e una soglia di confidenza conservativa. Tieni traccia del tasso di escalation settimanalmente. Man mano che il modello migliora e acquisisci fiducia nella sua calibrazione, aumenta la soglia in modo incrementale. Spostare il confine dell'automazione è un processo deliberato e misurato, non una decisione architettonica una tantum. I team che pianificano questa transizione dal primo giorno costruiscono sistemi che diventano più economici da gestire nel tempo.
Quali ruoli, flussi di lavoro ed elementi UI richiede un sistema HITL di produzione?
Il lato umano di un sistema HITL richiede tanta attenzione progettuale quanto il lato del modello. Quattro ruoli coprono la maggior parte delle configurazioni di produzione:
-
Annotatore: Etichetta dati grezzi o output del modello; nessuna autorità sulle decisioni a valle. Lavora ad alto volume.
-
Revisore: Approva, rifiuta o corregge le decisioni del modello entro un ambito definito. Detiene l'autorità decisionale per il proprio livello.
-
Esperto in materia (SME): Gestisce le escalation che il revisore non può risolvere. Detiene l'autorità su casi limite ed eccezioni politiche.
-
Proprietario dell'escalation: Il punto decisionale umano finale per casi ad alto rischio o contestati. Spesso un esperto senior di dominio o un responsabile della conformità.
Confini di autorità chiari contano. Un revisore che non sa se può sovrascrivere una decisione del modello o sotto-corregge (timbro di gomma) o sovra-escala (creando un collo di bottiglia al livello SME).
Checklist minima dell'interfaccia di revisione praticabile
Un buon design UI HITL minimizza il carico cognitivo e fornisce i segnali di cui i revisori hanno bisogno per prendere decisioni sicure rapidamente. Come minimo, un'interfaccia di revisione necessita di:
-
Superficie delle prove: Input, output e punteggio di confidenza del modello, presentati nel contesto.
-
Affordance delle azioni: Controlli chiari di approva/rifiuta/escala senza stati ambigui.
-
Registrazione delle decisioni: Ogni azione con timestamp e attribuita a un revisore nominato.
-
Segnali di spiegabilità: Una breve motivazione del perché il modello ha segnalato questo caso (importanza delle caratteristiche, trigger di regola o ripartizione della confidenza).
-
Controlli di sovrascrittura: Un percorso per il revisore per correggere l'output del modello, non solo accettarlo o rifiutarlo.
Operativamente, il sistema necessita anche di regole di instradamento (quali casi vanno a quale livello di revisore), obiettivi SLA (ad es., latenza di revisione P95 sotto le quattro ore per una data coda), pianificazione della capacità per evitare accumuli in coda e un processo di risoluzione dei disaccordi per casi in cui i revisori sono in conflitto. Questi non sono optional; sono la differenza tra un sistema HITL che migliora il prodotto e uno che diventa un arretrato di ticket di supporto.
Suggerimento professionale: Scrivi una linea guida decisionale di una pagina per ogni ruolo di revisore prima del lancio. Poi esegui un piccolo controllo di accordo inter-rater: fai valutare a due revisori in modo indipendente gli stessi 20 casi e misura l'accordo. Decisioni umane coerenti sono ciò che fa funzionare il volano dei dati.
Quali KPI e controlli di qualità dovresti monitorare in un sistema HITL?
Le metriche di primo livello che contano:
-
Tasso di errore: Il tasso con cui le decisioni revisionate vengono successivamente trovate errate. Questo è il tuo segnale primario di accuratezza.
-
Accuratezza/precisione del revisore: Accordo per revisore con un set gold-standard. Identifica deriva e lacune di formazione.
-
Latenza media di revisione:Tempo medio dall'arrivo del caso alla decisione. Monitora la salute della coda e la conformità SLA.
-
Tasso di escalation: La percentuale di decisioni totali instradate alla revisione umana. Un tasso in aumento può segnalare un degrado del modello; un tasso in calo può segnalare che la soglia è pronta per essere stretta.
-
Tasso di riutilizzo del feedback: La percentuale di casi revisionati che rifluiscono nella formazione del modello. Un basso riutilizzo significa che il volano dei dati non sta girando.
Calcolare il ROI del revisore è semplice in teoria: confrontare il costo dell'operazione di revisione (ore del revisore per costo caricato) con il valore degli errori prevenuti (riduzione del tasso di errore per costo medio per errore). In pratica, la cifra del "costo per errore" richiede input di dominio, ma anche una stima approssimativa dà alle parti interessate un numero difendibile.
Una dashboard KPI minima per un sistema HITL di produzione dovrebbe includere: volume giornaliero di escalation, latenza di revisione P50/P95, accuratezza del revisore per livello, tendenza del tasso di errore (media mobile a 7 giorni) e tasso di riutilizzo del feedback. Questi cinque widget coprono salute della coda, qualità del revisore e segnale di miglioramento del modello in un'unica vista.
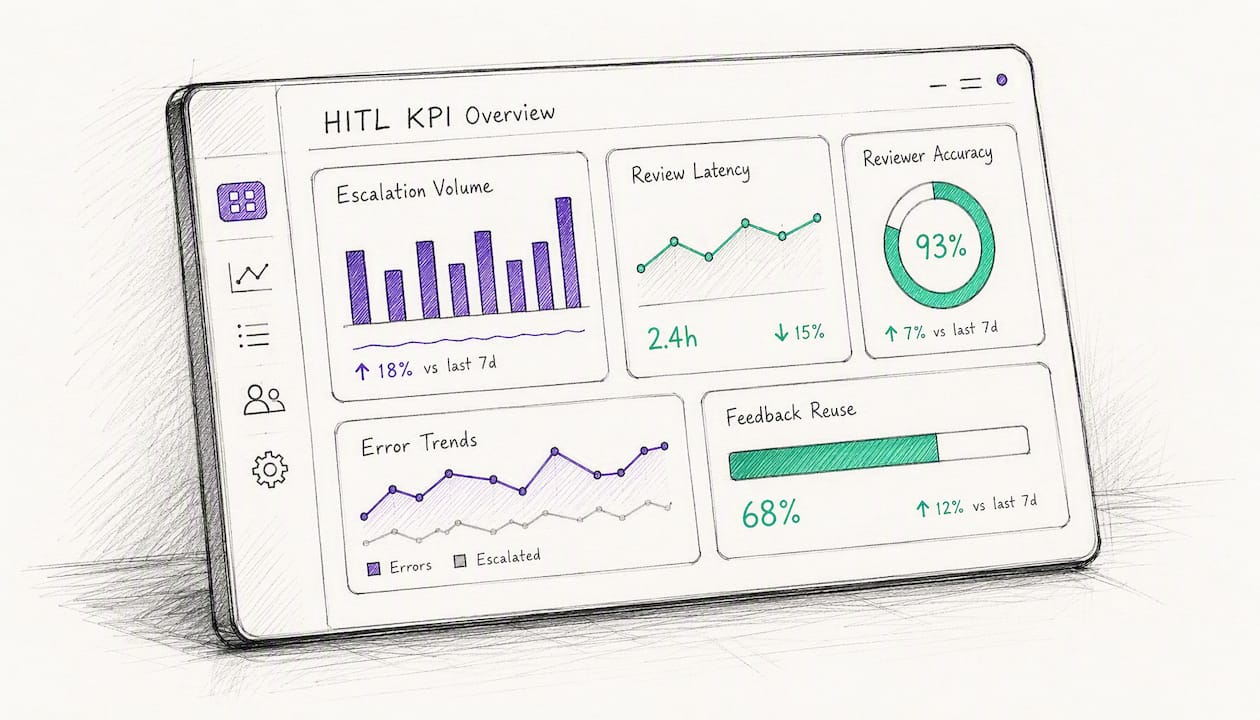
Controlli di qualità da eseguire continuamente: campionamento di audit periodico (estrarre un set casuale di casi revisionati e ri-valutarli rispetto a uno standard di riferimento), controlli di accordo inter-rater su un set di calibrazione condiviso e controllo della versione dell'etichettatura per sapere quale versione del modello corrisponde a ciascun lotto di addestramento.
Due trappole di misurazione che vale la pena nominare esplicitamente. Primo, bias di selezione nei set escalati: i casi che gli umani revisionano non sono un campione casuale di tutte le decisioni. Le metriche di accuratezza calcolate solo sui casi escalati sovrastimeranno o sottostimeranno le prestazioni del modello sull'intera distribuzione. Secondo, deriva delle metriche: man mano che il modello migliora e il tasso di escalation diminuisce, i casi escalati rimanenti tendono verso casi limite più difficili, facendo sembrare l'accuratezza del revisore in calo anche quando nulla è cambiato nel comportamento del revisore.
Come si implementa HITL in produzione? Una checklist passo-passo
-
Definire ambito e obiettivi. Identificare quali decisioni necessitano di supervisione umana, il tasso di errore accettabile e il budget di latenza. Documentare questo come una politica decisionale di una pagina.
-
Scegliere il proprio modello di progettazione. Per la maggior parte dei team che iniziano da zero, l'Escalation Selettiva è l'impostazione predefinita giusta. Abbina il modello alla tua tolleranza di latenza e capacità di personale.
-
Definire il confine di automazione. Specificare esattamente quali input il modello gestisce autonomamente e quali attivano la revisione umana. Scrivere questo come una regola di instradamento, non una linea guida vaga.
-
Progettare l'interfaccia di revisione e la logica di instradamento. Applicare la checklist UI minima sopra. Costruire le regole di instradamento nel sistema di coda, non nel modello.
-
Assumere e formare i revisori. Scrivere le linee guida decisionali prima che inizi la formazione. Eseguire un controllo di accordo inter-rater prima del go-live. Vedere le considerazioni sulla strategia di talenti AI e tech per strutturare i ruoli dei revisori insieme ai team di ingegneria.
-
Catturare e convogliare il feedback. Ogni decisione revisionata dovrebbe scrivere a un dataset etichettato con ID del revisore, timestamp, output originale del modello e decisione finale. Questo è il materiale grezzo per il volano dei dati.
-
Strumentare monitoraggio e KPI. Impostare la dashboard a cinque widget prima del lancio. Impostare avvisi su tasso di escalation e latenza P95.
-
Pianificare aumenti di automazione con gate a fasi. Programmare una revisione trimestrale delle soglie di confidenza. Definire gli obiettivi metrici che giustificano l'innalzamento del confine di automazione. Questo è come l'adozione pragmatica dell'automazione compone valore nel tempo.
Stack tecnologico minimo per componente: Annotazione ed etichettatura (Label Studio, Scale AI o un'UI personalizzata leggera); coda e instradamento (una coda di attività come Celery o un motore di workflow come Temporal); registrazione di audit (archivio eventi append-only, JSON strutturato); pipeline di formazione del modello (MLflow, Kubeflow o un servizio gestito); monitoraggio e avvisi (Prometheus più Grafana, o una piattaforma di osservabilità gestita).
Note su conformità e sicurezza: Applicare la minimizzazione dei dati — i revisori dovrebbero vedere solo i campi necessari per prendere la loro decisione. I PII nelle code di revisione necessitano di controllo accessi e una politica di conservazione documentata. Crittografare i dati a riposo e in transito. Per i settori regolamentati, mantenere un registro di audit immutabile di ogni decisione umana con l'identità del revisore e il timestamp. Questi controlli non sono opzionali in sanità, servizi finanziari o implementazioni governative.
In un impegno di produzione, un team che elaborava classificazione di documenti ad alto volume instradava tutti i casi a bassa confidenza a una coda di revisione a due livelli. Dopo diversi mesi di reimmissione dei casi revisionati nella pipeline di formazione, il tasso di escalation è diminuito significativamente e la latenza media di revisione è migliorata notevolmente. Il modello è migliorato perché il lavoro umano è stato trattato come dati di formazione strutturati dal primo giorno, non come un passo di correzione manuale aggiunto dopo il fatto.
Quali sono gli anti-pattern HITL più comuni e come li si risolve?
-
Soluzioni informali tardive da parte degli esseri umani. Gli ingegneri notano che il modello è sbagliato e aggiungono silenziosamente un passaggio di correzione manuale al di fuori del sistema formale. La soluzione: rendere la revisione umana un componente di flusso di lavoro di prima classe fin dall'inizio, con instradamento, registrazione e SLA. DistilledPatterns è esplicito sul fatto che il lavoro umano debba essere una modalità operativa pianificata, non una toppa.
-
Sistemi opachi che impongono revisioni di sola firma. I revisori approvano tutto perché l'interfaccia non fornisce loro alcun contesto per dissentire. La soluzione: mostrare il ragionamento del modello, il punteggio di confidenza e le prove pertinenti. La ricerca sull'interfaccia utente conferma che il carico cognitivo e i segnali di fiducia influiscono direttamente sull'efficacia del revisore.
-
Code sovraccariche. La latenza di revisione aumenta, gli SLA si rompono e il passaggio umano diventa il collo di bottiglia. La soluzione: monitorare la latenza P95 quotidianamente, impostare avvisi di capacità prima che le code si saturino e aumentare temporaneamente la soglia di automazione quando il volume aumenta.
-
Linee guida decisionali poco chiare. I revisori prendono decisioni incoerenti, i dati di addestramento sono rumorosi e il modello non migliora. La soluzione: scrivere linee guida esplicite, eseguire controlli di accordo tra valutatori trimestralmente e versionare le linee guida insieme al modello.
-
Ignorare il riutilizzo del feedback. I casi revisionati giacciono in un database e non raggiungono mai la pipeline di addestramento. La soluzione: strumentare il tasso di riutilizzo del feedback come KPI di prima classe e assegnare la proprietà della pipeline a un ingegnere nominato.
Quando ritirare la revisione umana: Monitorare l'accuratezza del revisore rispetto all'accuratezza autonoma del modello sullo stesso tipo di decisione. Quando il tasso di errore del modello sui casi precedentemente inoltrati scende entro il margine di errore del revisore, e il tasso di inoltro è abbastanza basso che il costo operativo supera la riduzione del rischio, il passaggio umano ha fatto il suo lavoro. Ritirarlo deliberatamente, documentare la decisione e conservare il registro di controllo.
Ulteriori letture e fonti primarie
Queste sono le fonti primarie utilizzate per questa guida. Ognuna copre una dimensione distinta di HITL che vale la pena leggere per intero.
-
Stanford HAI — Che cos'è Human-in-the-Loop? Definizione autorevole e quadro di riferimento "esseri umani al comando" che distingue la supervisione genuina dalla presenza passiva.
-
Databricks — Che cos'è Human-in-the-Loop (HITL)? Copertura pratica delle soglie di confidenza, del punteggio di rischio e di come HITL appare nel ciclo di vita dell'IA.
-
DistilledPatterns — Human-in-the-Loop Pattern di progettazione nominati, anti-pattern operativi e il caso per trattare il lavoro umano come una modalità di produzione pianificata.
-
MDPI Entropy — Revisione sistematica dei concetti, metodi e applicazioni HITL Tassonomia accademica delle varianti HITL per posizione del ciclo, granularità dell'interazione e caratteristiche temporali; copre le sfide di scalabilità e governance.
-
NCBI — HITL in domini clinici e ad alto rischio Evidenze sulla riduzione del rischio, generazione di dati etichettati e gestione dei costi operativi nelle implementazioni sanitarie.
-
IJISAE — Progettazione UI Human-in-the-Loop Ricerca su carico cognitivo, fedeltà semantica e segnali di fiducia nelle interfacce di revisione per la co-creazione con IA generativa.
Ridiculous Engineering costruisce sistemi HITL che funzionano in produzione
La maggior parte dei team che vengono da noi ha già provato ad aggiungere la revisione umana a una pipeline esistente e ha scoperto che non scala. La coda si riempie, le linee guida sono vaghe, il feedback non raggiunge mai il modello e il tutto diventa un processo manuale con un logo IA sopra.
Ridiculous Engineering progetta software personalizzato basato su IA dove il livello di supervisione umana è un componente ingegnerizzato, non un ripensamento. Ciò significa un'interfaccia di revisione costruita per il carico cognitivo effettivo del revisore, logica di instradamento che mantiene le code libere, registrazione di controllo che soddisfa i requisiti di conformità e una pipeline di feedback che rende il modello misurabilmente migliore nel tempo. Lavoriamo con team di prodotto e ingegneria in startup, aziende e organizzazioni governative in tutto il Colorado e a livello globale. Se sei pronto a costruire un sistema HITL che regga sotto carico di produzione, inizia una conversazione con il nostro team.
Fonti
FAQ
Qual è la teoria dell'human-in-the-loop?
La teoria dell'essere umano nel ciclo afferma che i sistemi di IA funzionano in modo più affidabile e sicuro quando gli esseri umani mantengono l'autorità sulle decisioni che il modello non può assumere con sufficiente fiducia. Stanford HAI la inquadra come "esseri umani al comando" piuttosto che semplicemente "esseri umani presenti".
Cosa significa mantenere l'essere umano nel ciclo?
Mantenere l'essere umano nel ciclo significa instradare decisioni specifiche a un revisore umano prima che il sistema agisca, piuttosto che lasciare che il modello decida in modo autonomo. In pratica, ciò comporta soglie di fiducia, code di revisione e registrazione documentata delle decisioni affinché ogni azione umana sia tracciabile.
Qual è il problema dell'essere umano nel ciclo?
La sfida principale è operativa: aggiungere la revisione umana introduce latenza, costi di personale e incoerenza se le linee guida non sono chiare. La ricerca sistematica sulle revisioni identifica scalabilità, calibrazione della fiducia e governance come le principali sfide di implementazione che i team devono risolvere.
Cosa significa "essere umano fuori dal ciclo"?
Umano-fuori-dal-ciclo (HOOTL) descrive un sistema completamente automatizzato in cui nessun essere umano è coinvolto nelle decisioni individuali. Massimizza la produttività e minimizza i costi, ma rimuove la rete di sicurezza e la traccia di audit richieste dalle applicazioni regolamentate o ad alto rischio.