Human in the Loop: A Practical Guide for Product and Engineering Teams
Human in the Loop: A Practical Guide for Product and Engineering Teams Human-in-the-loop (HITL) is an operating model where humans make or verify decisions that an automated system cannot safely or reliably own on its own.
Human in the Loop: A Practical Guide for Product and Engineering Teams
Human-in-the-loop (HITL) is an operating model where humans make or verify decisions that an automated system cannot safely or reliably own on its own. Stanford HAI frames the stronger version of this not as “humans are present” but as “humans are in charge” — retaining authority over high-stakes decisions rather than rubber-stamping model output. NIST’s AI risk management guidance reinforces that documented human oversight is a core control in high-risk AI deployments. Ridiculous Engineering builds these systems for product teams that need them to actually work in production, not just look good in an architecture diagram.
Use HITL when any of these signals are true:
-
The cost of a wrong automated decision is high (financial, legal, clinical, reputational).
-
Inputs are ambiguous or out-of-distribution often enough that model confidence is unreliable.
-
Regulatory or audit requirements demand a documented human decision point.
The core tradeoff is direct: HITL adds safety, auditability, and a continuous stream of labeled data for model improvement, but it also adds latency, staffing cost, and operational complexity that fully automated pipelines avoid.
Key Takeaways
Human-in-the-loop systems work when human judgment is treated as a planned operating mode with defined routing, clear interfaces, and feedback loops that feed model improvement.
| Point | Details |
|---|---|
| Start with Selective Escalation | Route only low-confidence or high-risk decisions to humans; automate the rest to control cost and latency. |
| Define the automation boundary in writing | A routing rule is more reliable than a vague guideline; document it before go-live and revisit it quarterly. |
| Track five core KPIs | Error rate, reviewer accuracy, mean review latency, escalation rate, and feedback reuse rate cover queue health and model improvement signal. |
| Run inter-rater agreement checks | Agreement below 80% on a shared calibration set signals that decision guidelines need more specificity before training data is trustworthy. |
| Ridiculous Engineering builds production HITL systems | For teams that need a designed, compliant, and measurable human-in-the-loop workflow, Ridiculous Engineering provides the engineering and architecture to get it done. |
Table of Contents
-
What does “human in the loop” actually mean, and how does it differ from related terms?
-
What are the core HITL design patterns, and which one should you start with?
-
What roles, workflows, and UI elements does a production HITL system need?
-
Which KPIs and quality controls should you track in a HITL system?
-
How do you implement HITL in production? A step-by-step checklist
-
What are the most common HITL anti-patterns, and how do you fix them?
-
Ridiculous Engineering builds HITL systems that work in production
¿Qué significa realmente “human in the loop” y en qué se diferencia de términos relacionados?
Según Stanford HAI, HITL se refiere a sistemas de IA donde la retroalimentación o intervención humana forma parte del funcionamiento normal: los humanos guían, corrigen errores o toman decisiones finales para mejorar la precisión y fiabilidad. Esa definición abarca mucho terreno, por lo que el campo utiliza tres variantes distintas para ser más preciso.
Human-in-the-loop (HITL): El sistema se detiene y espera una decisión humana antes de continuar. Un radiólogo que revisa un escáner marcado antes de registrar un diagnóstico es un ejemplo claro. La acción del humano forma parte de la transacción.
Human-on-the-loop (HOTL): El sistema actúa de forma autónoma, pero un humano supervisa el flujo de salida y puede intervenir. Un sistema de detección de fraude que bloquea transacciones automáticamente mientras un analista de riesgos observa la cola de alertas opera de esta manera. El humano puede anular, pero el sistema no espera.
Human-out-of-the-loop (HOOTL): Ningún humano participa en decisiones individuales. Un trabajo por lotes nocturno que recalifica un segmento de clientes y actualiza un modelo de recomendación se ejecuta sin ningún punto de contacto humano por registro.
Un modelo mental compacto para documentación y diagramas: HITL = pausar y aprobar; HOTL = supervisar e intervenir; HOOTL = control fantasma. Esa abreviatura suele funcionar bien en revisiones de diseño y planificación de sprints cuando los equipos debaten dónde trazar el límite de automatización.
También verás HITL llamado automatización asistida por humanos o un flujo de trabajo híbrido humano-IA en contextos de producto y operaciones. El significado es el mismo; el encuadre cambia según si el hablante enfatiza el lado de la IA o el lado humano de la colaboración.
¿Cuándo deberías adoptar un modelo operativo human-in-the-loop?
La decisión no es binaria. La mayoría de los sistemas de producción se sitúan en algún punto de un espectro, y la respuesta correcta depende de unas pocas señales concretas. Trabaja con ellas en este orden:
-
¿Una decisión incorrecta requiere corrección síncrona? Si un error descubierto después del hecho es demasiado costoso de remediar, necesitas un humano en la ruta de decisión antes de que se ejecute la acción.
-
¿Es obligatoria la auditabilidad? Las industrias reguladas (seguros, atención médica, servicios financieros, gobierno) a menudo requieren un punto de decisión humano documentado. La investigación de revisión sistemática confirma que los requisitos de gobernanza y cumplimiento son un motor principal de la adopción de HITL en dominios de alto riesgo.
-
¿Está calibrada de forma fiable la confianza del modelo? Si las estimaciones de incertidumbre de tu modelo no siguen las tasas de error reales, no puedes confiar en los umbrales de confianza para enrutar de forma segura sin respaldo humano.
-
¿Con qué frecuencia aparecen casos límite? Un modelo que maneja bien el 95% de las entradas pero falla gravemente en el 5% restante puede aún justificar HITL si ese 5% conlleva un riesgo desproporcionado.
-
¿Existen restricciones legales o regulatorias sobre decisiones automatizadas? Ciertas decisiones (denegaciones de crédito, elegibilidad de beneficios, recomendaciones clínicas) conllevan requisitos legales de responsabilidad humana en los Estados Unidos.
Tres ejemplos breves de producto que se corresponden con estas señales:
-
Triaje de reclamaciones de seguros: Alto riesgo financiero, pista de auditoría regulatoria requerida y entradas de casos límite (eventos de pérdida inusuales) son comunes. HITL en reclamaciones marcadas es tanto una decisión de producto como de cumplimiento.
-
Soporte de triaje médico: La investigación clínica muestra que HITL reduce el riesgo en dominios de alto riesgo al combinar sugerencias del modelo con juicio humano, mientras que los casos revisados generan datos etiquetados que alimentan la mejora del modelo con el tiempo.
-
Escalamiento de IA conversacional: Un chatbot de soporte que detecta respuestas de baja confianza y las enruta a un agente humano es un patrón HITL ligero. El riesgo por interacción es menor, pero el volumen es alto y la experiencia del cliente está en juego.
La compensación honesta: cada punto de contacto humano añade latencia y costo. Una cola de revisión que tarda cuatro horas en vaciarse es un retraso de cuatro horas en tu pipeline. Contratar un equipo de revisión es un gasto operativo recurrente. La respuesta a “¿vale la pena HITL?” es casi siempre “sí, para el subconjunto correcto de decisiones”, que es por lo que existen umbrales de confianza y escalamiento selectivo. Enruta solo las decisiones que el modelo genuinamente no puede asumir, y automatiza el resto. Ese es el avance de los patrones de diseño a continuación.
¿Cuáles son los patrones de diseño HITL principales y con cuál deberías empezar?
DistilledPatterns nombra los patrones canónicos y hace un punto que vale la pena repetir: tratar el trabajo humano como un modo operativo planificado, no como una solución temporal. Los patrones a continuación reflejan ese enfoque.
Escalada Selectiva es el patrón inicial recomendado para la mayoría de los equipos. El modelo maneja decisiones de alta confianza automáticamente y enruta casos de baja confianza o alto riesgo a un revisor humano. Es el punto de entrada de menor costo porque minimiza el volumen de revisión mientras protege las decisiones que más importan.
Autonomía Consciente del Riesgo extiende la escalada selectiva puntuando decisiones en una dimensión de riesgo (no solo confianza) y aplicando diferentes reglas de enrutamiento por nivel de riesgo. Un modelo de fraude de pagos podría aprobar automáticamente transacciones de bajo riesgo, poner en cola las de riesgo medio para revisión el mismo día y bloquear las de alto riesgo inmediatamente pendientes de aprobación humana.
Volante de Datos trata cada revisión humana como una señal de entrenamiento. Los casos revisados fluyen de vuelta al pipeline de entrenamiento del modelo, por lo que el modelo mejora con el tiempo y el volumen de decisiones escaladas se reduce. Este patrón requiere más infraestructura pero se compone en valor. Databricks señala que los umbrales de confianza y la puntuación de riesgo hacen que este tipo de escalada selectiva sea escalable en la práctica.
Entrega por Etapas aplica HITL en puntos de control definidos en un flujo de trabajo en lugar de en decisiones individuales. Un pipeline de procesamiento de documentos podría ejecutar extracción automatizada y luego pasar por un paso de revisión humana antes de comprometer los resultados a un sistema posterior. Es adecuado para flujos de trabajo por lotes donde la latencia por registro es menos crítica que la precisión en el punto de control.
Centrado en Tareas organiza el rol humano en torno a un tipo de tarea específico (anotación, verificación, manejo de excepciones) en lugar de en torno a la confianza del modelo. Común en pipelines de etiquetado y moderación de contenido.
| Patrón | Cuándo elegirlo | Perfil de latencia | Modelo de personal | Valor de retroalimentación |
|---|---|---|---|---|
| Escalada Selectiva | Punto de partida predeterminado; la confianza del modelo es medible | Baja para la mayoría de las decisiones; mayor para el subconjunto escalado | Pequeño equipo de revisión en guardia | Moderado |
| Autonomía Consciente del Riesgo | Los niveles de riesgo están bien definidos; el cumplimiento requiere respuesta por niveles | Variable por nivel | Revisores por niveles según experiencia | Moderado a alto |
| Volante de Datos | La mejora del modelo es un objetivo principal; la infraestructura existe | Añade latencia al pipeline | Equipo de anotación dedicado | Alto |
| Entrega por Etapas | Flujos de trabajo por lotes; la precisión en los puntos de control importa más que la velocidad | Mayor por lote | Revisores de puntos de control | Moderado |
| Centrado en tareas | Etiquetado o moderación de contenido a escala | Depende de la tarea | Grupo de anotadores de alto volumen | Alto para etiquetado |
Consejo profesional: Comience con escalado selectivo y un umbral de confianza conservador. Realice un seguimiento de la tasa de escalado semanalmente. A medida que el modelo mejore y confíe en su calibración, aumente el umbral de forma incremental. Mover el límite de automatización es un proceso deliberado y medido, no una decisión de arquitectura única. Los equipos que planifican esta transición desde el primer día construyen sistemas que resultan más baratos de operar con el tiempo.
¿Qué roles, flujos de trabajo y elementos de interfaz necesita un sistema HITL de producción?
El lado humano de un sistema HITL necesita tanta atención de diseño como el lado del modelo. Cuatro roles cubren la mayoría de las configuraciones de producción:
-
Anotador: Etiqueta datos brutos o salidas del modelo; sin autoridad sobre decisiones posteriores. Trabaja a volumen.
-
Revisor: Aprueba, rechaza o corrige decisiones del modelo dentro de un ámbito definido. Tiene autoridad de decisión para su nivel.
-
Experto en la materia (SME): Gestiona escalados que el revisor no puede resolver. Tiene autoridad sobre casos límite y excepciones de política.
-
Propietario de escalado: El punto de decisión humana final para casos de alto riesgo o disputados. A menudo un experto senior del dominio o un oficial de cumplimiento.
Los límites de autoridad claros importan. Un revisor que no sabe si puede anular una decisión del modelo o bien corregirá de menos (sellando) o escalará en exceso (creando un cuello de botella en el nivel SME).
Lista de verificación mínima de interfaz de revisión viable
Un buen diseño de interfaz HITL minimiza la carga cognitiva y proporciona las señales que los revisores necesitan para tomar decisiones seguras rápidamente. Como mínimo, una interfaz de revisión necesita:
-
Superficie de evidencia: La entrada, salida y puntuación de confianza del modelo, presentadas en contexto.
-
Acciones disponibles: Controles claros de aprobar/rechazar/escalar sin estados ambiguos.
-
Registro de decisiones: Cada acción con marca de tiempo y atribuida a un revisor nombrado.
-
Señales de explicabilidad: Una breve justificación de por qué el modelo marcó este caso (importancia de características, activación de reglas o desglose de confianza).
-
Controles de anulación: Una ruta para que el revisor corrija la salida del modelo, no solo aceptarla o rechazarla.
Operativamente, el sistema también necesita reglas de enrutamiento (qué casos van a qué nivel de revisor), objetivos de SLA (por ejemplo, latencia de revisión P95 inferior a cuatro horas para una cola determinada), planificación de capacidad para evitar acumulación de cola y un proceso de resolución de desacuerdos para casos donde los revisores entren en conflicto. Estos no son extras; son la diferencia entre un sistema HITL que mejora el producto y uno que se convierte en un backlog de tickets de soporte.
Consejo profesional: Escriba una guía de decisión de una página para cada rol de revisor antes del lanzamiento. Luego realice una pequeña verificación de acuerdo entre evaluadores: haga que dos revisores puntúen de forma independiente los mismos 20 casos y mida el acuerdo. Las decisiones humanas consistentes son lo que hace funcionar el volante de datos.
¿Qué KPIs y controles de calidad debería rastrear en un sistema HITL?
Las métricas de nivel superior que importan:
-
Tasa de error: La tasa a la que las decisiones revisadas se descubren posteriormente incorrectas. Esta es su señal principal de precisión.
-
Precisión/exactitud del revisor: Acuerdo por revisor con un conjunto de referencia estándar. Identifica desviaciones y brechas de formación.
-
Latencia media de revisión:Tiempo medio desde la llegada del caso hasta la decisión. Realiza un seguimiento de la salud de la cola y el cumplimiento del SLA.
-
Tasa de escalado: El porcentaje de decisiones totales enrutadas a revisión humana. Una tasa creciente puede indicar degradación del modelo; una tasa decreciente puede indicar que el umbral está listo para endurecerse.
-
Tasa de reutilización de comentarios: El porcentaje de casos revisados que vuelven a la formación del modelo. Una baja reutilización significa que el volante de datos no está girando.
Calcular el ROI del revisor es sencillo en concepto: comparar el coste de la operación de revisión (horas del revisor por coste cargado) con el valor de los errores prevenidos (reducción de la tasa de error por coste medio por error). En la práctica, la cifra de «coste por error» requiere aportación del dominio, pero incluso una estimación aproximada da a las partes interesadas un número defendible.
Un panel de KPI mínimo para un sistema HITL de producción debe incluir: volumen de escalado diario, latencia de revisión P50/P95, precisión del revisor por nivel, tendencia de la tasa de error (media móvil de 7 días) y tasa de reutilización de comentarios. Esos cinco widgets cubren la salud de la cola, la calidad del revisor y la señal de mejora del modelo en una vista.
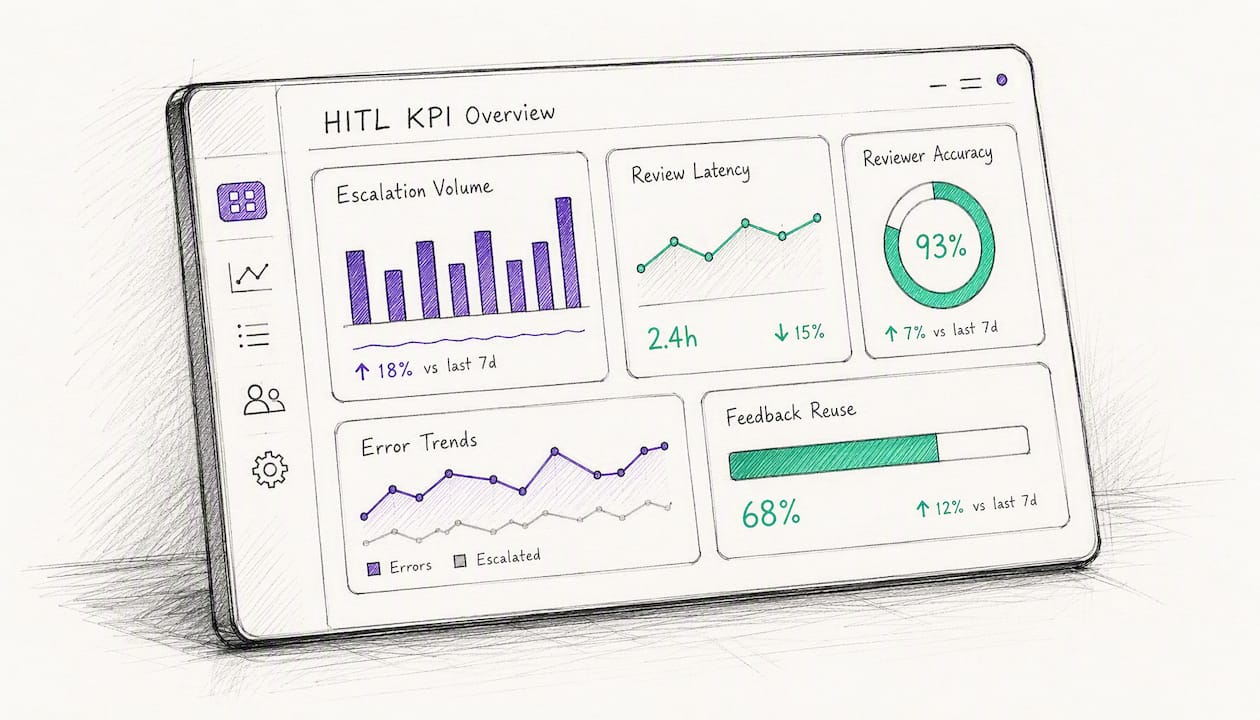
Controles de calidad para ejecutar continuamente: muestreo de auditoría periódico (extraer un conjunto aleatorio de casos revisados y volver a puntuarlos contra un estándar de oro), comprobaciones de acuerdo entre revisores en un conjunto de calibración compartido y control de versiones de etiquetado para saber qué versión del modelo corresponde a cada lote de formación.
Dos trampas de medición que merece la pena nombrar explícitamente. Primero, sesgo de selección en conjuntos escalados: los casos que revisan los humanos no son una muestra aleatoria de todas las decisiones. Las métricas de precisión calculadas solo en casos escalados sobrestimarán o subestimarán el rendimiento del modelo en la distribución completa. Segundo, deriva de métricas: a medida que el modelo mejora y la tasa de escalado cae, los casos escalados restantes se sesgan hacia casos límite más difíciles, haciendo que la precisión del revisor parezca disminuir incluso cuando nada ha cambiado en el comportamiento del revisor.
¿Cómo se implementa HITL en producción? Una lista de verificación paso a paso
-
Definir el alcance y los objetivos. Identificar qué decisiones necesitan supervisión humana, la tasa de error aceptable y el presupuesto de latencia. Documentar esto como una política de decisión de una página.
-
Elegir el patrón de diseño. Para la mayoría de los equipos que empiezan de cero, el Escalado Selectivo es el predeterminado correcto. Adecuar el patrón a la tolerancia de latencia y la capacidad de personal.
-
Definir el límite de automatización. Especificar exactamente qué entradas maneja el modelo de forma autónoma y cuáles desencadenan revisión humana. Escribir esto como una regla de enrutamiento, no una directriz vaga.
-
Diseñar la interfaz de revisión y la lógica de enrutamiento. Aplicar la lista de verificación mínima de interfaz anterior. Construir reglas de enrutamiento en el sistema de colas, no en el modelo.
-
Contratar y formar a los revisores. Escribir directrices de decisión antes de que comience la formación. Realizar una comprobación de acuerdo entre revisores antes del lanzamiento. Ver las consideraciones de estrategia de talento en IA y tecnología para estructurar roles de revisor junto a equipos de ingeniería.
-
Capturar y canalizar comentarios. Cada decisión revisada debe escribirse en un conjunto de datos etiquetado con ID del revisor, marca de tiempo, salida original del modelo y decisión final. Este es el material bruto para el volante de datos.
-
Instrumentar monitoreo y KPIs. Montar el panel de cinco widgets antes del lanzamiento. Establecer alertas sobre la tasa de escalado y la latencia P95.
-
Planificar aumentos de automatización por etapas. Programar una revisión trimestral de los umbrales de confianza. Definir los objetivos de métrica que justifican elevar el límite de automatización. Así es como la adopción pragmática de automatización acumula valor con el tiempo.
Pila tecnológica mínima por componente: Anotación y etiquetado (Label Studio, Scale AI o una interfaz personalizada ligera); cola y enrutamiento (una cola de tareas como Celery o un motor de flujo de trabajo como Temporal); registro de auditoría (almacén de eventos de solo añadir, JSON estructurado); pipeline de formación de modelos (MLflow, Kubeflow o un servicio gestionado); monitoreo y alertas (Prometheus más Grafana, o una plataforma de observabilidad gestionada).
Notas de cumplimiento y seguridad: Aplicar minimización de datos: los revisores solo deben ver los campos necesarios para tomar su decisión. La PII en colas de revisión necesita control de acceso y una política de retención documentada. Cifrar datos en reposo y en tránsito. Para industrias reguladas, mantener un registro de auditoría inmutable de cada decisión humana con la identidad del revisor y la marca de tiempo. Estos controles no son opcionales en implementaciones de atención médica, servicios financieros o gobierno.
En una participación de producción, un equipo que procesaba clasificación de documentos de alto volumen enrutó todos los casos de baja confianza a una cola de revisión de dos niveles. Después de varios meses alimentando casos revisados de vuelta al pipeline de formación, la tasa de escalado cayó significativamente y la latencia media de revisión mejoró notablemente. El modelo mejoró porque el trabajo humano se trató como datos de formación estructurados desde el primer día, no como un paso de corrección manual añadido después.
¿Cuáles son los anti-patrones HITL más comunes y cómo se solucionan?
-
Soluciones informales tardías de trabajo manual. Los ingenieros notan que el modelo es incorrecto y añaden silenciosamente un paso de corrección manual fuera del sistema formal. La solución: hacer que la revisión humana sea un componente de primera clase del flujo de trabajo desde el principio, con enrutamiento, registro y acuerdos de nivel de servicio. DistilledPatterns es explícito en que el trabajo humano debe ser un modo operativo planificado, no un parche.
-
Sistemas opacos que fuerzan revisiones de trámite. Los revisores aprueban todo porque la interfaz no les da contexto para discrepar. La solución: mostrar el razonamiento del modelo, la puntuación de confianza y la evidencia relevante. La investigación de interfaz de usuario confirma que la carga cognitiva y las señales de confianza afectan directamente la eficacia del revisor.
-
Colas sobrecargadas. La latencia de revisión aumenta, los acuerdos de nivel de servicio se rompen y el paso humano se convierte en el cuello de botella. La solución: monitorizar la latencia P95 diariamente, establecer alertas de capacidad antes de que las colas se saturen y elevar temporalmente el umbral de automatización cuando el volumen aumente.
-
Directrices de decisión poco claras. Los revisores toman decisiones inconsistentes, los datos de entrenamiento son ruidosos y el modelo no mejora. La solución: redactar directrices explícitas, realizar comprobaciones de acuerdo entre revisores trimestralmente y controlar versiones de las directrices junto con el modelo.
-
Ignorar la reutilización de comentarios. Los casos revisados quedan en una base de datos y nunca llegan al proceso de entrenamiento. La solución: instrumentar la tasa de reutilización de comentarios como un KPI de primera clase y asignar la propiedad del proceso a un ingeniero nombrado.
Cuándo retirar la revisión humana: Realice un seguimiento de la precisión del revisor frente a la precisión autónoma del modelo en el mismo tipo de decisión. Cuando la tasa de error del modelo en casos previamente escalados caiga dentro del margen de error del revisor, y la tasa de escalado sea lo suficientemente baja como para que el costo operativo supere la reducción de riesgo, el paso humano ha cumplido su función. Retírelo deliberadamente, documente la decisión y conserve el registro de auditoría.
Lecturas adicionales y fuentes primarias
Estas son las fuentes primarias utilizadas para esta guía. Cada una cubre una dimensión distinta de HITL que vale la pena leer completa.
-
Stanford HAI — ¿Qué es Human-in-the-Loop? Definición autorizada y el marco de «humanos al mando» que distingue la supervisión genuina de la presencia pasiva.
-
Databricks — ¿Qué es Human-in-the-Loop (HITL)? Cobertura práctica de umbrales de confianza, puntuación de riesgo y cómo HITL aparece a lo largo del ciclo de vida de la IA.
-
DistilledPatterns — Human-in-the-Loop Patrones de diseño nombrados, anti-patrones operativos y el argumento para tratar el trabajo humano como un modo de producción planificado.
-
MDPI Entropy — Revisión sistemática de conceptos, métodos y aplicaciones de HITL Taxonomía académica de variantes de HITL por ubicación del bucle, granularidad de interacción y características temporales; cubre desafíos de escalabilidad y gobernanza.
-
NCBI — HITL en dominios clínicos y de alto riesgo Evidencia sobre reducción de riesgo, generación de datos etiquetados y gestión de costos operativos en implementaciones sanitarias.
-
IJISAE — Diseño de interfaz de usuario Human-in-the-Loop Investigación sobre carga cognitiva, fidelidad semántica y señales de confianza en interfaces de revisión para co-creación con IA generativa.
Ridiculous Engineering construye sistemas HITL que funcionan en producción
La mayoría de los equipos que acuden a nosotros ya han intentado acoplar la revisión humana a un proceso existente y han descubierto que no escala. La cola se llena, las directrices son vagas, los comentarios nunca llegan al modelo y todo se convierte en un proceso manual con un logotipo de IA.
Ridiculous Engineering diseña software personalizado impulsado por IA donde la capa de supervisión humana es un componente diseñado, no una ocurrencia tardía. Eso significa una interfaz de revisión construida para la carga cognitiva real del revisor, lógica de enrutamiento que mantiene las colas despejadas, registro de auditoría que cumple con los requisitos de cumplimiento y un proceso de comentarios que mejora el modelo de manera medible con el tiempo. Trabajamos con equipos de producto e ingeniería en startups, empresas y organizaciones gubernamentales en todo Colorado y a nivel global. Si está listo para construir un sistema HITL que resista la carga de producción, inicie una conversación con nuestro equipo.
Fuentes
Preguntas frecuentes
¿Qué es la teoría human-in-the-loop?
La teoría de la intervención humana sostiene que los sistemas de IA funcionan de manera más fiable y segura cuando los humanos conservan la autoridad sobre decisiones que el modelo no puede asumir con suficiente confianza. Stanford HAI lo plantea como «humanos al mando» en lugar de meramente «humanos presentes».
¿Qué significa mantener al humano en el circuito?
Mantener al humano en el circuito significa enrutar decisiones específicas a un revisor humano antes de que el sistema actúe, en lugar de dejar que el modelo decida de forma autónoma. En la práctica, esto implica umbrales de confianza, colas de revisión y registro documentado de decisiones para que cada acción humana sea trazable.
¿Cuál es el problema de la intervención humana en el circuito?
El desafío principal es operativo: añadir revisión humana introduce latencia, coste de personal e inconsistencia si las directrices no son claras. La investigación de revisión sistemática identifica la escalabilidad, la calibración de la confianza y la gobernanza como los principales desafíos de implementación que los equipos deben resolver.
¿Qué significa «humano fuera del circuito»?
Humano fuera del circuito (HOOTL) describe un sistema totalmente automatizado donde ningún humano participa en decisiones individuales. Maximiza el rendimiento y minimiza el coste, pero elimina la red de seguridad y el registro de auditoría que requieren las aplicaciones reguladas o de alto riesgo.