Human in the Loop: Ein praktischer Leitfaden für Produkt- und Engineering-Teams
Human in the Loop: Ein praktischer Leitfaden für Produkt- und Engineering-Teams Human-in-the-Loop (HITL) ist ein Betriebsmodell, bei dem Menschen Entscheidungen treffen oder verifizieren, die ein automatisiertes System nicht sicher oder zuverlässig allein übernehmen kann.
Human in the Loop: Ein praktischer Leitfaden für Produkt- und Engineering-Teams
Human-in-the-Loop (HITL) ist ein Betriebsmodell, bei dem Menschen Entscheidungen treffen oder verifizieren, die ein automatisiertes System nicht sicher oder zuverlässig allein übernehmen kann. Stanford HAI rahmt die stärkere Version davon nicht als „Menschen sind anwesend“, sondern als „Menschen haben das Sagen“ – sie behalten die Autorität über Entscheidungen mit hohem Risiko, anstatt Modellausgaben nur abzustempeln. Die KI-Risikomanagement-Leitlinien von NIST verstärken, dass dokumentierte menschliche Aufsicht eine Kernkontrolle bei KI-Bereitstellungen mit hohem Risiko ist. Ridiculous Engineering baut diese Systeme für Produktteams, die sie in der Produktion tatsächlich funktionieren lassen müssen, nicht nur gut in einem Architekturdiagramm aussehen lassen.
Verwenden Sie HITL, wenn eines dieser Signale zutrifft:
-
Die Kosten einer falschen automatisierten Entscheidung sind hoch (finanziell, rechtlich, klinisch, reputationsbezogen).
-
Eingaben sind mehrdeutig oder außerhalb der Verteilung oft genug, dass die Modellkonfidenz unzuverlässig ist.
-
Regulatorische oder Prüfanforderungen verlangen einen dokumentierten menschlichen Entscheidungspunkt.
Der Kernkompromiss ist direkt: HITL fügt Sicherheit, Prüfbarkeit und einen kontinuierlichen Strom gekennzeichneter Daten zur Modellverbesserung hinzu, fügt aber auch Latenz, Personalkosten und betriebliche Komplexität hinzu, die vollautomatisierte Pipelines vermeiden.
Wichtige Erkenntnisse
Human-in-the-Loop-Systeme funktionieren, wenn menschliches Urteilsvermögen als geplanter Betriebsmodus mit definiertem Routing, klaren Schnittstellen und Feedback-Schleifen behandelt wird, die die Modellverbesserung speisen.
| Punkt | Details |
|---|---|
| Beginnen Sie mit selektiver Eskalation | Leiten Sie nur Entscheidungen mit niedriger Konfidenz oder hohem Risiko an Menschen weiter; automatisieren Sie den Rest, um Kosten und Latenz zu kontrollieren. |
| Definieren Sie die Automatisierungsgrenze schriftlich | Eine Routing-Regel ist zuverlässiger als eine vage Richtlinie; dokumentieren Sie sie vor dem Start und überprüfen Sie sie vierteljährlich. |
| Verfolgen Sie fünf Kern-KPIs | Fehlerrate, Prüfergenauigkeit, mittlere Prüflatenz, Eskalationsrate und Feedback-Wiederverwendungsrate decken die Warteschlangengesundheit und das Modellverbesserungssignal ab. |
| Führen Sie Inter-Rater-Übereinstimmungsprüfungen durch | Eine Übereinstimmung unter 80 % bei einem gemeinsamen Kalibrierungssatz signalisiert, dass Entscheidungsrichtlinien mehr Spezifität benötigen, bevor Trainingsdaten vertrauenswürdig sind. |
| Ridiculous Engineering baut Produktions-HITL-Systeme | Für Teams, die einen gestalteten, konformen und messbaren Human-in-the-Loop-Workflow benötigen, bietet Ridiculous Engineering die Technik und Architektur, um es umzusetzen. |
Inhaltsverzeichnis
-
Was bedeutet „Human in the Loop“ tatsächlich und wie unterscheidet es sich von verwandten Begriffen?
-
Wann sollten Sie ein Human-in-the-Loop-Betriebsmodell übernehmen?
-
Was sind die Kern-HITL-Entwurfsmuster und mit welchem sollten Sie beginnen?
-
Welche Rollen, Workflows und UI-Elemente benötigt ein Produktions-HITL-System?
-
Welche KPIs und Qualitätskontrollen sollten Sie in einem HITL-System verfolgen?
-
Wie implementieren Sie HITL in der Produktion? Eine Schritt-für-Schritt-Checkliste
-
Was sind die häufigsten HITL-Anti-Patterns und wie beheben Sie sie?
-
Ridiculous Engineering baut HITL-Systeme, die in der Produktion funktionieren
Was bedeutet „Human in the Loop“ eigentlich und wie unterscheidet es sich von verwandten Begriffen?
Laut Stanford HAI bezieht sich HITL auf KI-Systeme, bei denen menschliches Feedback oder Eingreifen Teil des normalen Betriebs ist – Menschen leiten an, korrigieren Fehler oder treffen endgültige Entscheidungen, um Genauigkeit und Zuverlässigkeit zu verbessern. Diese Definition deckt viel ab, daher verwendet das Feld drei verschiedene Varianten, um präziser zu sein.
Human-in-the-Loop (HITL): Das System pausiert und wartet auf eine menschliche Entscheidung, bevor es fortfährt. Ein Radiologe, der einen markierten Scan überprüft, bevor eine Diagnose aufgezeichnet wird, ist ein klares Beispiel. Die Handlung des Menschen ist Teil der Transaktion.
Human-on-the-Loop (HOTL): Das System handelt autonom, aber ein Mensch überwacht den Ausgabestrom und kann eingreifen. Ein Betrugserkennungssystem, das Transaktionen automatisch blockiert, während ein Risikoanalyst die Warnwarteschlange beobachtet, funktioniert so. Der Mensch kann überschreiben, aber das System wartet nicht.
Human-out-of-the-Loop (HOOTL): Kein Mensch ist an einzelnen Entscheidungen beteiligt. Ein nächtlicher Stapeljob, der ein Kundensegment neu bewertet und ein Empfehlungsmodell aktualisiert, läuft ohne menschlichen Kontaktpunkt pro Datensatz.
Ein kompaktes mentales Modell für Dokumentation und Diagramme: HITL = Pause-und-Genehmigen; HOTL = Überwachen-und-Eingreifen; HOOTL = Geistersteuerung. Diese Kurzform kommt in Design-Reviews und Sprint-Planungen gut an, wenn Teams darüber diskutieren, wo die Automatisierungsgrenze gezogen werden soll.
Sie werden auch sehen, dass HITL als menschunterstützte Automatisierung oder ein hybrider Mensch-KI-Workflow in Produkt- und Betriebskontexten bezeichnet wird. Die Bedeutung ist dieselbe; die Rahmung verschiebt sich je nachdem, ob der Sprecher die KI-Seite oder die menschliche Seite der Zusammenarbeit betont.
Wann sollten Sie ein Human-in-the-Loop-Betriebsmodell übernehmen?
Die Entscheidung ist nicht binär. Die meisten Produktionssysteme liegen irgendwo auf einem Spektrum, und die richtige Antwort hängt von einer Handvoll konkreter Signale ab. Gehen Sie diese in Reihenfolge durch:
-
Erfordert eine falsche Entscheidung synchrone Korrektur? Wenn ein nachträglich entdeckter Fehler zu kostspielig zu beheben ist, benötigen Sie einen Menschen im Entscheidungspfad, bevor die Aktion ausgelöst wird.
-
Ist Prüfbarkeit erforderlich? Regulierte Branchen – Versicherungen, Gesundheitswesen, Finanzdienstleistungen, Regierung – verlangen oft einen dokumentierten menschlichen Entscheidungspunkt. Systematische Überprüfungsforschung bestätigt, dass Governance- und Compliance-Anforderungen ein Haupttreiber für die HITL-Einführung in Hochrisikobereichen sind.
-
Ist die Modellkonfidenz zuverlässig kalibriert? Wenn die Unsicherheitsschätzungen Ihres Modells nicht den tatsächlichen Fehlerraten entsprechen, können Sie Konfidenzschwellen nicht vertrauen, um sicher ohne menschliche Unterstützung zu leiten.
-
Wie häufig sind Randfälle? Ein Modell, das 95 % der Eingaben gut verarbeitet, aber bei den restlichen 5 % versagt, kann HITL dennoch rechtfertigen, wenn diese 5 % ein unverhältnismäßiges Risiko tragen.
-
Gibt es rechtliche oder regulatorische Einschränkungen für automatisierte Entscheidungen? Bestimmte Entscheidungen – Kreditablehnungen, Leistungsberechtigung, klinische Empfehlungen – tragen rechtliche Anforderungen an menschliche Verantwortlichkeit in den Vereinigten Staaten.
Drei kurze Produktbeispiele, die diesen Signalen entsprechen:
-
Versicherungsanspruchs-Triage: Hohe finanzielle Einsätze, regulatorische Prüfpfade und Randfall-Eingaben (ungewöhnliche Schadensereignisse) sind üblich. HITL bei markierten Ansprüchen ist sowohl eine Produkt- als auch eine Compliance-Entscheidung.
-
Medizinische Triage-Unterstützung: Klinische Forschung zeigt, dass HITL Risiken in Hochrisikobereichen reduziert, indem Modellvorschläge mit menschlichem Urteil kombiniert werden, während die überprüften Fälle gelabelte Daten erzeugen, die die Modellverbesserung im Laufe der Zeit speisen.
-
Konversations-KI-Eskalation: Ein Support-Chatbot, der Antworten mit geringer Konfidenz erkennt und an einen menschlichen Agenten weiterleitet, ist ein leichtgewichtiges HITL-Muster. Die Einsätze pro Interaktion sind geringer, aber das Volumen ist hoch und die Kundenerfahrung steht auf dem Spiel.
Der ehrliche Kompromiss: Jeder menschliche Kontaktpunkt fügt Latenz und Kosten hinzu. Eine Überprüfungswarteschlange, die vier Stunden zum Abarbeiten benötigt, ist eine vierstündige Verzögerung in Ihrer Pipeline. Die Besetzung eines Überprüfungsteams ist eine wiederkehrende Betriebsausgabe. Die Antwort auf „Ist HITL es wert?“ ist fast immer „Ja, für die richtige Teilmenge von Entscheidungen“ – weshalb Konfidenzschwellen und selektive Eskalation existieren. Leiten Sie nur die Entscheidungen weiter, die das Modell wirklich nicht übernehmen kann, und automatisieren Sie den Rest. Das ist die Vorschau der Designmuster unten.
Was sind die zentralen HITL-Designmuster und mit welchem sollte man beginnen?
DistilledPatterns benennt die kanonischen Muster und macht einen Punkt, der wiederholt werden sollte: Behandeln Sie menschliche Arbeit als geplanten Betriebsmodus, nicht als vorübergehende Notlösung. Die folgenden Muster spiegeln diese Rahmung wider.
Selektive Eskalation ist das empfohlene Startmuster für die meisten Teams. Das Modell verarbeitet Entscheidungen mit hoher Konfidenz automatisch und leitet Fälle mit niedriger Konfidenz oder hohem Risiko an einen menschlichen Prüfer weiter. Es ist der kostengünstigste Einstiegspunkt, da es das Prüfvolumen minimiert und gleichzeitig die wichtigsten Entscheidungen schützt.
Risikobewusste Autonomie erweitert die selektive Eskalation, indem Entscheidungen auf einer Risikodimension (nicht nur Konfidenz) bewertet und unterschiedliche Weiterleitungsregeln pro Risikostufe angewendet werden. Ein Zahlungsbetrugsmodell könnte Transaktionen mit niedrigem Risiko automatisch genehmigen, mittlere Risiken für die Prüfung am selben Tag in die Warteschlange stellen und hohe Risiken sofort blockieren, bis eine menschliche Freigabe erfolgt.
Daten-Flywheel behandelt jede menschliche Prüfung als Trainingssignal. Geprüfte Fälle fließen zurück in die Trainingspipeline des Modells, sodass sich das Modell im Laufe der Zeit verbessert und das Volumen eskalierter Entscheidungen sinkt. Dieses Muster erfordert mehr Infrastruktur, bietet aber einen wachsenden Wert. Databricks stellt fest, dass Konfidenzschwellen und Risikobewertung diese Art der selektiven Eskalation in der Praxis skalierbar machen.
Stufenweise Lieferung wendet HITL an definierten Kontrollpunkten in einem Workflow an, nicht bei einzelnen Entscheidungen. Eine Dokumentverarbeitungspipeline könnte automatische Extraktion durchführen und dann vor der Übergabe der Ergebnisse an ein nachgelagertes System an einem menschlichen Prüfschritt festhalten. Es eignet sich gut für Batch-Workflows, bei denen die Latenz pro Datensatz weniger kritisch ist als die Genauigkeit am Kontrollpunkt.
Aufgabenorientiert organisiert die menschliche Rolle um einen spezifischen Aufgabentyp (Annotation, Verifizierung, Ausnahmebehandlung) und nicht um die Konfidenz des Modells. Üblich in Kennzeichnungspipelines und Inhaltsmoderation.
| Muster | Wann man es wählt | Latenzprofil | Personalmodell | Feedbackwert |
|---|---|---|---|---|
| Selektive Eskalation | Standardstartpunkt; Modellkonfidenz ist messbar | Niedrig für die meisten Entscheidungen; höher für eskalierte Teilmenge | Kleines Bereitschaftsprüfungsteam | Mäßig |
| Risikobewusste Autonomie | Risikostufen sind klar definiert; Compliance erfordert gestufte Reaktion | Variabel nach Stufe | Gestufte Prüfer nach Fachwissen | Mäßig bis hoch |
| Daten-Flywheel | Modellverbesserung ist ein primäres Ziel; Infrastruktur vorhanden | Fügt Pipeline-Latenz hinzu | Dediziertes Annotationsteam | Hoch |
| Stufenweise Lieferung | Batch-Workflows; Genauigkeit an Kontrollpunkten wichtiger als Geschwindigkeit | Höher pro Batch | Kontrollpunktprüfer | Mäßig |
| Aufgabenorientiert | Beschriftung oder Inhaltsmoderation in großem Maßstab | Hängt von der Aufgabe ab | Hochvolumiger Annotator-Pool | Hoch für Beschriftung |
Profi-Tipp: Beginnen Sie mit selektiver Eskalation und einer konservativen Konfidenzschwelle. Verfolgen Sie die Eskalationsrate wöchentlich. Wenn sich das Modell verbessert und Sie Vertrauen in seine Kalibrierung aufbauen, erhöhen Sie die Schwelle schrittweise. Die Verschiebung der Automatisierungsgrenze ist ein bewusster, messbarer Prozess – keine einmalige Architekturentscheidung. Teams, die von Tag eins für diesen Übergang planen, bauen Systeme auf, die im Laufe der Zeit günstiger im Betrieb werden.
Welche Rollen, Workflows und UI-Elemente benötigt ein Produktions-HITL-System?
Die menschliche Seite eines HITL-Systems benötigt ebenso viel Designaufmerksamkeit wie die Modellseite. Vier Rollen decken die meisten Produktionskonfigurationen ab:
-
Annotator: Beschriftet Rohdaten oder Modellausgaben; keine Autorität über nachgelagerte Entscheidungen. Arbeitet in hohem Volumen.
-
Prüfer: Genehmigt, lehnt ab oder korrigiert Modellentscheidungen innerhalb eines definierten Rahmens. Hat Entscheidungsautorität für seine Stufe.
-
Fachexperte (SME): Behandelt Eskalationen, die der Prüfer nicht lösen kann. Hat Autorität über Randfälle und Richtlinienausnahmen.
-
Eskalationsverantwortlicher: Der letzte menschliche Entscheidungspunkt für risikoreiche oder umstrittene Fälle. Oft ein leitender Domänenexperte oder Compliance-Beauftragter.
Klare Autoritätsgrenzen sind wichtig. Ein Prüfer, der nicht weiß, ob er eine Modellentscheidung überschreiben kann, wird entweder unterkorrigieren (Abstempeln) oder übereskalieren (einen Engpass auf der SME-Stufe erzeugen).
Checkliste für die minimale funktionsfähige Überprüfungs-UI
Gutes HITL-UI-Design minimiert kognitive Belastung und bietet die Signale, die Prüfer benötigen, um schnell sichere Entscheidungen zu treffen. Mindestens benötigt eine Überprüfungsschnittstelle:
-
Evidenzoberfläche: Die Eingabe, Ausgabe und Konfidenzpunktzahl des Modells, im Kontext dargestellt.
-
Aktionsmöglichkeiten: Klare Genehmigen/Ablehnen/Eskalieren-Steuerungen ohne mehrdeutige Zustände.
-
Entscheidungsprotokollierung: Jede Aktion mit Zeitstempel und einem benannten Prüfer zugeordnet.
-
Erklärbarkeitssignale: Eine kurze Begründung, warum das Modell diesen Fall markiert hat (Feature-Wichtigkeit, Regelauslöser oder Konfidenzaufschlüsselung).
-
Überschreibungssteuerungen: Ein Pfad für den Prüfer, die Modellausgabe zu korrigieren, nicht nur zu akzeptieren oder abzulehnen.
Operativ benötigt das System auch Routing-Regeln (welche Fälle zu welcher Prüferstufe gehen), SLA-Ziele (z. B. P95-Überprüfungslatenz unter vier Stunden für eine gegebene Warteschlange), Kapazitätsplanung, um Warteschlangenaufbau zu vermeiden, und einen Prozess zur Lösung von Meinungsverschiedenheiten für Fälle, in denen Prüfer kollidieren. Diese sind keine Nice-to-haves; sie sind der Unterschied zwischen einem HITL-System, das das Produkt verbessert, und einem, das zu einem Support-Ticket-Rückstand wird.
Profi-Tipp: Schreiben Sie eine einseitige Entscheidungsrichtlinie für jede Prüferrolle, bevor Sie starten. Führen Sie dann eine kleine Inter-Rater-Übereinstimmungsprüfung durch: Lassen Sie zwei Prüfer unabhängig dieselben 20 Fälle bewerten und messen Sie die Übereinstimmung. Konsistente menschliche Entscheidungen sind das, was das Daten-Schwungrad funktionieren lässt.
Welche KPIs und Qualitätskontrollen sollten Sie in einem HITL-System verfolgen?
Die Top-Level-Metriken, die wichtig sind:
-
Fehlerrate: Die Rate, mit der überprüfte Entscheidungen später als falsch befunden werden. Dies ist Ihr primäres Genauigkeitssignal.
-
Prüfergenauigkeit/-präzision: Übereinstimmung pro Prüfer mit einem Goldstandard-Satz. Identifiziert Drift und Schulungslücken.
-
Mittlere Überprüfungslatenz:Durchschnittliche Zeit von Eingang des Falls bis zur Entscheidung. Verfolgt die Warteschlangengesundheit und SLA-Einhaltung.
-
Eskalationsrate: Der Prozentsatz aller Entscheidungen, die zur menschlichen Überprüfung weitergeleitet werden. Eine steigende Rate kann auf eine Modellverschlechterung hinweisen; eine fallende Rate kann darauf hindeuten, dass der Schwellenwert bereit ist, angezogen zu werden.
-
Feedback-Wiederverwendungsrate: Der Prozentsatz überprüfter Fälle, die zurück in das Modelltraining fließen. Geringe Wiederverwendung bedeutet, dass das Daten-Schwungrad sich nicht dreht.
Die Berechnung des Reviewer-ROI ist konzeptionell einfach: Vergleichen Sie die Kosten der Überprüfungsoperation (Reviewer-Stunden mal belastete Kosten) mit dem Wert verhinderter Fehler (Fehlerratenreduktion mal durchschnittliche Kosten pro Fehler). In der Praxis erfordert die Zahl „Kosten pro Fehler“ fachlichen Input, aber selbst eine grobe Schätzung gibt den Beteiligten eine vertretbare Zahl.
Ein minimales KPI-Dashboard für ein Produktions-HITL-System sollte enthalten: tägliches Eskalationsvolumen, P50/P95-Überprüfungslatenz, Reviewer-Genauigkeit nach Stufe, Fehlerratentrend (7-Tage-Rolling) und Feedback-Wiederverwendungsrate. Diese fünf Widgets decken Warteschlangengesundheit, Reviewer-Qualität und Modellverbesserungssignal in einer Ansicht ab.
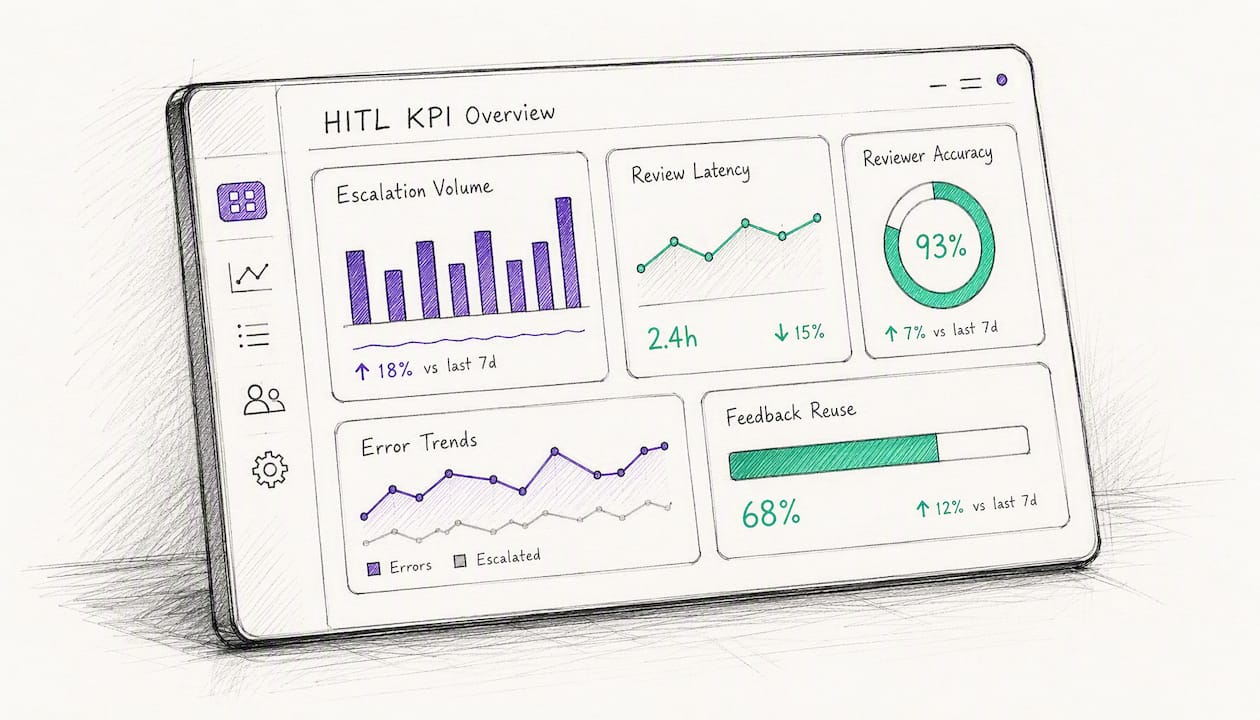
Qualitätskontrollen, die kontinuierlich ausgeführt werden sollten: periodische Audit-Stichproben (eine zufällige Auswahl überprüfter Fälle ziehen und gegen einen Goldstandard neu bewerten), Inter-Rater-Übereinstimmungsprüfungen an einem gemeinsamen Kalibrierungssatz und Kennzeichnungsversionskontrolle, damit Sie wissen, welche Modellversion jedem Trainingsbatch entspricht.
Zwei Messfallen, die explizit genannt werden sollten. Erstens: Auswahlverzerrung in eskalierten Sätzen: Die Fälle, die Menschen überprüfen, sind keine zufällige Stichprobe aller Entscheidungen. Genauigkeitsmetriken, die nur auf eskalierten Fällen berechnet werden, überschätzen oder unterschätzen die Modellleistung auf der gesamten Verteilung. Zweitens: Metrikdrift: Wenn sich das Modell verbessert und die Eskalationsrate sinkt, neigen die verbleibenden eskalierten Fälle zu härteren Randfällen, wodurch die Reviewer-Genauigkeit zu sinken scheint, selbst wenn sich nichts am Reviewer-Verhalten geändert hat.
Wie implementieren Sie HITL in der Produktion? Eine Schritt-für-Schritt-Checkliste
-
Umfang und Ziele definieren. Identifizieren Sie, welche Entscheidungen menschliche Aufsicht benötigen, die akzeptable Fehlerrate und das Latenzbudget. Dokumentieren Sie dies als einseitige Entscheidungsrichtlinie.
-
Wählen Sie Ihr Designmuster. Für die meisten Teams, die neu starten, ist Selective Escalation der richtige Standard. Passen Sie das Muster an Ihre Latenztoleranz und Personalausstattung an.
-
Definieren Sie die Automatisierungsgrenze. Geben Sie genau an, welche Eingaben das Modell autonom verarbeitet und welche eine menschliche Überprüfung auslösen. Schreiben Sie dies als Routing-Regel, nicht als vage Richtlinie.
-
Gestalten Sie die Überprüfungs-UI und Routing-Logik. Wenden Sie die minimale UI-Checkliste oben an. Bauen Sie Routing-Regeln in das Warteschlangensystem ein, nicht in das Modell.
-
Stellen Sie Reviewer ein und schulen Sie sie. Schreiben Sie Entscheidungsrichtlinien, bevor das Training beginnt. Führen Sie eine Inter-Rater-Übereinstimmungsprüfung vor dem Go-Live durch. Siehe die KI- und Tech-Talentstrategie Überlegungen zur Strukturierung von Reviewer-Rollen neben Engineering-Teams.
-
Erfassen und leiten Sie Feedback weiter. Jede überprüfte Entscheidung sollte in einen gekennzeichneten Datensatz mit Reviewer-ID, Zeitstempel, ursprünglicher Modellausgabe und endgültiger Entscheidung geschrieben werden. Dies ist das Rohmaterial für das Daten-Schwungrad.
-
Instrumentieren Sie Überwachung und KPIs. Richten Sie das Fünf-Widget-Dashboard vor dem Start ein. Setzen Sie Warnungen für Eskalationsrate und P95-Latenz.
-
Planen Sie stufenweise Automatisierungserhöhungen. Planen Sie eine vierteljährliche Überprüfung der Konfidenzschwellenwerte. Definieren Sie die Metrikziele, die eine Erhöhung der Automatisierungsgrenze rechtfertigen. So pragmatische Automatisierungsadoption schafft über die Zeit Wert.
Minimaler Tech-Stack nach Komponente: Annotation und Kennzeichnung (Label Studio, Scale AI oder eine leichte benutzerdefinierte UI); Warteschlange und Routing (eine Aufgabenwarteschlange wie Celery oder eine Workflow-Engine wie Temporal); Audit-Protokollierung (append-only Event-Store, strukturiertes JSON); Modelltraining-Pipeline (MLflow, Kubeflow oder ein verwalteter Dienst); Überwachung und Warnung (Prometheus plus Grafana oder eine verwaltete Observability-Plattform).
Compliance- und Sicherheitshinweise: Wenden Sie Datenminimierung an – Reviewer sollten nur die Felder sehen, die für ihre Entscheidung erforderlich sind. PII in Überprüfungswarteschlangen benötigt Zugriffskontrolle und eine dokumentierte Aufbewahrungsrichtlinie. Verschlüsseln Sie Daten im Ruhezustand und während der Übertragung. Für regulierte Branchen pflegen Sie ein unveränderliches Audit-Protokoll jeder menschlichen Entscheidung mit der Identität des Reviewers und einem Zeitstempel. Diese Kontrollen sind im Gesundheitswesen, Finanzdienstleistungen oder Regierungsbereitstellungen nicht optional.
In einem Produktionseinsatz leitete ein Team, das hochvolumige Dokumentklassifizierung verarbeitete, alle Fälle mit niedriger Konfidenz an eine zweistufige Überprüfungswarteschlange weiter. Nach mehreren Monaten, in denen überprüfte Fälle zurück in die Trainingspipeline gespeist wurden, sank die Eskalationsrate erheblich und die mittlere Überprüfungslatenz verbesserte sich spürbar. Das Modell verbesserte sich, weil die menschliche Arbeit von Tag eins als strukturierte Trainingsdaten behandelt wurde, nicht als manueller Korrekturschritt, der nachträglich hinzugefügt wurde.
Was sind die häufigsten HITL-Anti-Patterns und wie beheben Sie sie?
-
Späte informelle menschliche Workarounds. Ingenieure bemerken, dass das Modell falsch ist, und fügen stillschweigend einen manuellen Korrekturschritt außerhalb des formalen Systems hinzu. Die Lösung: Machen Sie die menschliche Überprüfung von Anfang an zu einer erstklassigen Workflow-Komponente mit Routing, Protokollierung und SLAs. DistilledPatterns ist explizit der Ansicht, dass menschliche Arbeit ein geplanter Betriebsmodus sein sollte, kein Patch.
-
Undurchsichtige Systeme, die Abnick-Überprüfungen erzwingen. Prüfer genehmigen alles, weil die Oberfläche ihnen keinen Kontext zum Widerspruch bietet. Die Lösung: Zeigen Sie die Begründung des Modells, den Konfidenzwert und relevante Beweise an. Die UI-Forschung bestätigt, dass kognitive Last und Vertrauenssignale die Effektivität der Prüfer direkt beeinflussen.
-
Überlastete Warteschlangen. Die Prüflatenz steigt, SLAs brechen, und der menschliche Schritt wird zum Engpass. Die Lösung: Überwachen Sie die P95-Latenz täglich, setzen Sie Kapazitätswarnungen, bevor Warteschlangen gesättigt sind, und erhöhen Sie die Automatisierungsschwelle vorübergehend bei Volumenspitzen.
-
Unklare Entscheidungsrichtlinien. Prüfer treffen inkonsistente Entscheidungen, die Trainingsdaten sind verrauscht, und das Modell verbessert sich nicht. Die Lösung: Schreiben Sie explizite Richtlinien, führen Sie vierteljährlich Inter-Rater-Übereinstimmungsprüfungen durch und versionieren Sie die Richtlinien zusammen mit dem Modell.
-
Ignorieren der Feedback-Wiederverwendung. Überprüfte Fälle liegen in einer Datenbank und erreichen nie die Trainingspipeline. Die Lösung: Instrumentieren Sie die Feedback-Wiederverwendungsrate als erstklassigen KPI und weisen Sie die Verantwortung für die Pipeline einem benannten Ingenieur zu.
Wann die menschliche Überprüfung eingestellt werden sollte: Verfolgen Sie die Genauigkeit der Prüfer gegen die autonome Genauigkeit des Modells für denselben Entscheidungstyp. Wenn die Fehlerrate des Modells bei zuvor eskalierten Fällen innerhalb der Fehlermarge der Prüfer fällt und die Eskalationsrate niedrig genug ist, dass die Betriebskosten die Risikominderung überwiegen, hat der menschliche Schritt seine Aufgabe erfüllt. Stellen Sie ihn bewusst ein, dokumentieren Sie die Entscheidung und führen Sie das Audit-Log.
Weiterführende Literatur und Primärquellen
Dies sind die Primärquellen für diesen Leitfaden. Jede deckt eine eigene Dimension von HITL ab, die es wert ist, vollständig gelesen zu werden.
-
Stanford HAI — Was ist Human-in-the-Loop? Autoritative Definition und der Rahmen „Menschen verantwortlich“, der echte Aufsicht von passiver Präsenz unterscheidet.
-
Databricks — Was ist Human-in-the-Loop (HITL)? Praktische Abdeckung von Konfidenzschwellen, Risikobewertung und wie HITL im gesamten KI-Lebenszyklus erscheint.
-
DistilledPatterns — Human-in-the-Loop Benannte Designmuster, operative Anti-Muster und das Argument, menschliche Arbeit als geplanten Produktionsmodus zu behandeln.
-
MDPI Entropy — Systematische Überprüfung von HITL-Konzepten, -Methoden und -Anwendungen Akademische Taxonomie von HITL-Varianten nach Schleifenplatzierung, Interaktionsgranularität und zeitlichen Merkmalen; deckt Skalierbarkeits- und Governance-Herausforderungen ab.
-
NCBI — HITL in klinischen und risikoreichen Bereichen Evidenz zur Risikominderung, Erzeugung gekennzeichneter Daten und Betriebskostenmanagement in Gesundheitsbereitstellungen.
-
IJISAE — Human-in-the-Loop-UI-Design Forschung zu kognitiver Last, semantischer Treue und Vertrauenssignalen in Prüfoberflächen für generative KI-Ko-Kreation.
Ridiculous Engineering baut HITL-Systeme, die in der Produktion funktionieren
Die meisten Teams, die zu uns kommen, haben bereits versucht, menschliche Überprüfung an eine bestehende Pipeline anzubauen, und festgestellt, dass es nicht skaliert. Die Warteschlange füllt sich, die Richtlinien sind vage, das Feedback erreicht das Modell nie, und das Ganze wird zu einem manuellen Prozess mit einem KI-Logo darauf.
Ridiculous Engineering entwirft kundenspezifische KI-gestützte Software, bei der die menschliche Aufsichtsebene eine entwickelte Komponente ist, kein nachträglicher Einfall. Das bedeutet eine Prüf-UI, die für die tatsächliche kognitive Last des Prüfers gebaut ist, Routing-Logik, die Warteschlangen frei hält, Audit-Protokollierung, die Compliance-Anforderungen erfüllt, und eine Feedback-Pipeline, die das Modell im Laufe der Zeit messbar verbessert. Wir arbeiten mit Produkt- und Engineering-Teams bei Startups, Unternehmen und Regierungsorganisationen in ganz Colorado und weltweit. Wenn Sie bereit sind, ein HITL-System zu bauen, das unter Produktionslast standhält, starten Sie ein Gespräch mit unserem Team.
Quellen
FAQ
Was ist die Human-in-the-Loop-Theorie?
Die Theorie des Menschen-im-Kreisprozesses besagt, dass KI-Systeme zuverlässiger und sicherer arbeiten, wenn Menschen die Autorität über Entscheidungen behalten, die das Modell nicht mit ausreichender Sicherheit treffen kann. Stanford HAI formuliert dies als „Menschen haben das Sagen“ statt nur „Menschen sind anwesend“.
Was bedeutet es, den Menschen im Kreis zu halten?
Den Menschen im Kreis zu halten bedeutet, bestimmte Entscheidungen vor der Systemaktion an einen menschlichen Prüfer weiterzuleiten, anstatt das Modell autonom entscheiden zu lassen. In der Praxis umfasst dies Konfidenzschwellen, Prüfwarteschlangen und dokumentierte Entscheidungsprotokolle, damit jede menschliche Aktion nachvollziehbar ist.
Was ist das Problem des Menschen-im-Kreis-Prozesses?
Die zentrale Herausforderung ist operativer Natur: Das Hinzufügen menschlicher Prüfung führt zu Latenz, Personalkosten und Inkonsistenz, wenn Richtlinien unklar sind. Systematische Überblicksforschung identifiziert Skalierbarkeit, Vertrauenskalibrierung und Governance als primäre Bereitstellungsherausforderungen, die Teams lösen müssen.
Was bedeutet „Mensch außerhalb des Kreises“?
Mensch-außerhalb-des-Kreises (HOOTL) beschreibt ein vollautomatisiertes System, bei dem kein Mensch an einzelnen Entscheidungen beteiligt ist. Es maximiert den Durchsatz und minimiert Kosten, entfernt jedoch das Sicherheitsnetz und die Prüfpfad, die regulierte oder risikoreiche Anwendungen benötigen.